一、HBase 是干什么的
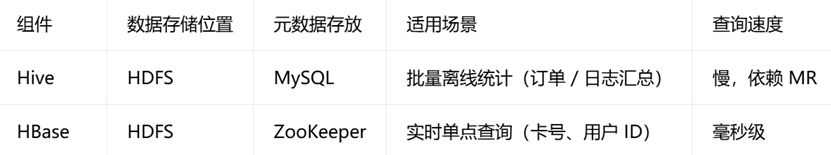
1. 先对比 Hive,区分两者定位
Hive:离线大数据仓库,存日志、订单批量数据,只能做批量统计查询,不能实时根据某一条 ID 快速查数据;
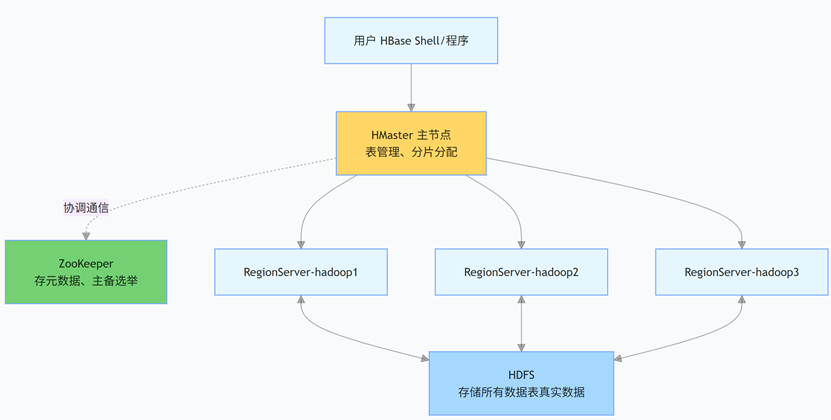
HBase:分布式实时 NoSQL 数据库,底层依然跑 HDFS 存数据,依赖 ZooKeeper 做集群协调 / 主节点选举,主打单行毫秒级实时读写。
例子:
整个校园百万学生的一卡通数据:
- Hive:每月导出全部消费日志,统计全校人均消费、食堂营收(批量离线分析)
- HBase:学生刷完卡立刻写入,输入学号就能1 毫秒查出该学生全部刷卡记录(实时单点查询)
2. HBase 三大核心作用
海量存储:底层依托 HDFS,存十亿、百亿条数据无压力;
实时读写:按主键单行极速查、改、删,适合实时业务;
分布式高可用:依赖 ZK 自动切换 HMaster 主节点,主节点宕机集群不瘫痪。
二、案例演示
示例表设计:card_info 一卡通消费表
行键 rowkey:学号(001/002...,唯一主键,快速检索)
列族 1:base 基础信息(姓名、班级)
列族 2:pay 消费记录(消费窗口、金额、时间)
步骤 1:三台全部启动 HBase
hadoop1执行主启动命令,一键全集群启动
bash
start-hbase.sh三台分别用jps验证进程
bash
jpshadoop1:多出 HMaster + HRegionServer
hadoop2/hadoop3:只有 HRegionServer
底层原理(关联 ZK)
HBase 启动时自动连接 ZK,注册 HMaster 为主控制器,所有 RegionServer 向 ZK 上报心跳。ZooKeeper 负责 HBase 主节点选举,这也是安装 HBase 前必须装好 ZK 的根本原因。
步骤 2:进入 HBase Shell 交互控制台
bash
hbase shell步骤 3:建表
创建一卡通表,两个列族base、pay
bash
create 'card_info','base','pay'向 ZK 写入这条表的元数据:表名、列族、分片规则;
HMaster 分配数据分片(Region)给三台 RegionServer;
HDFS 自动创建专属存储目录 /hbase/data/default/card_info,未来所有数据存在这里。
步骤 4:插入多条测试数据
bash
# 学号001,基础信息

put 'card_info','001','base:name','John'

put 'card_info','001','base:class','2301'

# 001消费记录

put 'card_info','001','pay:shop','water'

put 'card_info','001','pay:money','6'

put 'card_info','001','pay:time','12:18'


# 学号002数据

put 'card_info','002','base:name','Marry'

put 'card_info','002','pay:money','15'
|-------------|---------------|------------|------------|
| Row Key | Timestamp | Column Family ||
| Row Key | Timestamp | base | pay |
| 001 | t5 | | time=12:18 |
| 001 | t4 | | money=6 |
| 001 | t3 | | shop=water |
| 001 | t2 | Class=2301 | |
| 001 | t1 | name=John | |
| 002 | t6 | | money=15 |
| 002 | t5 | name=Marry | |
put 语法格式
put '表名','行键rowkey','列族:列名','值'
底层存储逻辑
数据不会存在 HBase 软件本身,直接持久化到 HDFS 分布式块中,ZK 只记录表结构、分片位置。
步骤 5:实时单行查
bash
# 只查学号001全部信息,毫秒返回

get 'card_info','001'
对比:
如果用 Hive 查:百万条日志全扫描,跑 MapReduce,几十秒出结果;
HBase:按学号 rowkey 精准定位分片,毫秒拿到数据,实时业务必备。
步骤 6:全表扫描
bash
# 查看所有表

list

# 打印card_info全表数据

scan 'card_info'
步骤 7:删除单条消费记录、删除整行、删除表
bash
# 删除001的消费金额字段

delete 'card_info','001','pay:money'

# 删除学号002整行所有数据

deleteall 'card_info','002'

# 禁用表后才能删除

disable 'card_info'

drop 'card_info'
步骤 8:去 HDFS 看真实数据
bash
hdfs dfs -ls /hbase/data/default/现象:能看到card_info文件夹,表真实数据全部在 HDFS,HBase 只是读写中间件,和 Hive 逻辑统一。
三、区分 Hive & HBase