多 Agent 交接如何防串稿:一套内容哈希与回执协议
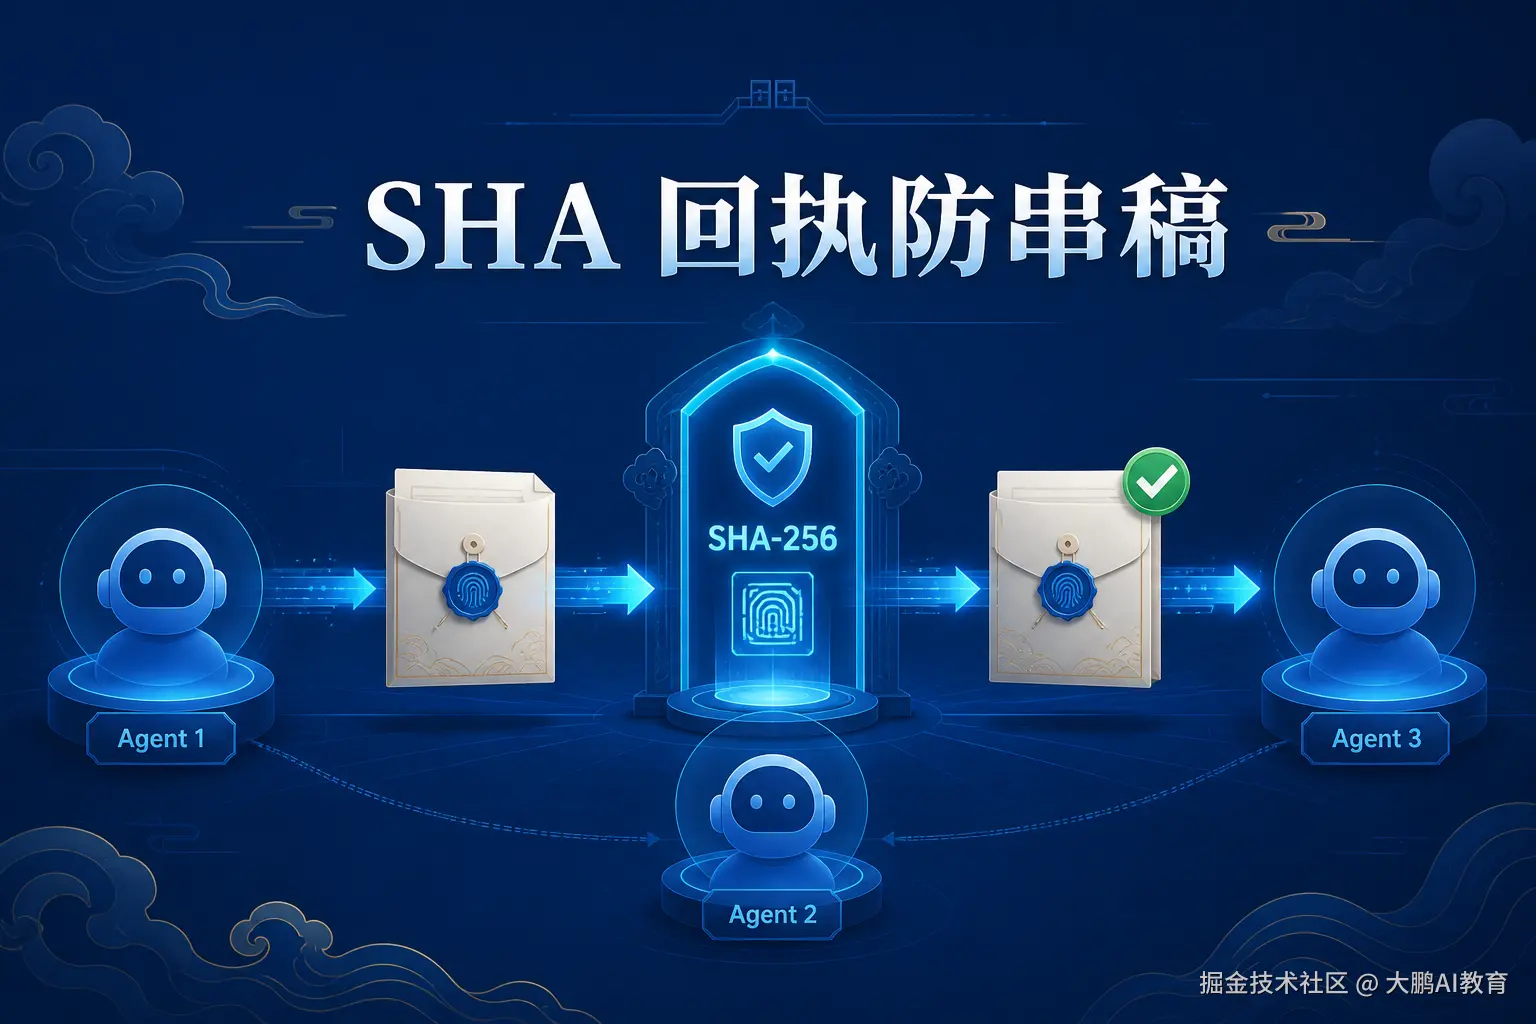
多 Agent 协作有一个很现实的冲突:直接传文件路径最快,但路径只能告诉下一个 Agent 去哪里读,不能证明那里还是刚才那份内容。把正文塞进任务消息能固定版本,却会扩大数据暴露面,还让队列和日志复制大量内容。
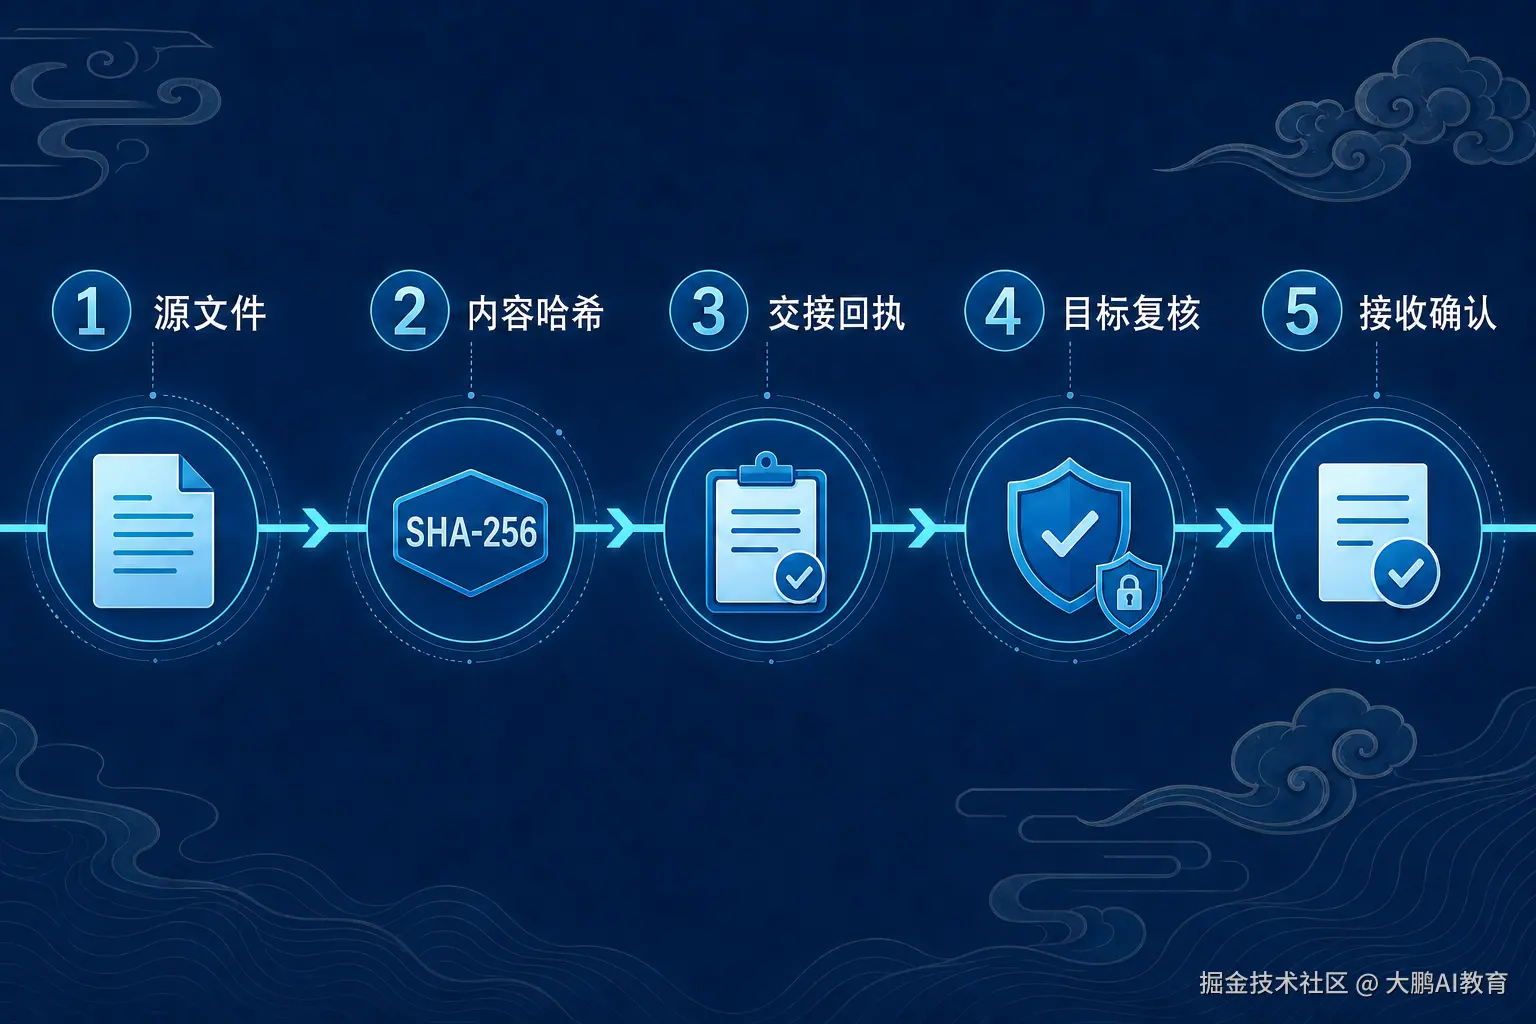
我的取舍是:正文留在所属项目,交接只传内容身份、revision、SHA-256 和无正文回执。 目标项目接收后再生成自己的回执,共享调度器恢复时现场复核,而不是相信上一次的"成功"总结。
工程场景与决策冲突
典型链路是:创作 Agent 生成 Markdown,平台 Agent 导入本地工作区,浏览器 Agent 保存草稿,调度 Agent 记录结果。
如果各环节只共享 work/article.md,很快会遇到:
- 同名路径被另一个任务覆盖;
- revision 已更新,消费端还持有旧决定;
- 图片变化,但正文路径没变;
- 外部写入超时,重试后产生重复副作用。
路径存在、修改时间更新、命令退出码为 0,都不足以独立证明一次跨项目交接完成。
方案拆解与关键权衡
最小交接对象包含四层身份:
json
{
  "packageId": "2026-08-agent-handoff-receipts",
  "packageRevision": 3,
  "contentId": "agent-handoff-receipts",
  "sourceRef": "drafts/juejin.md",
  "sourceSha256": "...",
  "assetCount": 0,
  "publicationAuthorized": false
}
这里故意不存正文,也不存工作站绝对路径。
权衡很清楚:
- 只传路径最省事,但无法识别内容漂移;
- 传全文最直接,但放大敏感数据和消息体;
- 路径 + SHA 能固定字节,revision 能阻止旧决策覆盖;
- 目标回执再证明"目标项目实际接收了什么"。
publicationAuthorized=false 把接稿和发布分开。一个 Agent 能写入项目,不代表它能公开发布。
实现链路与最小示例
先对原始字节计算 SHA:
python
from hashlib import sha256
from pathlib import Path


def file_sha256(path: Path) -> str:
    digest = sha256()
    with path.open("rb") as stream:
        for chunk in iter(lambda: stream.read(1024 * 1024), b""):
            digest.update(chunk)
    return digest.hexdigest()
不要先解码文本再编码,否则换行和 BOM 归一化可能改变验证语义。
消费前做双重锁定:
python
def verify_source(receipt: dict, expected_revision: int, source: Path) -> None:
    if receipt["packageRevision"] != expected_revision:
        raise RuntimeError("stale revision")
    if file_sha256(source) != receipt["sourceSha256"]:
        raise RuntimeError("source drifted")
目标项目写入后,再导出无正文接稿回执:
json
{
  "state": "accepted",
  "platform": "juejin",
  "packageId": "2026-08-agent-handoff-receipts",
  "packageRevision": 3,
  "sourceSha256": "...",
  "assets": [],
  "bodyStored": false
}
调度器只登记回执的仓库相对路径和回执 SHA。恢复时重新计算目标正文、图片和回执哈希。
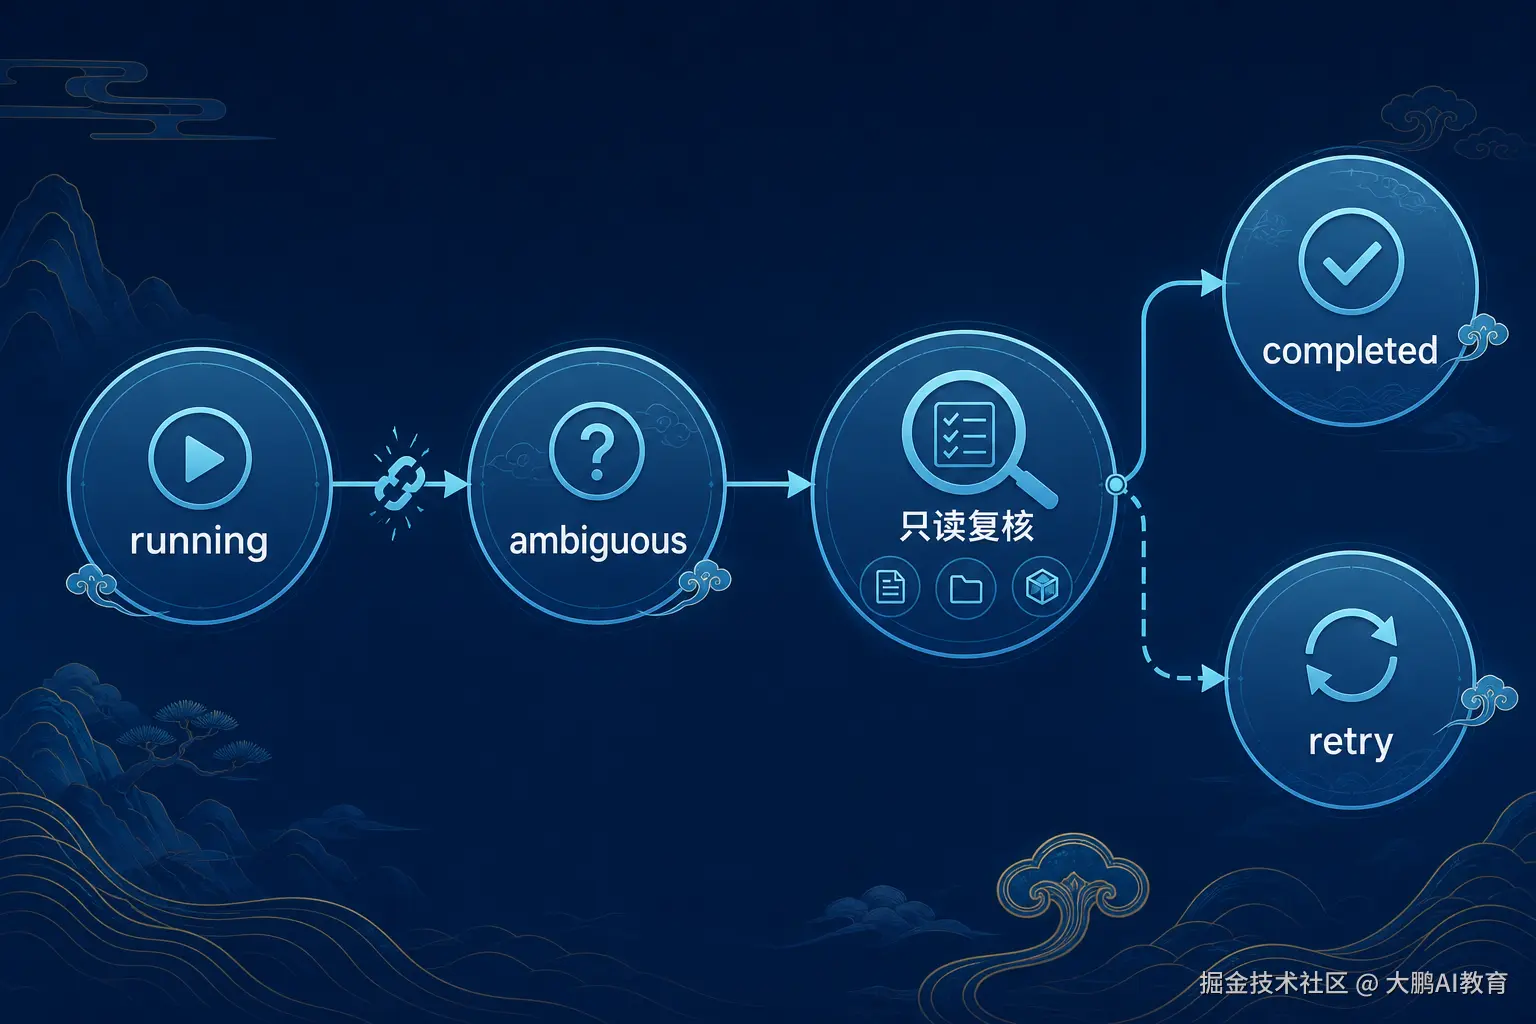
副作用步骤则使用显式状态:
text
intake -> receipt -> record -> completed进程重启后发现外部命令仍是 running,先转为 ambiguous,只读检查平台和目标项目事实。确认已经完成就补记;确认没有完成才执行恢复。不要把"我没收到响应"推导成"对方没写入"。
证据、限制与自动化边界
RuyiBookCourse 的长任务 Harness 章节提出,检查点应保存已确认输入、输出、证据路径和校验值;文件变化后,旧证据不能继续证明新文件。这一原则比"多写日志"更关键。
实现中还要注意:
- 哈希证明字节一致,不证明内容正确;正确性仍需来源、测试和人工判断;
- SHA-256 不负责保密,敏感正文仍不能放进公开回执;
- 相同哈希可以支持幂等复用,路径相同但哈希不同必须拒绝覆盖;
- 接稿、平台草稿、审批、公开发布应是不同状态;
- 对未知写入只允许事实回读,禁止无脑重放。
可复用检查清单
- packageId、revision、contentId 同时绑定
- 正文与素材按原始字节计算 SHA-256
- 持久化记录只保存仓库相对引用
- 目标项目导出独立无正文回执
- 恢复时现场复核正文、素材和回执
-
running遗留转换为ambiguous - 接稿成功不继承公开发布权限
- 正文或图片漂移后旧回执立即失效
收束
多 Agent 协作的交接层,本质上不是"共享目录",而是一份可验证协议:谁交付、哪一版、哪些字节、目标接收了什么、未知副作用如何恢复。
你在多 Agent 或 CI 流水线里更倾向传路径、传全文,还是传内容寻址对象?欢迎分享实际取舍和踩坑。
发布前门禁
- 减少重复背景
- 突出工程选择而非概念堆砌
- 不给未经验证的数据结论
- 本轮无已认领实验,不自行补写实验结论