此篇文章是"跨数据库通用"字段级"数据血缘解析与图形化"说明的第2部分。
上一步,得到了"初级血缘标注信息"。
这一步,将会得到完整的字段级血缘数据,保存到MYSQL数据库的3张表中。
这3张表的名称以及作用为:
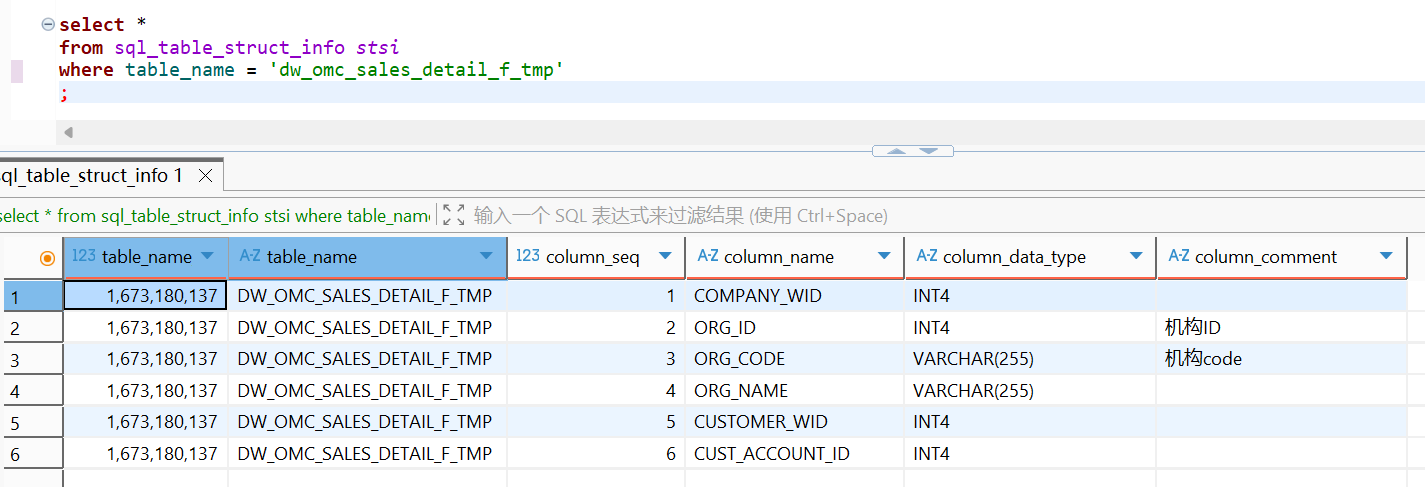
1、 sql_table_struct_info : 保存表、视图、函数(可能)的表结构信息
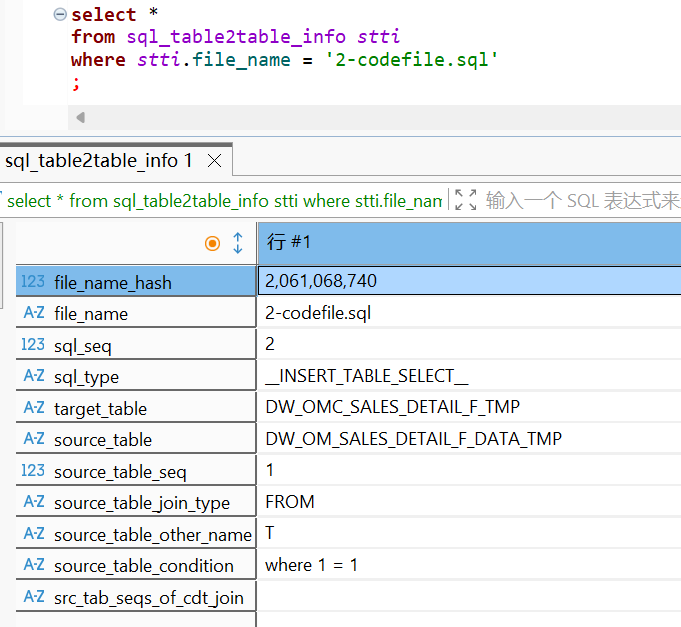
2、 sql_table2table_info : 保存脚本中表与表之间的关系,比如目标表、源表、表别名、表关联方式、关联筛选条件等信息
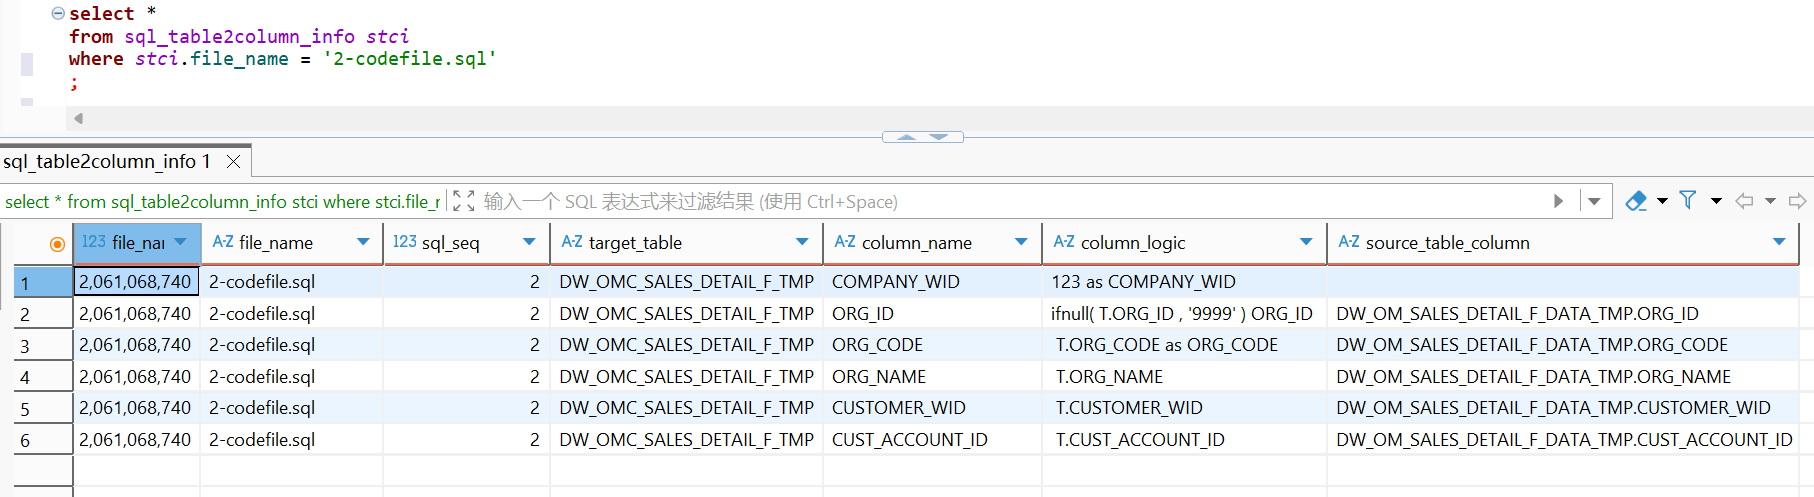
3、 sql_table2column_info : 保存脚本中每一个字段的逻辑代码,以及逻辑代码涉及到的源字段信息,即字段级血缘信息
以上3张表,需要事先创建好,建表语句如下:
sql
drop table sql_table_struct_info
;
create table sql_table_struct_info
(
  table_name_hash     bigint       COMMENT '表名生成的哈希值'
, table_name          varchar(200) COMMENT '表名'
, column_seq          int          COMMENT '字段顺序'
, column_name         varchar(200) COMMENT '表字段名'
, column_data_type    varchar(200) COMMENT '表字段类型'
, column_comment      varchar(200) COMMENT '表字段注释'
)
DEFAULT CHARSET=utf8
partition by hash(table_name_hash)
partitions 197
;


drop table sql_table2table_info
;
create table sql_table2table_info
(
  file_name_hash            bigint         COMMENT 'SQL文件名生成的哈希值'
, file_name                 varchar(200)   COMMENT 'SQL文件名'
, sql_seq                   int            COMMENT 'SQL语句顺序'
, sql_type                  varchar(50)    COMMENT 'SQL类型'
, target_table              varchar(200)   COMMENT 'SQL语句目标表'
, source_table              varchar(200)   COMMENT 'SQL加工源表'
, source_table_seq          int            COMMENT 'SQL源表顺序'
, source_table_join_type    varchar(50)    COMMENT 'SQL加工源表关联方式'
, source_table_other_name   varchar(200)   COMMENT 'SQL加工源表别名'
, source_table_condition    varchar(10000) COMMENT 'SQL源表条件'
, src_tab_seqs_of_cdt_join  varchar(100)   COMMENT '关联条件的源表顺序'
)
DEFAULT CHARSET=utf8
partition by hash(file_name_hash)
partitions 197
;


drop table sql_table2column_info
;
create table sql_table2column_info
(
  file_name_hash          bigint         COMMENT 'SQL文件名生成的哈希值'
, file_name               varchar(200)   COMMENT 'SQL文件名'
, sql_seq                 int            COMMENT 'SQL语句顺序'
, target_table            varchar(200)   COMMENT 'SQL语句目标表'
, column_name             varchar(200)   COMMENT '目标表字段名'
, column_logic            varchar(10000) COMMENT '字段逻辑'
, source_table_column     varchar(4000)  COMMENT '字段逻辑涉及到的源表和字段'
)
DEFAULT CHARSET=utf8
partition by hash(file_name_hash)
partitions 197
;
数据库准备完毕之后,需要使用Python,对"初级血缘标注信息"做进一步处理,步骤大体可以分为:
1、 对代码进行去层级化,即将子查询、UNION查询等嵌套代码段,拆解出来,当成独立的代码段,并赋予其新的ID(如:SUB_SELECT_123)
2、 遍历每个独立代码段,提取类型、目标表、源表、源表关联方式、源表别名、关联筛选条件等表级信息
3、 再次遍历每个独立代码,对每个字段逻辑中的源字段进行处理,主要包括:(a)对具体字段确定其来源表;(b)对模糊字段(即星号*/T.*)进行展开
我们可以将上一步处理,合并到Python代码中一起调用执行,得到:col_lvl_data_lineage_reader.py,由于代码文件较大,可以查看gitee链接:
https://gitee.com/zgl-20053779/zglanguage/tree/master/project/字段级数据血缘解析与图形化
使用方式为:
bash
python col_lvl_data_lineage_reader.py your_etl_file.sql使用实例展示:
假设脚本文件为 2-codefile.sql,内容为:
sql
DROP TABLE IF EXISTS bi_dw.dw_omc_sales_detail_f_tmp
;
CREATE TABLE bi_dw.dw_omc_sales_detail_f_tmp
(
company_wid	int4,
org_id	    int4 COMMENT'机构ID',
org_code	varchar(255) COMMENT'机构code',
org_name	varchar(255),
customer_wid	int4,
cust_account_id	int4
)
distributed randomly
;

--ALTER TABLE bi_dw.dw_omc_sales_detail_f_tmp ADD PRIMARY KEY(invoice_number);
GRANT ALL PRIVILEGES ON bi_dw.dw_omc_sales_detail_f_tmp TO gkht_yibai;

set optimizer = off;
insert into bi_dw.dw_omc_sales_detail_f_tmp
(
company_wid,
org_id,
org_code,
org_name,
customer_wid,
cust_account_id
)
select
123 as company_wid,
ifnull(T.org_id, '9999') org_id,
T.org_code as org_code,
T.org_name,
T.customer_wid,
T.cust_account_id
FROM bi_dw.dw_om_sales_detail_f_data_tmp T
where 1=1
;

reset optimizer;
使用命令直接解析:
bash
python col_lvl_data_lineage_reader.py 2-codefile.sql > log.log
解析后,查询数据库结果:
1
2
3
##########################################
大型项目解析步骤与建议:
##########################################
1、 将解析内容分成几个类型:
(a)建表语句
(b)视图创建脚本
(C)存储过程脚本、 ETL脚本
2、 因为解析存在依赖关系,请按照 (a) -> (b) -> (c) 的顺序进行解析
3、 建表语句不存在血缘关系,可以放在同一个文件里一起解析,但考虑到建表语句加起来可能有几十万行,建议分多次解析,每次5万行左右
4、 视图创建脚本、存储过程脚本、ETL脚本,数量可能有成千上万个,可以使用Shell脚本,批量执行解析命令,每条解析命令耗时不会超过3秒。
但考虑到mysql的承载能力,执行每条解析命令之间,应该休眠零点几秒,让插入的血缘数据不会丢失。
5、 每解析一个脚本,应该将打印信息,重定向生成一个日志文件,方便后续统一排查
6、 根据经验,一个需要解析上万个脚本的项目,大约需要5到10人天即可完成
7、 当某些脚本代码后续发生变动时,只需对这些变动脚本重新解析一遍,即可实现血缘数据的自动更新覆盖,不需要消耗大量人力进行维护