论文原标题:MotionLLM: Understanding Human Behaviors from Human Motions and Videos
这是一篇被 2025年IEEE Transactions on Pattern Analysis and Machine Intelligence (TPAMI) 接收的正式期刊论文,属于多模态大语言模型(MLLM)应用于人体运动理解 的前沿工作。Project page: https://lhchen.top/MotionLLM
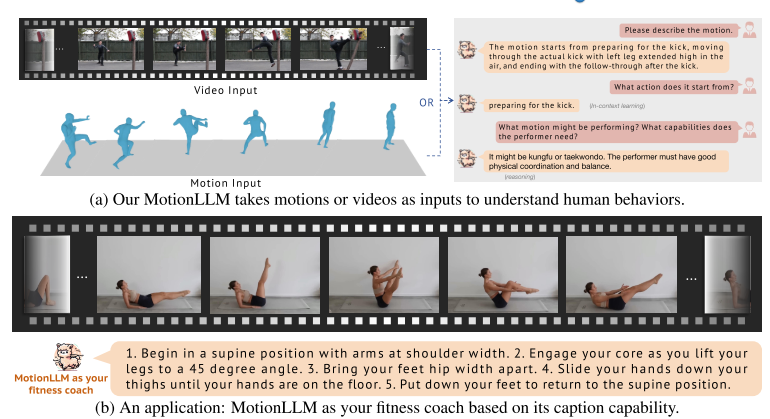
一、问题背景:
1. 两种模态的天然互补性
| 模态 | 优势 | 缺陷 |
|---|---|---|
| 视频(Video) | 富含环境上下文、人-物交互、场景语义------比如"打高尔夫"和"扫地"的骨架运动很相似,但视频场景完全不同 | 计算量大、隐私风险高、包含大量冗余信息 |
| 骨架(Motion) | 轻量、隐私友好、精确捕捉关节运动轨迹 | 缺乏环境上下文------只能看到"手臂在摆动",不知道是在"挥高尔夫球杆"还是"扫地" |
2. 现有方法的三大缺陷
| 缺陷 | 具体表现 | 后果 |
|---|---|---|
| ① 只处理单一模态 | MotionGPT只处理骨架,Video-LLaVA只处理视频 | 无法利用两种模态的互补优势 |
| ② 缺乏高质量的视频-骨架-文本配对数据 | 现有数据集要么只有视频-文本(如WebVid),要么只有骨架-文本(如HumanML3D),很少有同时包含三者的 | 无法训练统一的跨模态理解模型 |
| ③ 用共享投影器处理不同模态 | Video-LLaVA用同一个投影器处理图像和视频(模态差异小),但视频和骨架的模态差异巨大 | 共享投影器无法同时有效处理两种差异巨大的模态 |
本文提出MotionLLM,其核心主张 :用不同的投影器分别处理视频和骨架 (因为模态差异太大),然后用统一的LLM进行推理;同时构建包含视频-骨架-文本三元组的大规模数据集MoVid,让两种模态在训练中互相增强。
二、核心贡献(三个关键词)
| 贡献 | 核心内容 | 通俗解释 |
|---|---|---|
| ① MoVid数据集 | 包含24k视频-骨架-文本三元组(Motion-X重标注)+ 472k QA指令对(H3DQA + Motion-XQA) | 首次为"视频+骨架"联合理解提供大规模训练数据 |
| ② MotionLLM模型 | 用不同的V-L投影器分别处理视频和骨架(视频用MLP,骨架用线性层),统一送入LLM进行推理 | 给视频和骨架各配一个"翻译官",因为两种"语言"差异太大,不能用同一个翻译 |
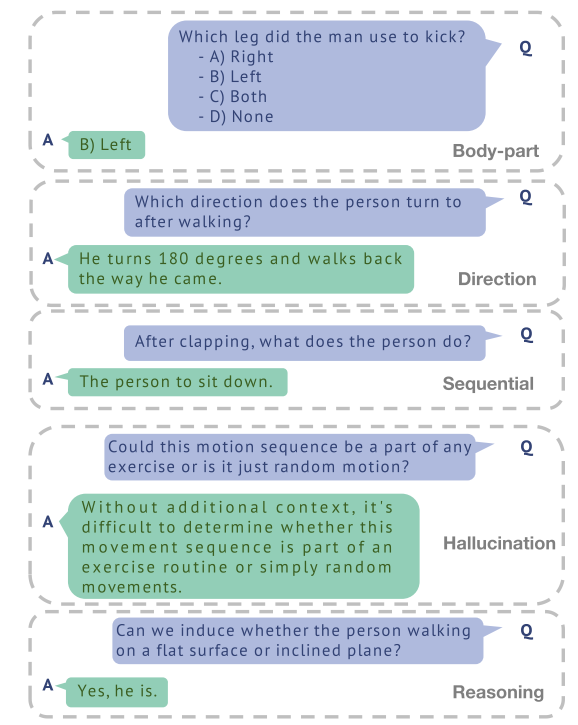
| ③ MoVid-Bench基准 | 人工标注的1,350个测试样本,覆盖5个维度:身体部位、时序、方向、推理、抗幻觉 | 首次为"视频+骨架"联合理解提供标准化评估基准 |
三、核心创新点详解:
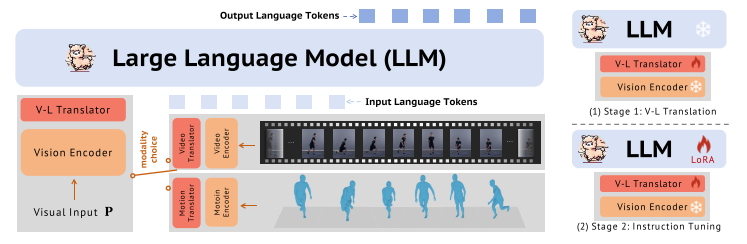
整体框架流程:两阶段训练 ,先分别训练视频和骨架的V-L投影器 (让两种模态都能被LLM理解),再联合指令微调 (让LLM学会同时利用两种模态的信息进行推理);推理时输入视频或骨架,输出动作描述、问答或推理结果。
创新点1:MoVid数据集的三大组成部分
| 子集 | 来源 | 规模 | 生成方式 | 用途 |
|---|---|---|---|---|
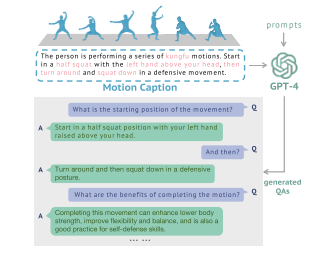
| H3DQA | HumanML3D骨架+文本 | 272k QA对 | GPT-4从骨架描述生成多轮QA | 骨架模态指令微调 |
| Motion-X Caption | Motion-X(视频+骨架配对) | 24k条 | GPT-4V从15×下采样视频帧重新标注 | 视频-骨架-文本三元组对齐 |
| Motion-XQA | Motion-X Caption基础上 | 200k QA对 | GPT-4从新标注生成多轮QA | 双模态联合指令微调 |
关键设计 :Motion-X Caption是视频-骨架-文本三元组------同一个动作既有视频,又有对应的骨架数据,还有GPT-4V生成的文本描述。这是实现"模态互补"的数据基础。
创新点2:分离的V-L投影器
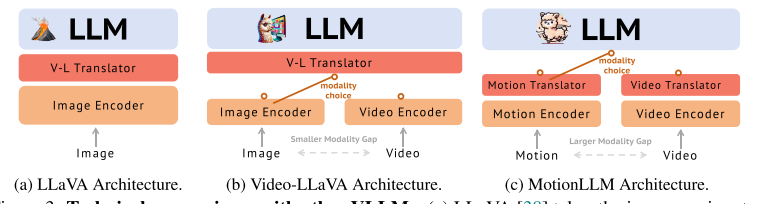
为什么不能用共享投影器?
| 模型 | 模态组合 | 模态差异 | 投影器设计 |
|---|---|---|---|
| LLaVA | 图像→文本 | 小 | 单一线性层 |
| Video-LLaVA | 图像+视频→文本 | 中 | 共享投影器 |
| MotionLLM | 视频+骨架→文本 | 大 | 分离投影器(视频用MLP,骨架用线性层) |
核心洞察:视频是像素级的稠密数据,骨架是坐标级的稀疏数据,两者的特征分布完全不同。用同一个投影器处理两种差异巨大的模态,会迫使投影器"妥协",导致两种模态都无法得到最优表示。
创新点3:两阶段渐进式训练
| 阶段 | 目标 | 可训练模块 | 数据 |
|---|---|---|---|
| Stage 1:模态翻译 | 让视频和骨架的投影器学会把各自的特征"翻译"成LLM能理解的Token | 仅投影器(视频MLP、骨架线性层) | 视频-文本对 + 骨架-文本对 |
| Stage 2:统一指令微调 | 让LLM学会利用两种模态进行推理 | 投影器 + LLM(LoRA) | 多轮QA数据(H3DQA + Motion-XQA) |
自回归文本生成
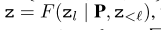
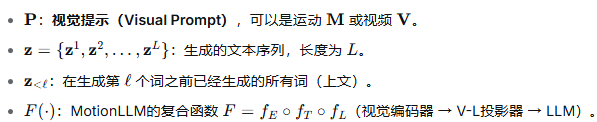
通俗例子:输入是"一个人在挥高尔夫球杆"的视频,模型要生成描述。它先看到视频,预测第一个词可能是"这个人";然后看到"这个人",预测下一个词可能是"正在";看到"这个人正在",预测下一个词可能是"挥动"......直到生成完整的"这个人正在挥动高尔夫球杆"。
四、比较的基准和数据集:
1. 骨架理解(MoVid-Bench-Motion,表4)
| 方法 | 整体准确率 | 说明 |
|---|---|---|
| GPT-3.5 | 31.33% | 纯文本,无法理解骨架 |
| MotionGPT | 36.86% | 仅骨架,训练数据有限 |
| MotionLLM | 49.50% | +12.64% |
2. BABEL-QA(表5)
| 方法 | 整体准确率 | 说明 |
|---|---|---|
| MotionCLIP-R | 42.0% | 专家模型,闭集分类 |
| MotionLLM(未微调) | 37.2% | 开放生成,未针对BABEL优化 |
| MotionLLM*(微调后) | 43.6% | 超越专家模型 |
3. 视频理解(MoVid-Bench-Video,表4)
| 方法 | 整体准确率 | 说明 |
|---|---|---|
| Video-LLaVA | 42.53% | 仅视频,无骨架辅助 |
| MotionLLM | 49.00% | +6.47% |
4. MVBench(表6)
| 方法 | 平均准确率 | 说明 |
|---|---|---|
| VideoChat | 30.1% | 视频理解基线 |
| Video-LLaVA | 26.3% | 视频理解基线 |
| MotionLLM | 31.6% | 新SOTA |
5. ActivityNet-QA(表7)
| 方法 | 准确率 | 说明 |
|---|---|---|
| Video-LLaVA | 45.3% | 视频理解SOTA |
| MotionLLM | 53.3% | +8.0% |
数据集
MoVid(训练数据)
| 子集 | 规模 | 模态 | 生成方式 |
|---|---|---|---|
| H3DQA | 272k QA对 | 骨架+文本 | GPT-4从HumanML3D生成 |
| Motion-X Caption | 24k条 | 视频+骨架+文本 | GPT-4V重新标注 |
| Motion-XQA | 200k QA对 | 视频+骨架+文本 | GPT-4从新标注生成 |
额外训练数据
| 数据 | 用途 |
|---|---|
| Valley(70.2万视频-文本对) | Stage 1视频投影器训练 |
| BABEL-QA(2k QA对) | 指令微调 |
| Video-ChatGPT(10万QA对) | 保留通用VQA能力 |
MoVid-Bench(评估基准)
| 类型 | 数量 | 覆盖维度 |
|---|---|---|
| 运动(Motion) | 700个 | Body, Seq, Dir, Rea, Hall |
| 视频(Video) | 650个 | Body, Seq, Dir, Rea, Hall |
五个评估维度:
-
Body(身体部位):是否准确描述具体身体部位的运动
-
Seq(时序):是否理解动作的先后顺序
-
Dir(方向):是否准确判断左右/前后方向
-
Rea(推理):是否能推断动作的意图或因果
-
Hall(抗幻觉):是否生成不存在的细节
总结:
MotionLLM通过分离的V-L投影器 和高质量的视频-骨架-文本三元组数据,让AI第一次实现了"既看视频又读骨架"的联合理解------视频提供环境上下文,骨架提供精确运动,两者互补,让动作理解更全面、更准确、更鲁棒。