注意:该项目只展示部分功能,如需了解,文末咨询即可。
本文目录
- [1 开发环境](#1 开发环境)
- [2 系统设计](#2 系统设计)
- [3 系统展示](#3 系统展示)
- [3.1 功能展示视频](#3.1 功能展示视频)
- [3.2 大屏页面](#3.2 大屏页面)
- [3.3 分析页面](#3.3 分析页面)
- [3.4 基础页面](#3.4 基础页面)
- [4 更多推荐](#4 更多推荐)
- [5 部分功能代码](#5 部分功能代码)
1 开发环境
发语言:python
采用技术:Spark、Hadoop、Django、Vue、Echarts等技术框架
数据库:MySQL
开发环境:PyCharm
2 系统设计
随着互联网金融的普及,股票、ETF、外汇、加密货币、期权、期货等交易品种门槛不断降低,零售交易者群体规模持续扩大,然而多数交易者缺乏专业训练与风控意识,亏损与爆仓现象普遍。传统分析手段难以从海量、多维的交易行为数据中提炼群体性规律,本系统依托 Hadoop 分布式文件系统与 Spark 内存计算框架,对零售交易者的风险偏好、交易纪律、行为倾向与盈亏生存状况进行大规模数据挖掘,为揭示交易者行为模式与生存状态提供技术支撑。
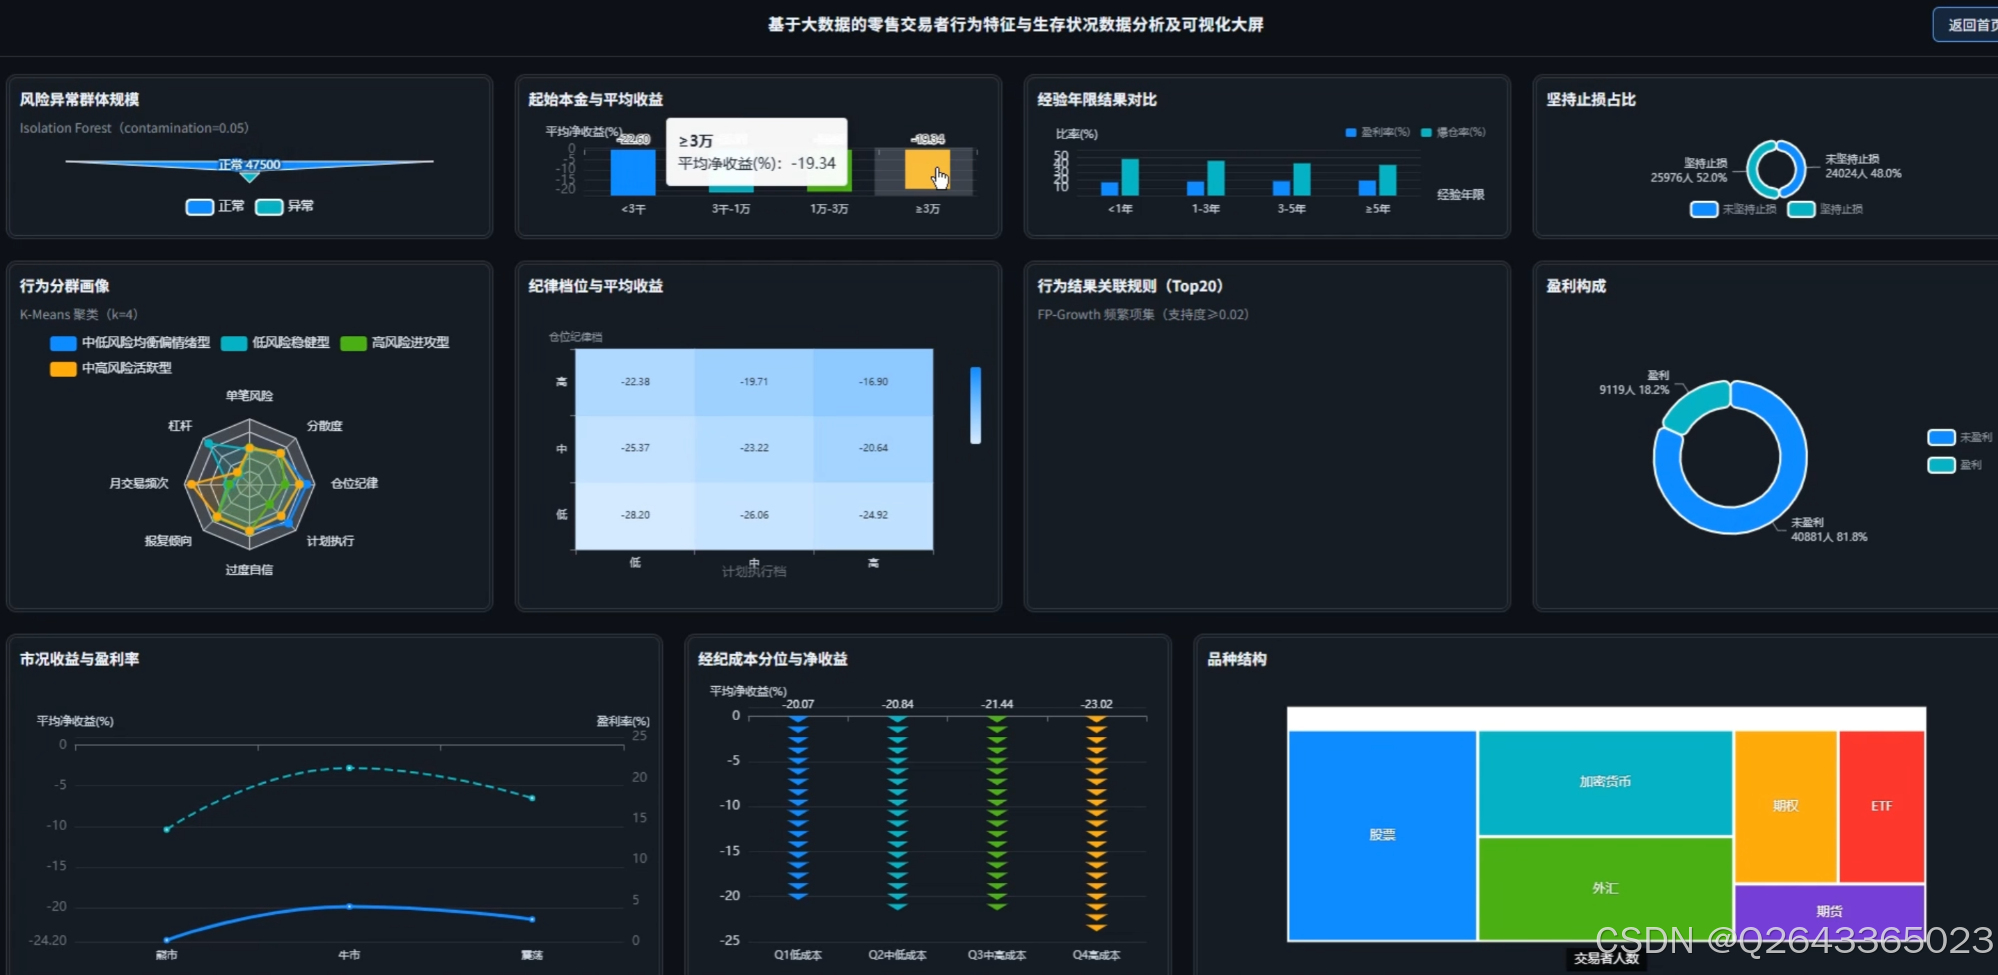
本研究围绕零售交易者"行为---结果"主线展开,以包含交易品种、市况、风险占比、杠杆、交易频率、报复交易、过度自信、计划执行、仓位纪律、净收益率、爆仓标记等多字段的数据集为对象,构建覆盖行为特征、模式挖掘、生存评估与影响因素的多层次分析体系。研究综合运用描述统计、分位数分箱、K-Means 聚类、Isolation Forest 异常检测、FP-Growth 关联规则等算法,在 Spark 分布式环境下完成全量计算,既刻画交易者的群体画像与风险分层,也挖掘行为组合与盈亏、爆仓结果之间的关联规律,为可视化展示与后续建模预测奠定基础。各分析要点如下:
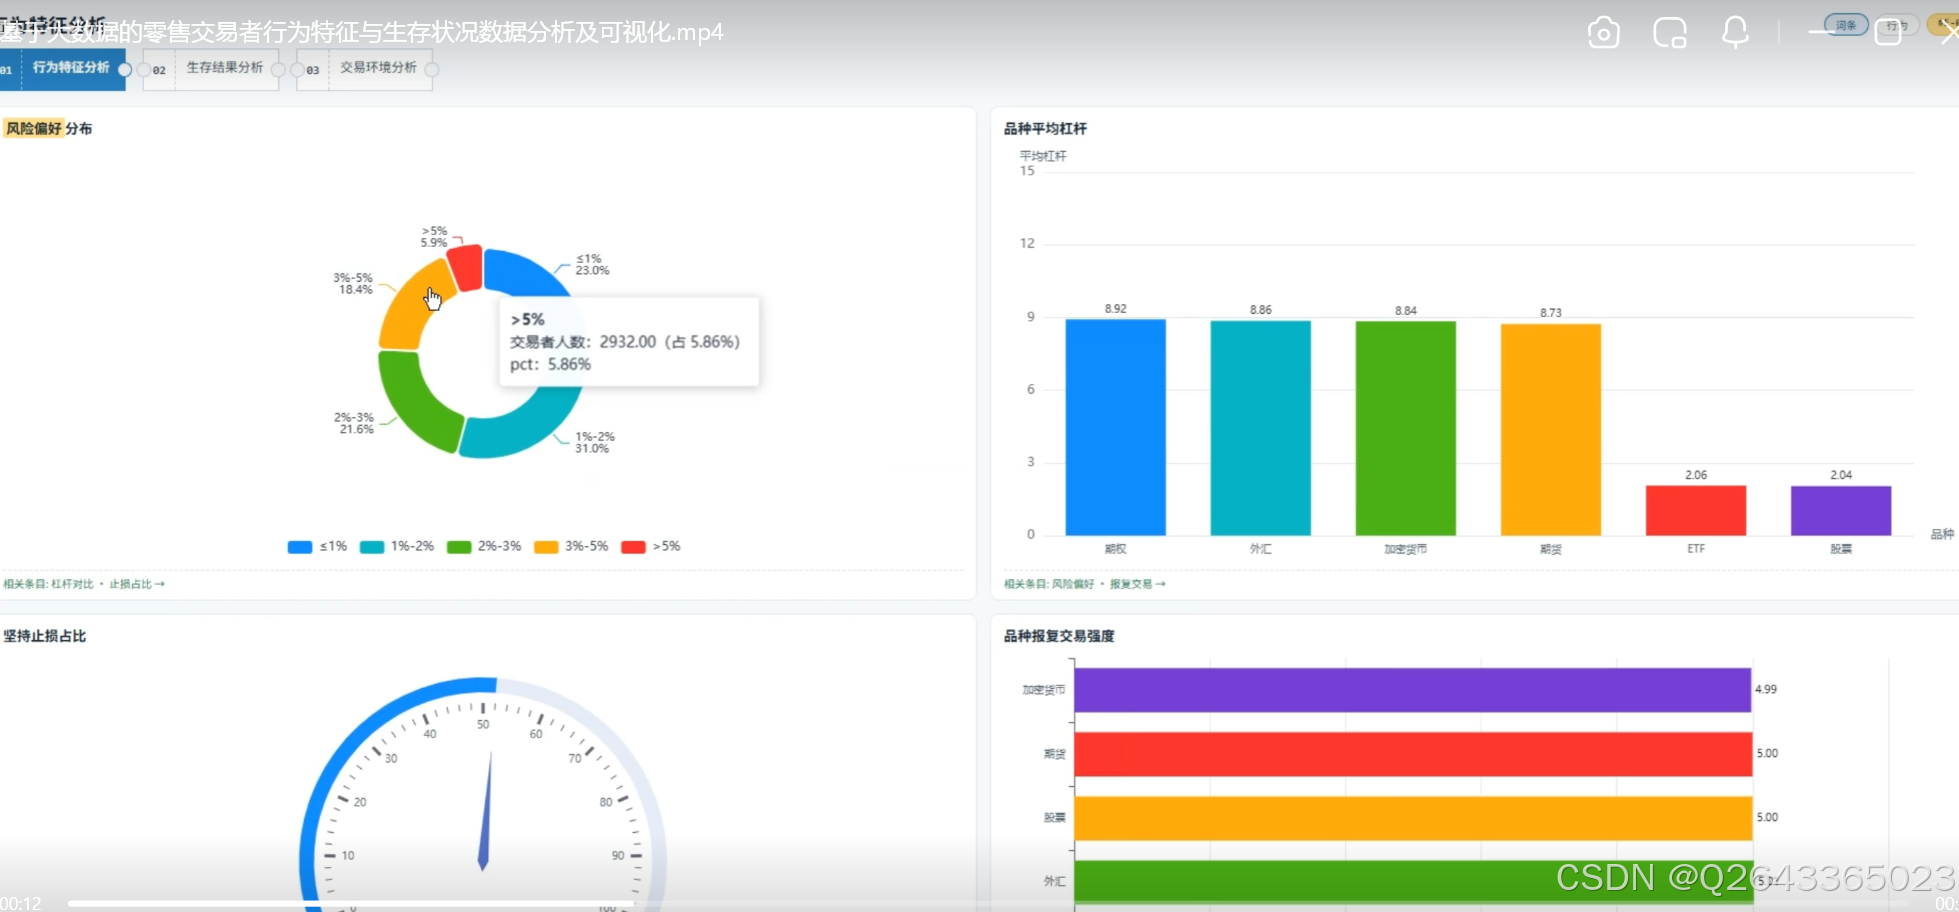
- 风险偏好分箱分布:将单笔风险占比按 ≤1%、1%-2%、2%-3%、3%-5%、>5% 分箱,统计各档交易者人数与占比,刻画群体风险偏好结构。
- 各品种杠杆对比:按交易品种分组计算平均杠杆与中位杠杆,对比不同市场参与者加杠杆水平的差异。
- 止损执行占比:统计坚持止损与未坚持止损人群的数量与占比,评估群体风控纪律的整体水平。
- 报复交易倾向分析:计算各交易品种报复交易倾向得分均值并排序,识别情绪化交易高发的品种。
- 盈亏持仓时长差异:对比平均盈利持仓天数与平均亏损持仓天数并求差值,验证处置效应在群体中的存在程度。
- 行为 K-Means 聚类分群:选取风险、杠杆、频率、报复、自信、纪律、分散化等 8 项特征标准化后聚为 4 类,按簇心风险排序贴标签,并输出轮廓系数评估聚类质量。
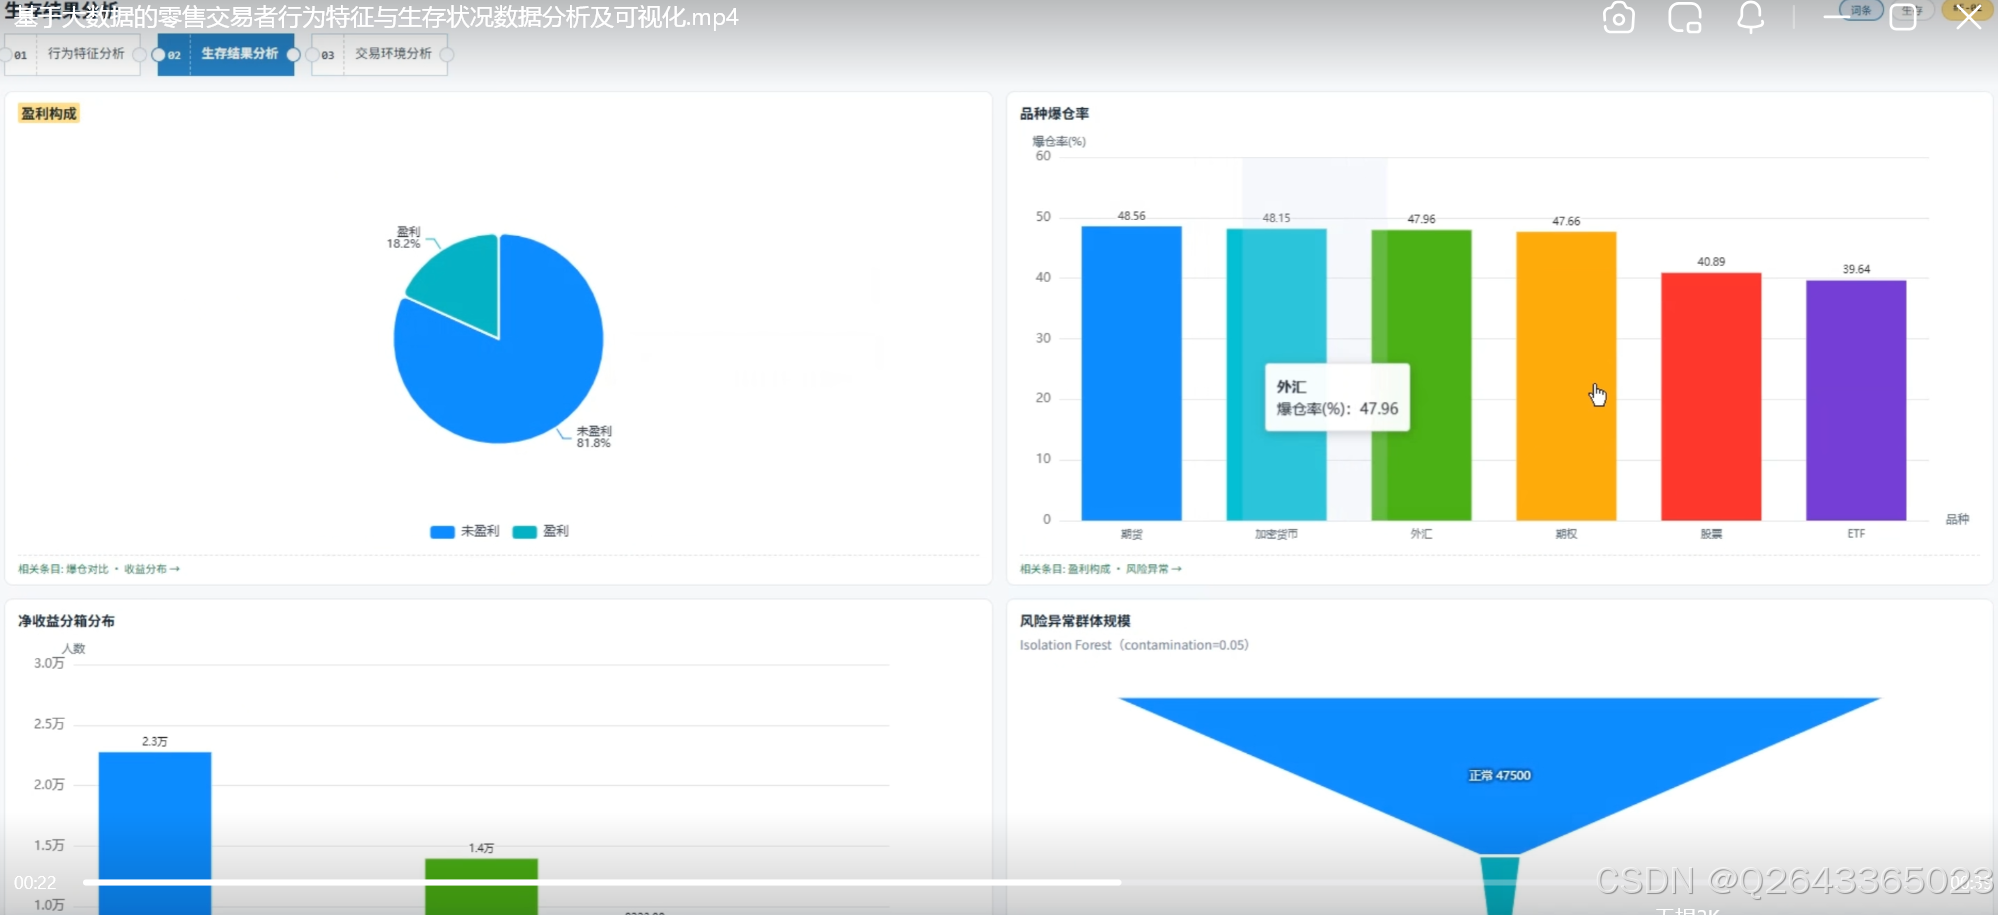
- 盈利构成分析:统计盈利与未盈利交易者数量及占比,给出群体整体生存率画像。
- 各品种爆仓率对比:按品种计算爆仓率并降序排列,揭示高爆仓风险的交易市场。
- 净收益率分箱分布:将净收益率按 ≤-40%、-40%-20%、-20%0%、0%~20%、>20% 分箱统计,呈现群体盈亏分布形态。
- Isolation Forest 异常群体识别:以风险、杠杆、频率、报复、自信、净收益构建联合特征空间,识别占比约 5% 的行为-结果异常群体并对比其特征均值。
- FP-Growth 行为关联规则:将止损、记录、杠杆、报复、纪律与盈利、爆仓标签组成事务,挖掘行为组合与结果之间的高置信度关联规则。
- 纪律与收益交叉分析:将仓位纪律与计划执行各分低/中/高三档,交叉统计各组合的平均净收益,量化纪律水平对盈利的影响。
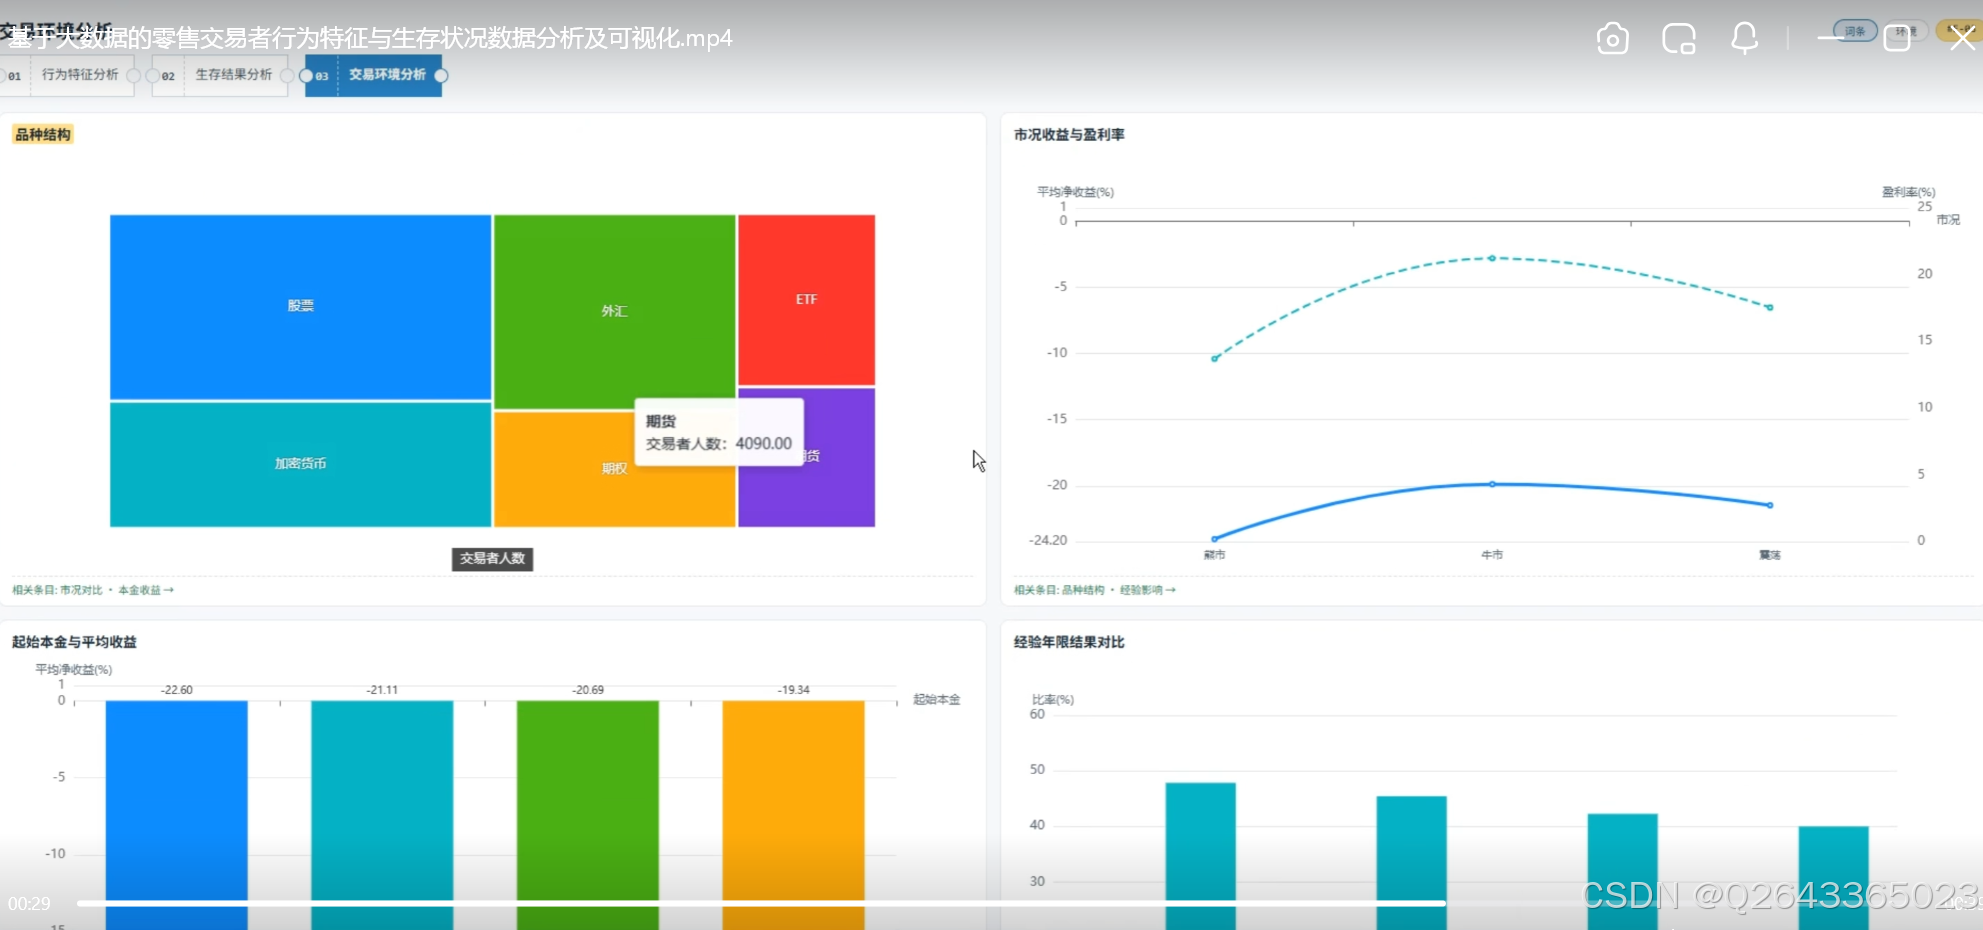
- 品种结构分析:统计各主交易品种的人数与占比,呈现样本群体的市场参与结构。
- 市况下收益对比:按牛市、震荡、熊市分组,对比平均收益、盈利率与爆仓率,考察市况对生存状况的影响。
- 起始本金分层分析:将本金分为 <3千、3千-1万、1万-3万、≥3万 四档,统计各档平均净收益,检验资金规模与收益的关联。
- 经验年限影响分析:按 <1年、1-3年、3-5年、≥5年 分层,统计各层盈利率、爆仓率与平均收益,评估经验的价值。
- 经纪成本侵蚀分析:按成本四分位分组,对比各组平均净收益与平均成本,揭示交易成本对收益的侵蚀效应。
3 系统展示
3.1 功能展示视频
!!!请点击这里查看功能演示!!!
3.2 大屏页面
3.3 分析页面
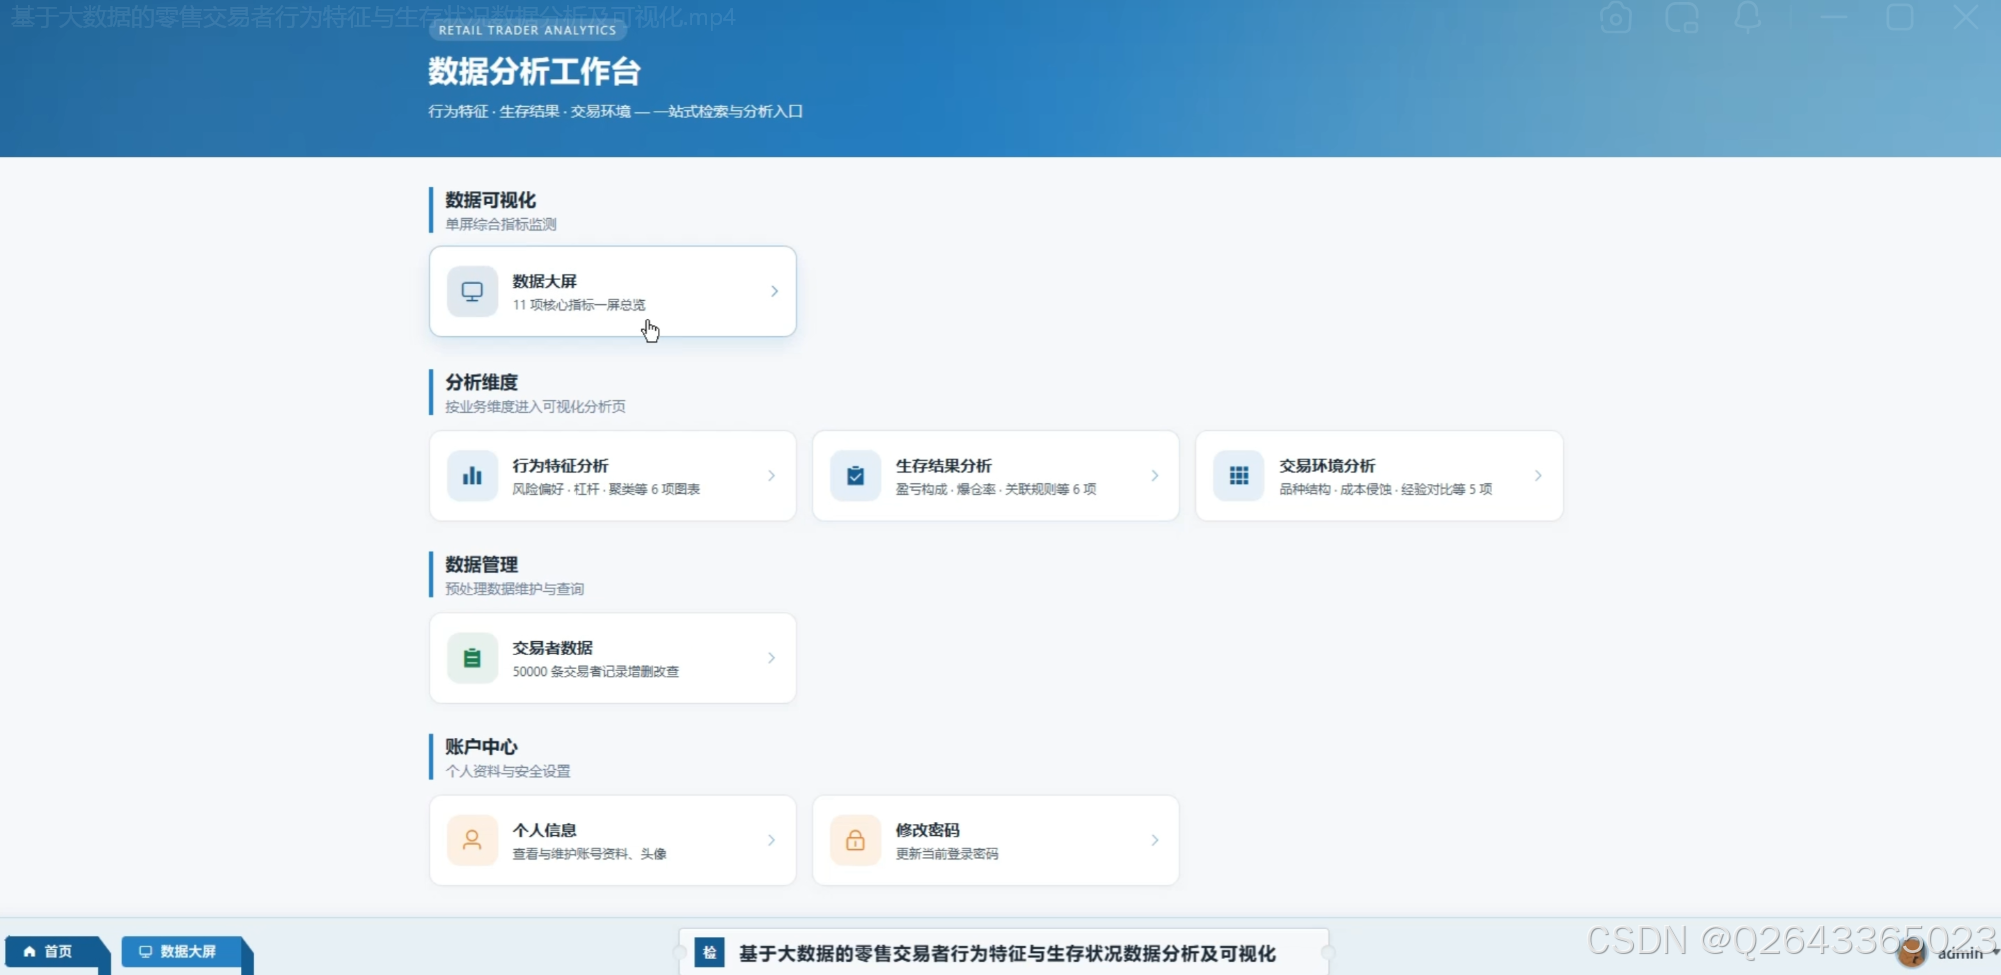
3.4 基础页面
4 更多推荐
计算机专业毕业设计新风向,2026年大数据 + AI前沿60个毕设选题全解析,涵盖Hadoop、Spark、机器学习、AI等类型
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
【避坑必看】26届计算机毕业设计选题雷区大全,这些毕设题目千万别选!选题雷区深度解析
紧跟风口!2026计算机毕设新赛道:精选三大热门领域下的创新选题, 拒绝平庸!毕设技术亮点+功能创新,双管齐下
纯分享!2026届计算机毕业设计选题全攻略(选题+技术栈+创新点+避坑),这80个题目覆盖所有方向,计算机毕设选题大全收藏
计算机专业毕业设计选题深度剖析,掌握这些技巧,让你的选题轻松通过,文章附35个优质选题助你顺利通过开题!
5 部分功能代码
python
def risk_preference_dist_analysis(input_df):
    """单笔风险占比分箱分布。"""
    total = float(input_df.count())
    binned = input_df.withColumn(
        'bin_label',
        when(col('risk_per_trade_pct') <= 1.0, lit('≤1%'))
        .when(col('risk_per_trade_pct') <= 2.0, lit('1%-2%'))
        .when(col('risk_per_trade_pct') <= 3.0, lit('2%-3%'))
        .when(col('risk_per_trade_pct') <= 5.0, lit('3%-5%'))
        .otherwise(lit('>5%')),
    )
    result = (
        binned.groupBy('bin_label')
        .agg(spark_count(lit(1)).alias('trader_count'))
        .withColumn('pct', spark_round(col('trader_count') / lit(total) * 100.0, 2))
        .orderBy(
            when(col('bin_label') == '≤1%', 1)
            .when(col('bin_label') == '1%-2%', 2)
            .when(col('bin_label') == '2%-3%', 3)
            .when(col('bin_label') == '3%-5%', 4)
            .otherwise(5)
        )
    )
    result = round_numeric_columns(result)
    local_path = export_csv(result, 'risk_preference_dist.csv')
    return result
def behavior_kmeans_clusters_analysis(input_df):
    """行为数值特征标准化后 K-Means(k=4),簇标签按簇心相对排序生成。"""
    feature_cols = [
        'risk_per_trade_pct', 'avg_leverage', 'trades_per_month',
        'revenge_trading', 'overconfidence', 'follows_plan',
        'position_sizing_discipline', 'diversification',
    ]
    for c in feature_cols:
        input_df = input_df.withColumn(c, col(c).cast('double'))

    assembler = VectorAssembler(inputCols=feature_cols, outputCol='raw_features', handleInvalid='skip')
    scaler = StandardScaler(inputCol='raw_features', outputCol='features', withMean=True, withStd=True)
    scaled = scaler.fit(assembler.transform(input_df)).transform(assembler.transform(input_df))

    model = KMeans(k=4, seed=42, featuresCol='features', predictionCol='cluster_id').fit(scaled)
    clustered = model.transform(scaled)

    silhouette = float(ClusteringEvaluator(
        predictionCol='cluster_id', featuresCol='features', metricName='silhouette'
    ).evaluate(clustered))

    means_pdf = clustered.groupBy('cluster_id').agg(
        spark_count(lit(1)).alias('member_count'),
        *[spark_round(spark_avg(c), 2).alias(f'avg_{c}') for c in feature_cols]
    ).toPandas()

    ranked = means_pdf.sort_values('avg_risk_per_trade_pct').reset_index(drop=True)
    rank_labels = ['低风险稳健型', '中低风险均衡型', '中高风险活跃型', '高风险进攻型']
    # 按簇心风险偏好排序贴标签,报复得分最高的簇附加情绪特征说明
    ...
    result = export_csv(result, 'behavior_kmeans_clusters.csv')
    return result
源码项目、定制开发、文档报告、PPT、代码答疑
希望和大家多多交流 ↓↓↓↓↓