💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询
💕💕Java项目
💕💕微信小程序项目
💕💕Android项目
💕💕Python项目
💕💕PHP项目
💕💕ASP.NET项目
💕💕Node.js项目
💕💕大数据项目
💕💕选题推荐
基于大数据的商家优惠券营销效果数据分析与可视化
文章目录
1、研究背景
随着移动互联网与电子商务的迅猛发展,各类商家在平台上投放优惠券已成为吸引客流与提升交易额的核心营销手段。大量商家在各类平台发放优惠券,导致市场竞争白热化。当前优惠券营销面临突出的痛点,发券策略往往缺乏精准的数据支撑,导致出现大量"有券未核销"现象,资源浪费严重。用户在领券、核销、消费距离、折扣偏好等方面产生的行为数据呈指数级增长,传统的数据库处理方式已经无法满足海量数据的计算与挖掘需求。如何从海量、多源、异构的营销数据中提取有价值的信息,构建精准的用户画像,评估券种关联规则与营销效果,成为商家亟待解决的难题。在此背景下,借助Python、Spark、Hadoop等大数据技术,结合机器学习算法,开发一套集数据管理、多维分析与可视化展示于一体的商家优惠券营销效果数据分析系统,能够有效应对海量数据挑战,为商家提供智能化的营销决策支持,实现从传统粗放式营销向数据驱动精准营销的转型。
2、研究目的和意义
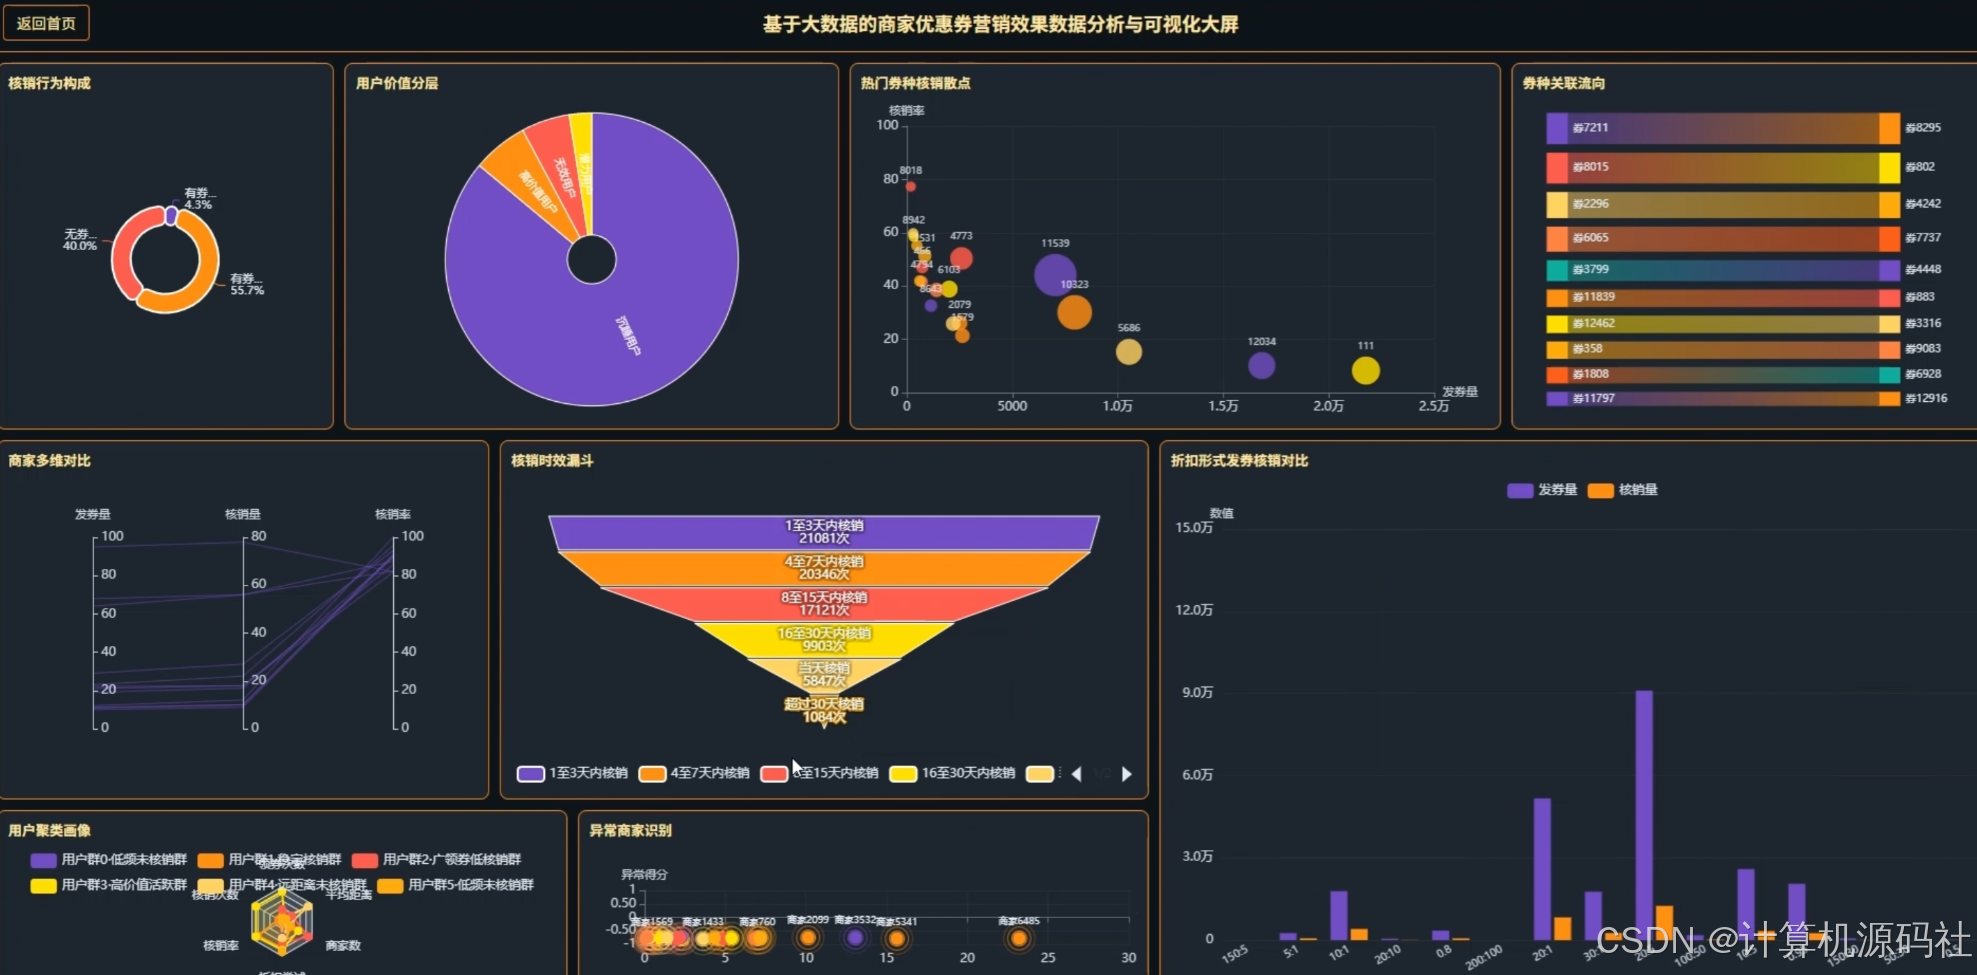
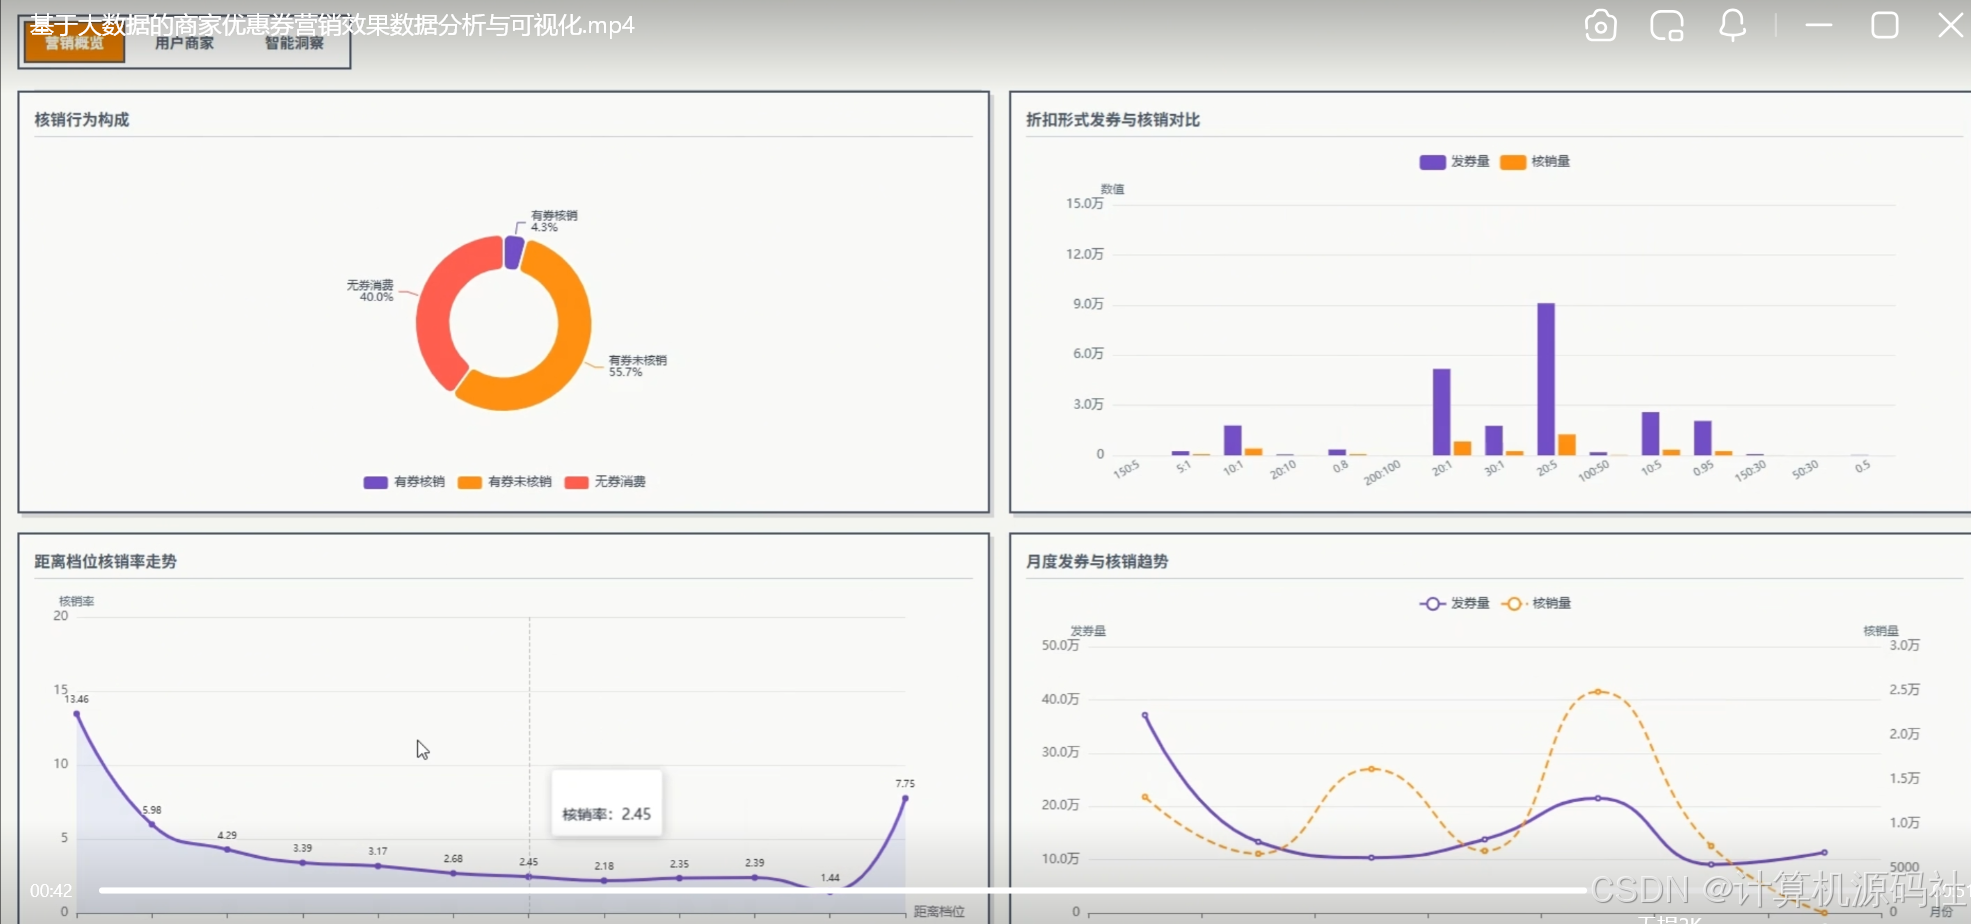
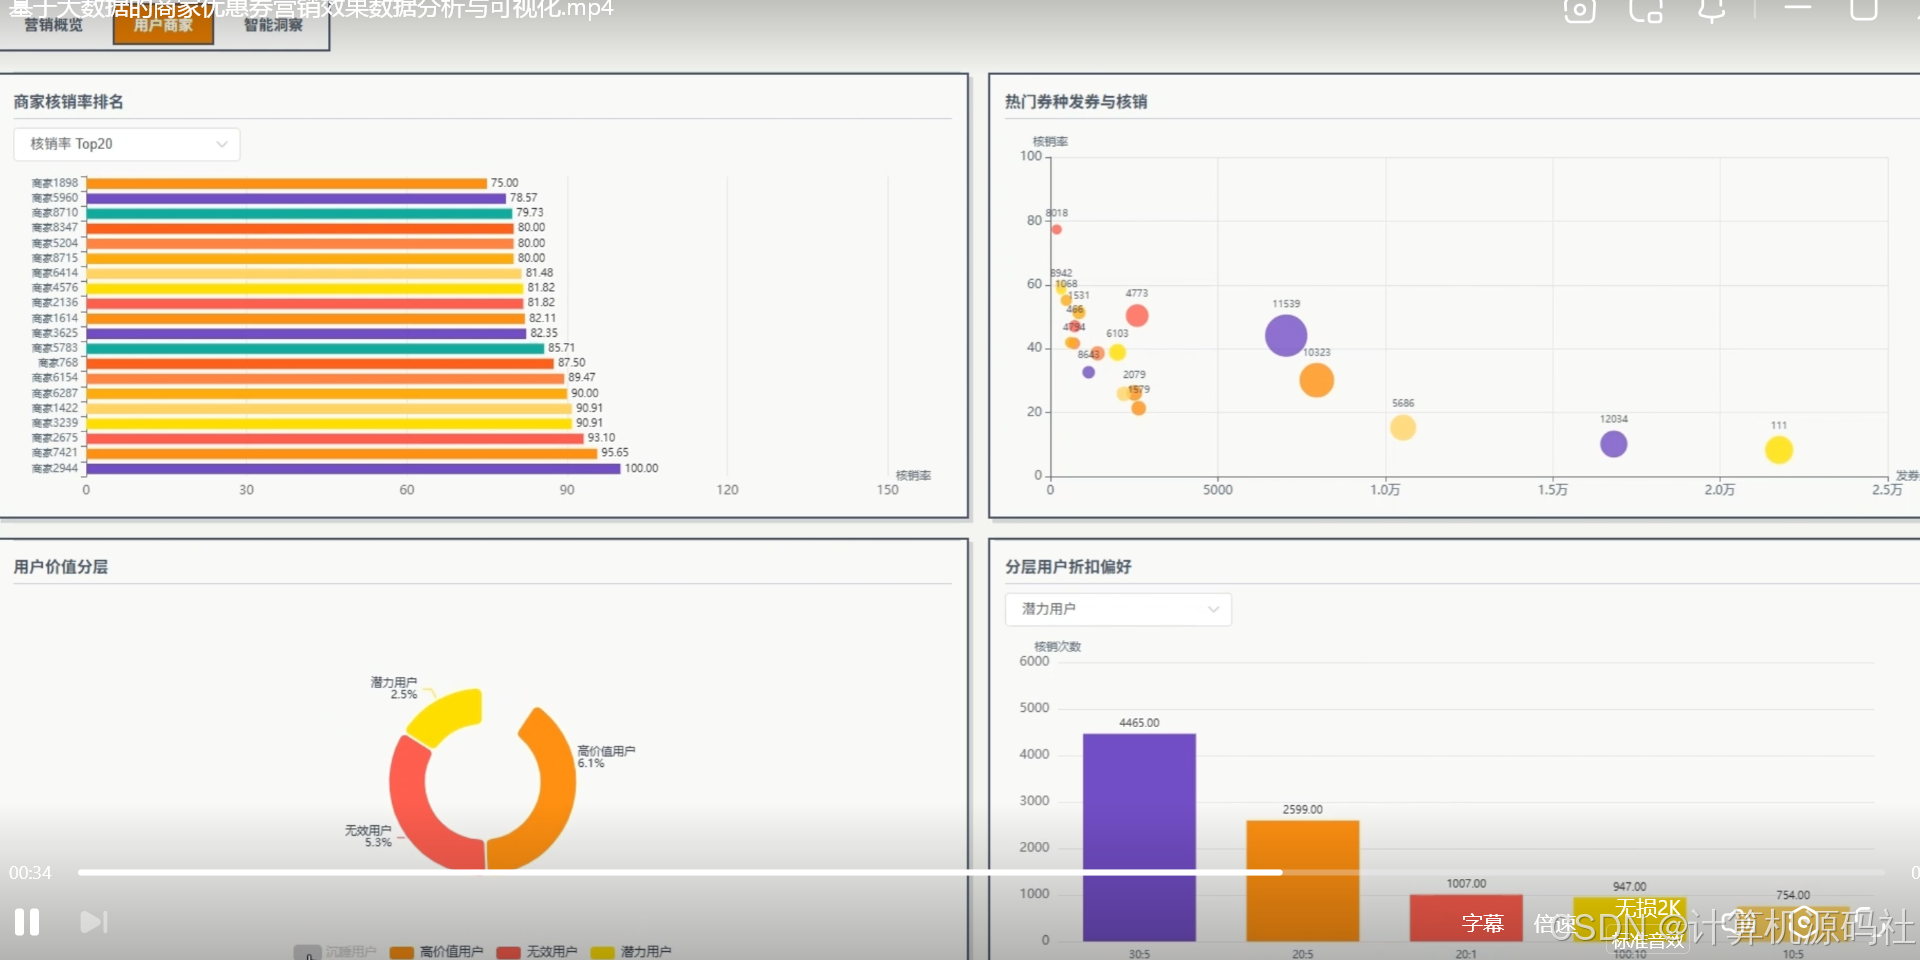
本系统的开发目的在于打破商家在优惠券营销过程中的数据孤岛,解决发券盲目、核销率低以及缺乏精准用户洞察等核心业务问题。通过整合MySQL中的海量业务数据,利用Hadoop与Spark强大的分布式计算能力进行数据清洗与特征工程,运用K-Means等机器学习算法对用户进行深度聚类,划分出低领未核销群、稳定核销群、高价值活跃群等不同价值分层。系统旨在通过Echarts与Vue构建的交互式可视化大屏,全面展示核销行为构成、热门券种核销散点、券种关联流向以及折扣形式发券核销对比等关键指标。借助核销时效漏斗与距离档位核销率走势分析,系统能够精准定位营销转化的薄弱环节。通过构建商家共现网络与异常商家识别模型,系统能够及时发现异常交易行为与潜在的商家关联风险。最终目的在于帮助商家精准掌握营销活动效果,优化折扣门槛与投放距离策略,实现千人千面的精准营销,从而有效提升优惠券核销率与整体投资回报率。
该系统的开发具有重要的实践应用价值与行业示范意义。在商业运营层面,系统通过数据挖掘与可视化技术,将复杂的用户行为数据转化为直观的业务图表,帮助商家管理者快速洞察营销漏斗的转化情况,科学评估不同折扣形式与满减门槛的营销效果,从而制定更为合理的优惠券发放策略,降低营销成本。在技术架构层面,系统融合了大数据生态中的Hadoop与Spark组件,结合Python数据分析生态与Vue前端框架,验证了大数据技术在精准营销场景下的落地可行性,为同类营销分析系统的开发提供了技术参考与架构范例。在智能决策层面,通过K-Means算法实现的用户聚类画像与异常商家识别功能,不仅能够帮助企业识别高价值用户群体,还能有效防范营销风险,保障平台与商家的资金安全。通过数据大屏与后台管理系统的有机结合,推动了传统经验型营销向数据驱动型营销的转变,为整个电商与本地生活服务行业的数字化转型提供了强有力的技术支撑与决策依据。
3、系统研究内容
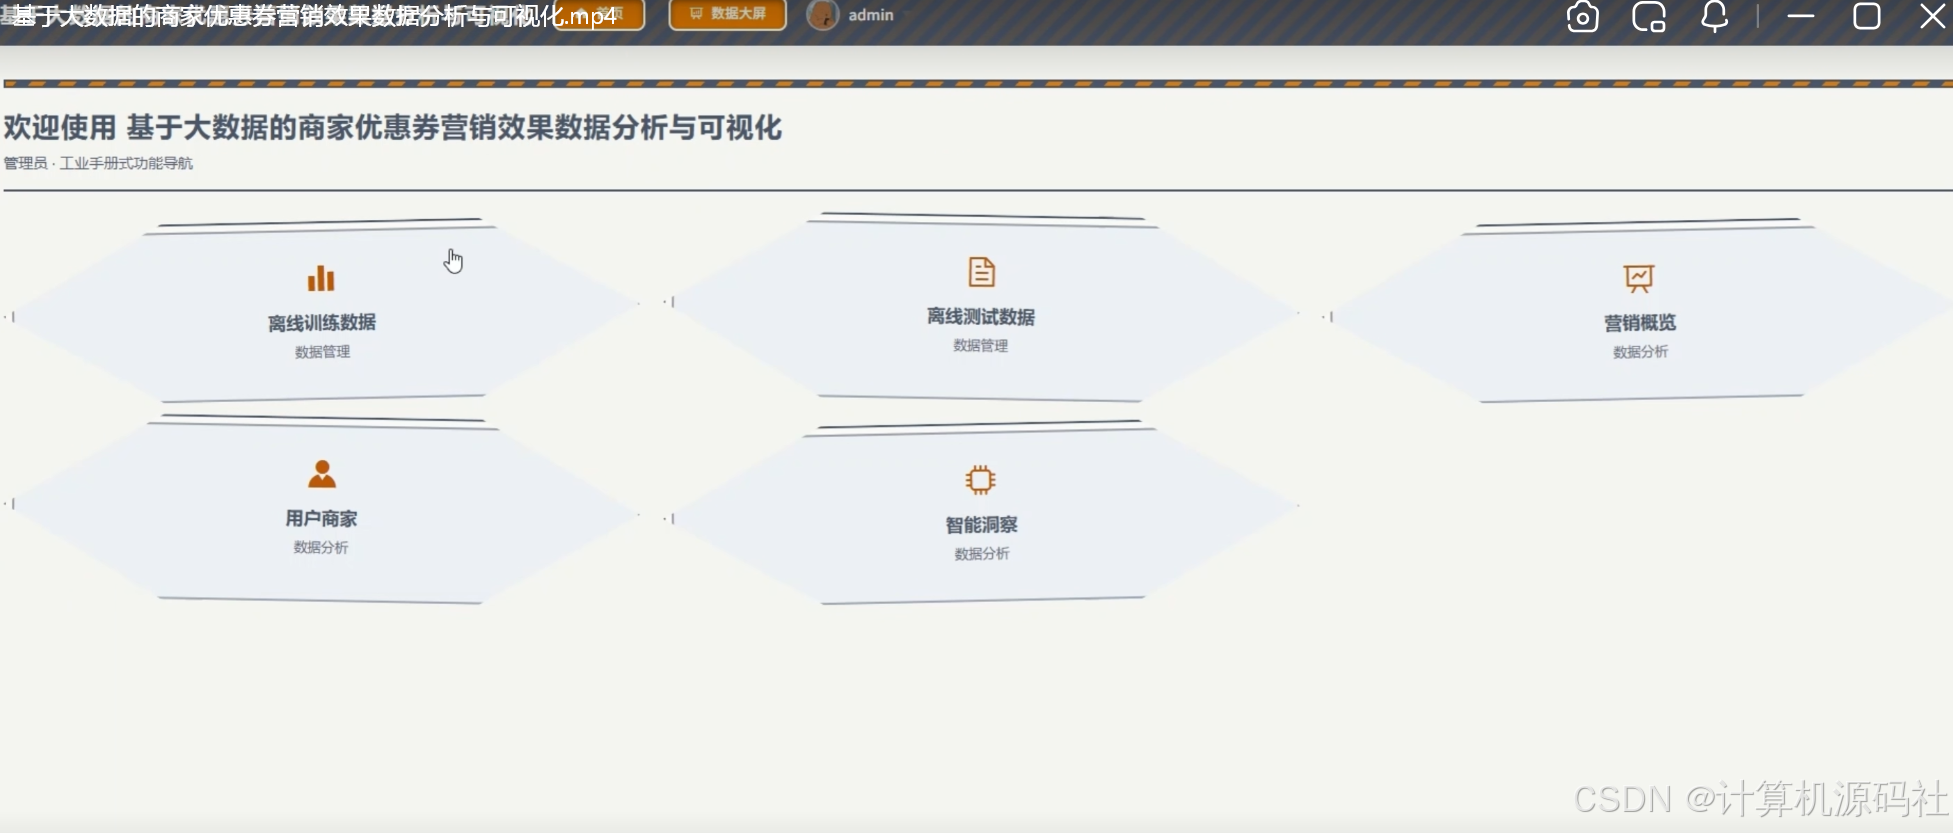
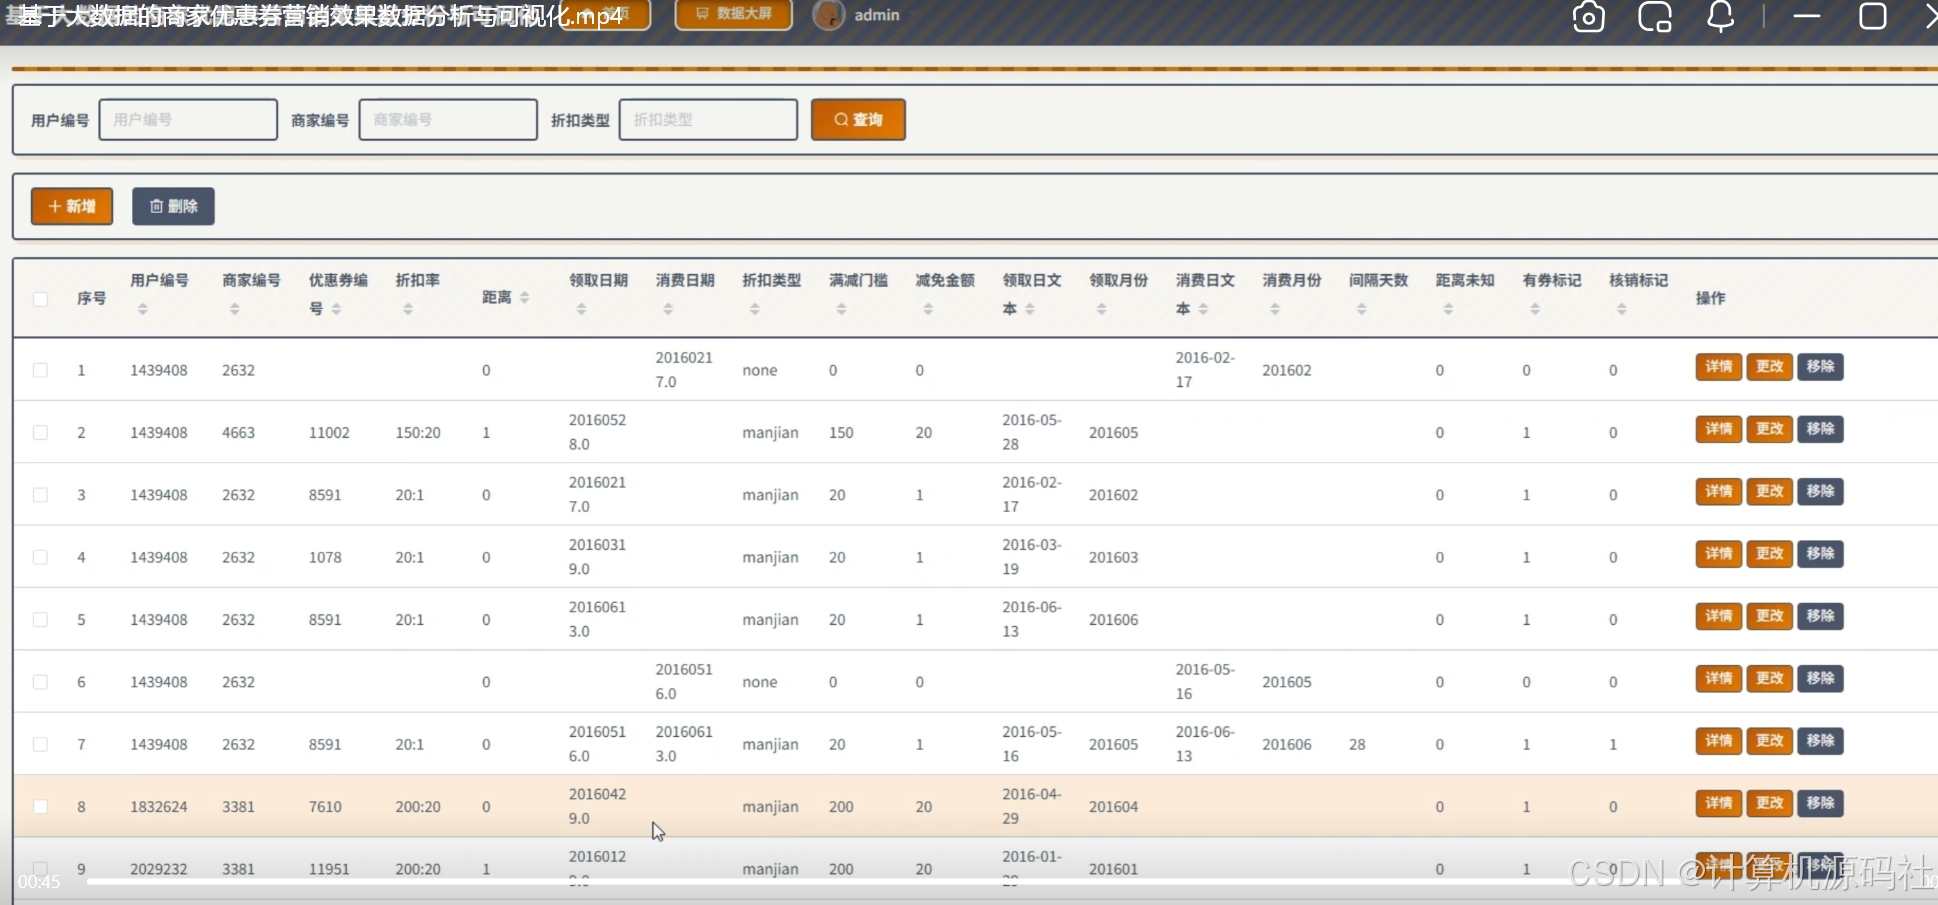
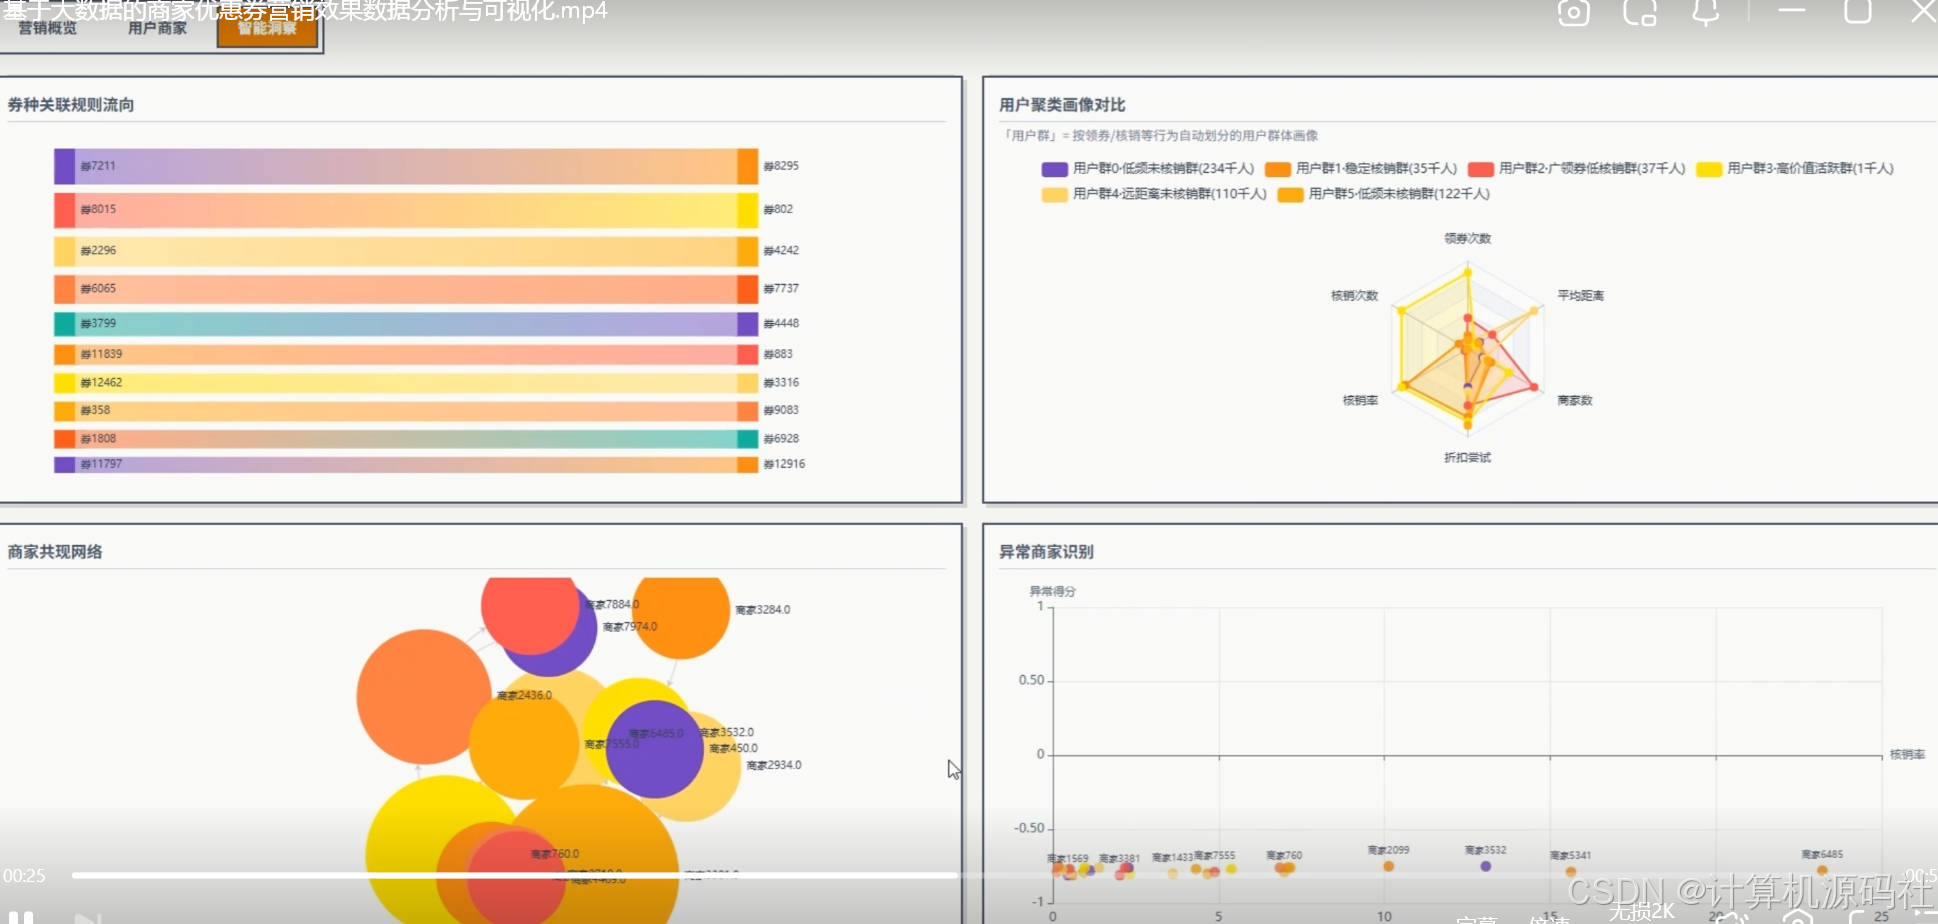
本系统的开发内容涵盖数据采集、存储计算、算法建模、后台管理与前端可视化展示等多个模块。数据管理模块负责维护离线训练数据与离线测试数据,提供增删改查等基础功能,记录用户编号、商家编号、优惠券编号、折扣率、消费距离及核销标记等明细数据。数据分析与挖掘模块基于Spark与Python构建,运用K-Means算法生成用户聚类画像,实现用户价值分层、分层用户折扣偏好分析以及异常商家识别。可视化大屏模块采用Vue与Echarts开发,包含营销概览、用户商家、智能洞察三大核心视图。营销概览子模块展示了核销行为构成、热门券种发券与核销散点、折扣形式发券核销对比、月度发券与核销趋势、核销时效漏斗以及距离档位核销率走势。用户商家子模块呈现了商家多维对比、商家核销率排名、商家共现网络与券种关联规则流向。智能洞察子模块集成了用户聚类画像对比与异常商家识别功能。后台首页提供工业手册式功能导航,方便管理员快速切换不同业务视图。
4、系统页面设计
如需要源码,可以扫取文章下方二维码联系咨询
5、参考文献
1关安青. 基于Java的电商软件开发与大数据分析J.数字技术与应用,2025,43(5):193-195.
2郑传杰.面向零售行业客户数据分析系统的设计与实现D.北京交通大学,2024.DOI:10.26944/d.cnki.gbfju.2024.000666.
3李蒙蒙.考虑外卖消费者价格偏好和平台精准能力的优惠券投放策略D.华东交通大学,2024.DOI:10.27147/d.cnki.ghdju.2024.000140.
4张浩哲.基于湖仓一体的连锁超市BI系统的研究与实现D.中国地质大学(北京),2024.DOI:10.27493/d.cnki.gzdzy.2024.000627.
5张宇.基于多维计算的零售数据仓库系统的研究与实现D.辽宁大学,2024.DOI:10.27209/d.cnki.glniu.2024.000835.
6曾春梅.基于消费者画像的C主题乐园大数据营销系统规划与实施研究D.广东工业大学,2024.DOI:10.27029/d.cnki.ggdgu.2024.002513.
7丁刘根,优惠券系统.陕西省,西安放芯充新能源科技有限公司,2023-12-01.
8张晓义.S公司CP导购网站网络营销优化策略D.华东师范大学,2023.DOI:10.27149/d.cnki.ghdsu.2023.004698.
9江岳亮.面向程序化广告的大数据分析系统设计与实现D.暨南大学,2023.DOI:10.27167/d.cnki.gjinu.2023.002011.
10施正轩.基于微服务架构的商户经营管理平台设计与实现D.北京交通大学,2023.DOI:10.26944/d.cnki.gbfju.2023.002352.
11王康成.基于营销响应模式的优惠券使用预测研究D.中南财经政法大学,2023.DOI:10.27660/d.cnki.gzczu.2023.000391.
12郭泽楷.融合电商与ERP管理的产业链平台设计与应用D.福州大学,2023.DOI:10.27022/d.cnki.gfzhu.2023.003596.
13何伟,张良均.Python商务数据分析与实战M.人民邮电出版社: 2022.
14翟世臣,张良均.Python数据分析与挖掘实战M.人民邮电出版社: 2022.
15徐鹏远.电商数据分析平台的设计与实现D.中国地质大学(北京),2022.DOI:10.27493/d.cnki.gzdzy.2022.001255.
16韩璇."京东运动"电商C端视觉应用的创新设计D.天津工业大学,2021.DOI:10.27357/d.cnki.gtgyu.2021.000933.
17王帮宇.游戏联运系统的设计与实现D.大连理工大学,2021.DOI:10.26991/d.cnki.gdllu.2021.002211.
18宋霞.基于XGBoost的O2O优惠券使用预测研究及应用D.西南交通大学,2021.DOI:10.27414/d.cnki.gxnju.2021.002056.
19李国涛.基于Flink的Lemon Box电商平台的设计与实现D.北京交通大学,2020.DOI:10.26944/d.cnki.gbfju.2020.003264.
20王欣.基于用户画像的营销平台的设计与实现D.北京交通大学,2020.DOI:10.26944/d.cnki.gbfju.2020.003004.
6、核心代码
java
# 初始化SparkSession,连接Hadoop集群与MySQL数据源
spark = SparkSession.builder \
    .appName("CouponUserClustering") \
    .config("spark.sql.warehouse.dir", "/user/hive/warehouse") \
    .enableHiveSupport() \
    .getOrCreate()

# 从MySQL/Hive读取用户优惠券行为数据,提取用户ID、领券次数、核销次数、消费距离、折扣率等特征
user_behavior_df = spark.sql("""
    SELECT user_id,
           COUNT(coupon_id) AS receive_cnt,
           SUM(is_used) AS used_cnt,
           AVG(distance) AS avg_distance,
           AVG(discount_rate) AS avg_discount
    FROM coupon_transaction
    GROUP BY user_id
""")

# 特征向量组装,构建机器学习所需的特征列
feature_cols = ["receive_cnt", "used_cnt", "avg_distance", "avg_discount"]
assembler = VectorAssembler(inputCols=feature_cols, outputCol="features")
vector_df = assembler.transform(user_behavior_df)

# 特征标准化处理,消除量纲差异对K-Means聚类距离计算的影响
scaler = StandardScaler(inputCol="features", outputCol="scaledFeatures", withStd=True, withMean=True)
scaler_model = scaler.fit(vector_df)
scaled_df = scaler_model.transform(vector_df)

# 设置K-Means算法参数,根据业务需求将用户划分为6类(对应低领未核销群、稳定核销群、高价值活跃群等)
kmeans = KMeans(featuresCol="scaledFeatures", k=6, seed=42)
kmeans_model = kmeans.fit(scaled_df)

# 对全量用户进行聚类预测,生成聚类标签
clustered_df = kmeans_model.transform(scaled_df)

# 评估聚类效果,计算轮廓系数
evaluator = ClusteringEvaluator(featuresCol="scaledFeatures")
silhouette_score = evaluator.evaluate(clustered_df)
print(f"Silhouette Score: {silhouette_score}")

# 将聚类结果与业务标签映射,输出用户画像分层数据,供前端雷达图与环形图调用
clustered_df.select("user_id", "receive_cnt", "used_cnt", "avg_distance", "avg_discount", "prediction") \
    .write.mode("overwrite").format("jdbc") \
    .option("url", "jdbc:mysql://localhost:3306/coupon_db") \
    .option("dbtable", "user_cluster_result") \
    .option("user", "root").option("password", "123456").save()

spark.stop()💕💕作者:计算机源码社
💕💕个人简介:本人八年开发经验,擅长Java、Python、PHP、.NET、Node.js、Spark、hadoop、Android、微信小程序、爬虫、大数据、机器学习等,大家有这一块的问题可以一起交流!
💕💕学习资料、程序开发、技术解答、文档报告
💕💕如需要源码,可以扫取文章下方二维码联系咨询