文章目录
数据结构9:排序算法
排序的概念及其运用
排序的概念
- 排序:把一串记录,按照某个或某些关键字的大小,递增或递减排列的操作。
- 稳定性:若原序列中两个关键字相等的记录 ri == rj,且 ri 原来在 rj 前面,排序后 ri 仍在 rj 前面,则称该排序算法稳定;否则不稳定。
- 内部排序:数据全部放在内存中排序。
- 外部排序:数据太大,不能同时放入内存,需要在内外存之间移动数据。
排序运用
-
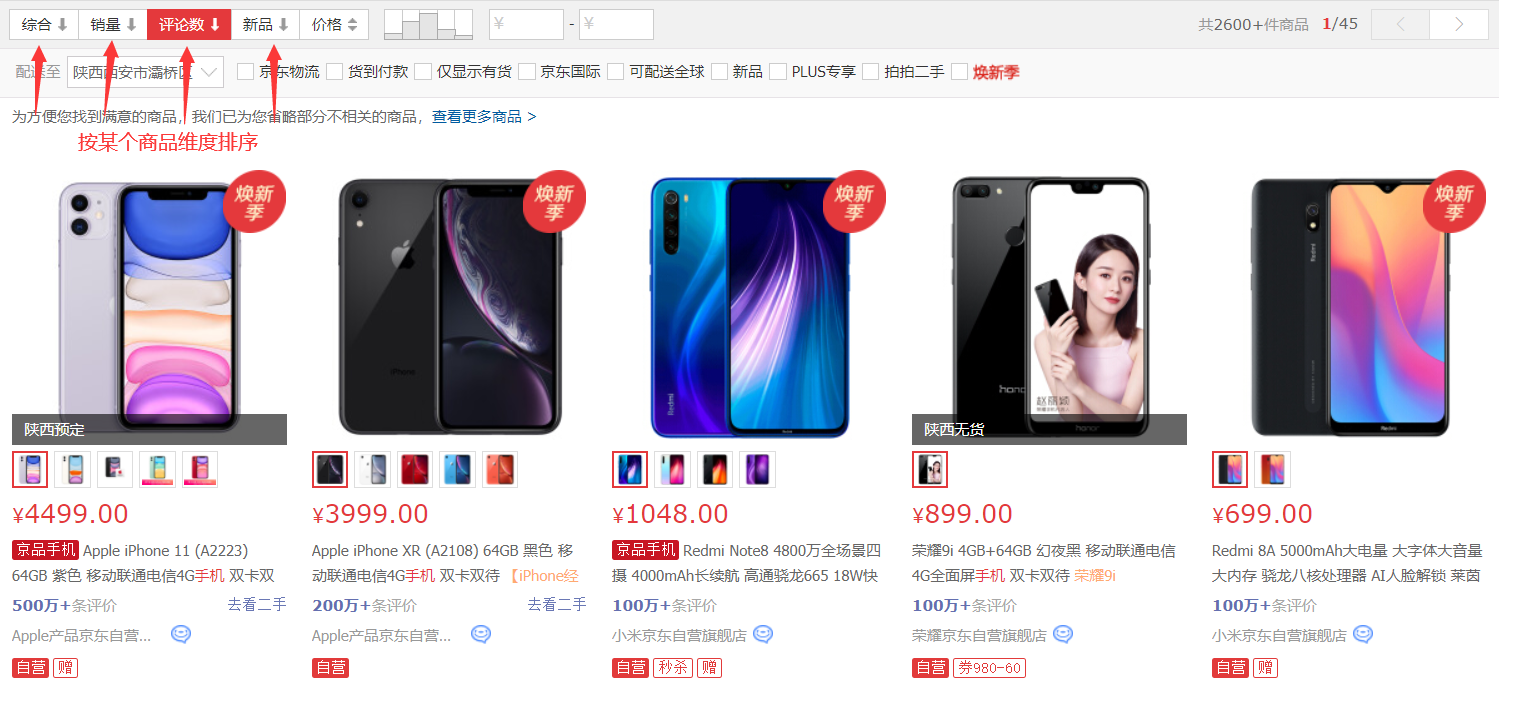
电商:按销量、评论数、价格排序。
-
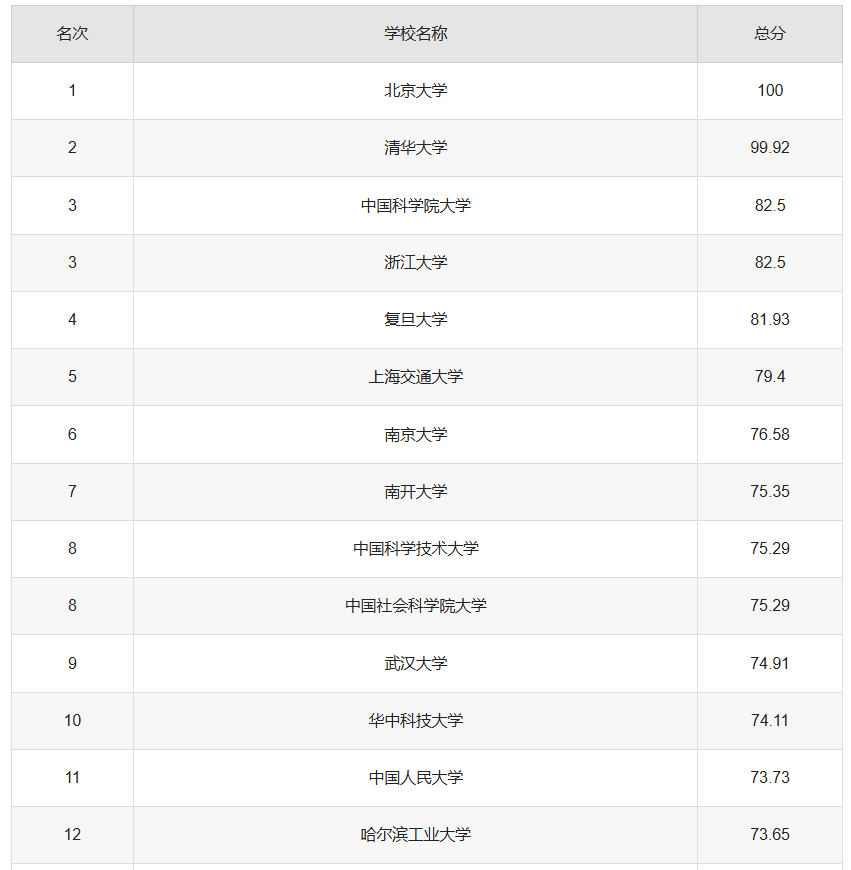
大学排名:按总分、类型、地区排序。
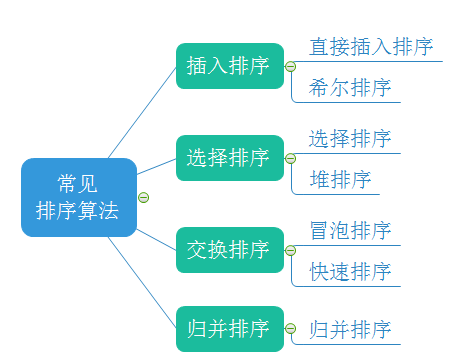
常见排序算法
常见排序算法的实现
插入排序
直接插入排序
直接插入排序是一种简单的插入排序法,其基本思想是:
把待排序的记录按其关键码值的大小逐个插入到一个已经排好序的有序序列中,直到所有的记录插入完为止,得到一个新的有序序列 。
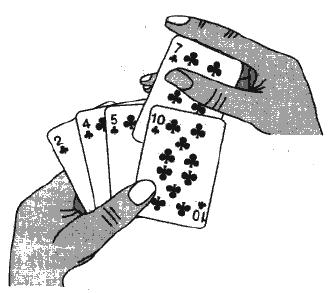
实际中我们玩扑克牌时,就用了插入排序的思想
c
// 直接插入排序
void InsertSort(int* arr, int n)
{
	// 从第 2 个元素开始,依次插入到前面的有序区间 [0, i-1]
	for (int i = 1; i < n; ++i)
	{
		int end = i - 1;  // 有序区间的最后一个位置
		int tmp = arr[i]; // 保存当前要插入的元素

		// 从后往前找插入位置:比 tmp 大的元素统一后移
		while (end >= 0 && arr[end] > tmp)
		{
			arr[end + 1] = arr[end];
			--end;
		}

		// 此时 end 后面就是 tmp 应该插入的位置
		arr[end + 1] = tmp;
	}
}特性:
- 元素集合越接近有序,直接插入排序算法的时间效率越高
- 时间复杂度:O(N^2)
- 空间复杂度:O(1),它是一种稳定的排序算法
- 稳定性:稳定
什么是稳定性?
稳定性的定义是:排序后,关键字相等的记录相对顺序保持不变。判断时不能只看"相等数据会不会移动",而要看相等元素的相对次序是否改变。直接插入排序中,遇到相等元素不后移,所以相等元素相对顺序不变,因此稳定。
希尔排序
希尔排序又叫缩小增量排序
思想:先按较大增量 gap 分组,对每组做插入排序,让数组逐渐接近有序;最后 gap = 1 时再做一次直接插入排序。
比如:
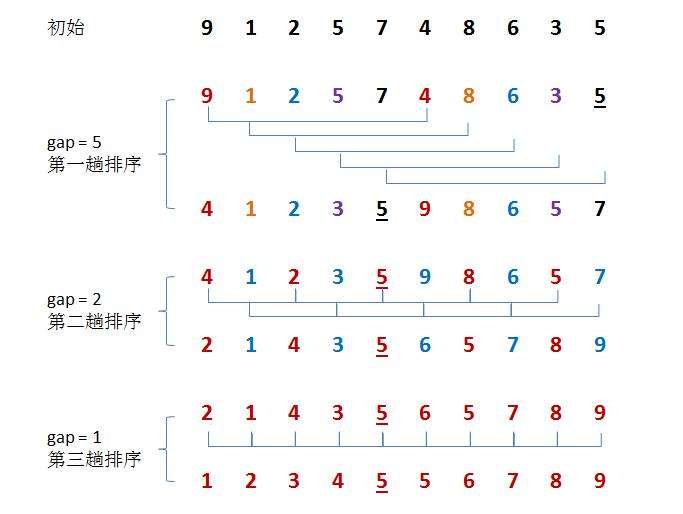
- 大 gap 时,元素可以大步移动,快速减少逆序对。
- 小 gap 时,数组已经接近有序,插入排序效率高。
- gap = gap / 3 + 1 保证最后一定会到 1。
- 因为存在跳跃式交换,相同元素可能改变相对顺序,所以不稳定。
c
// 希尔排序
void ShellSort(int* arr, int n)
{
	int gap = n;
	while (gap > 1)
	{
		gap = gap / 3 + 1;
		for (int i = 0; i < n - gap; ++i)
		{
			int end = i;
			int tmp = arr[i + gap];
			while (end >= 0 && arr[end] > tmp)
			{
				arr[end + gap] = arr[end];
				end -= gap;
			}
			arr[end + gap] = tmp;
		}
	}
}特性:
- 时间复杂度:约 O(N^1.3) ~ O(N^2),与增量序列有关。
- 空间复杂度:O(1)。
- 稳定性:不稳定。
希尔排序的时间复杂度不好计算,因为gap的取值方法很多,导致很难去计算,因此在好些书中给出的希尔排序的时间复杂度都不固定
比如:
gap可以取 gap = n / 2,gap = gap / 2直到取到1;
还有就是我们上面实现的一种gap = n / 3 + 1等一些取法。
选择排序
每一次从待排序的数据元素中选出最小(或最大)的一个元素,存放在序列的起始位置,直到全部待排序的数据元素排完 。
直接选择排序
- 在元素集合arrayi--arrayn-1中选择关键码最大(小)的数据元素
- 若它不是这组元素中的最后一个(第一个)元素,则将它与这组元素中的最后一个(第一个)元素交换
- 在剩余的arrayi--arrayn-2(arrayi+1--arrayn-1)集合中,重复上述步骤,直到集合剩余1个元素
我们这里实现的是同时选两个,一个选最小一个选最大,这样可以减少遍历次数。
c
// 选择排序
void Swap(int* a, int* b)
{
	int tmp = *a;
	*a = *b;
	*b = tmp;
}

void SelectSort(int* arr, int n)
{
	int begin = 0, end = n - 1;

	while (begin < end)
	{
		int mini = begin;
		int maxi = begin;

		for (int i = begin; i <= end; ++i)
		{
			if (arr[i] < arr[mini])
			{
				mini = i;
			}
			if (arr[i] > arr[maxi])
			{
				maxi = i;
			}
		}

		Swap(&arr[begin], &arr[mini]);

		// 如果 maxi == begin 说明第一个就是最大的此时就是begin的位置
		if (begin == maxi)
		{
			// 前面mini的位置已经和begin交换了所以这里就要让maxi移到mini的位置
			// 因为此时mini的位置就是原来的begin
			maxi = mini;
		}

		Swap(&arr[end], &arr[maxi]);

		++begin;
		--end;
	}
}特性:
- 时间复杂度:O(N^2)。
- 空间复杂度:O(1)。
- 稳定性:不稳定。
堆排序
利用堆结构选数。升序建大堆,降序建小堆。每次把堆顶(最大值)与末尾交换,再调整剩余部分为堆。
c
// 堆排序
// 建大堆
void AdjustDown(int* arr, int n, int parent)
{
	int child = parent * 2 + 1;

	while (child < n)
	{
		if (child + 1 < n && arr[child + 1] > arr[child])
		{
			child++;
		}
		if (arr[child] > arr[parent])
		{
			Swap(&arr[child], &arr[parent]);
			parent = child;
			child = parent * 2 + 1;
		}
		else {
			break;
		}
	}
}

void HeapSort(int* arr, int n)
{
	for (int i = (n - 2) / 2; i >= 0; --i)
	{
		//先将数组建成堆
		AdjustDown(arr, n, i);
	}

	int end = n - 1;
	while (end > 0)
	{
		Swap(&arr[0], &arr[end]);
		// 然后从最后的非叶子节点开始,保证每一个子树都是堆
		AdjustDown(arr, end, 0);
		--end;
	}
}特性:
- 时间复杂度:O(N log N)。
- 空间复杂度:O(1)。
- 稳定性:不稳定。
交换排序
基本思想:所谓交换,就是根据序列中两个记录键值的比较结果来对换这两个记录在序列中的位置,交换排序的特点是:将键值较大的记录向序列的尾部移动,键值较小的记录向序列的前部移动。
冒泡排序
思想:相邻元素比较,大的往后移,像气泡上浮。
c
// 冒泡排序
void BubbleSort(int* arr, int n)
{
	for (int i = 0; i < n - 1; ++i)
	{
		int flag = 0;
		for (int j = 1; j < n - i; ++j)
		{
			if (arr[j - 1] > arr[j])
			{
				Swap(&arr[j - 1], &arr[j]);
				flag = 1;
			}

		}
		// 优化手段,flag如果等于0说明已经有序了
		if (flag == 0)
		{
			break;
		}
	}
}特性:
- 时间复杂度:平均/最坏 O(N^2),最好 O(N)。
- 空间复杂度:O(1)。
- 稳定性:稳定。
快速排序
快速排序是Hoare于1962年提出的一种二叉树结构的交换排序方法。
思想 :选一个基准值 key,把区间分成左小右大两部分,再递归处理左右子区间。类似二叉树前序遍历。
快速排序的实现主要:hoare版,挖坑法,前后指针法;
主框架:
c
// 假设按照升序对array数组中[left, right)区间中的元素进行排序
void QuickSort(int array[], int left, int right)
{
	if (left >= right)
		return;
	// 按照基准值对array数组的 [left, right)区间中的元素进行划分
	int div = partion(array, left, right);
	// 划分成功后以div为边界形成了左右两部分 [left, div) 和 [div+1, right)
	// 递归排[left, div)
	QuickSort(array, left, div - 1);
	// 递归排[div+1, right)
	QuickSort(array, div + 1, right);
}
这里我们使用快排的最优写法,这种写法继承了上述写法各自的优点也解决了部分缺点。
上述写法比如:hoare版、挖坑法和前后双指针版取的都是中间值,我们根据常识都能知道取某一部分的值的做法往往只能解决部分问题,而随机基准可以降低遇到最坏情况的概率,使期望时间复杂度为 O(N log N),但理论上仍有可能退化为 O(N²)。
== key
< key
> key
通过上述两种做法就让三路快排把"双指针逼近、基准值暂存、区间维护"这些思想综合起来,再用荷兰国旗(三色问题)问题的一次线性划分,把等于基准值的元素一次性全部归位。
c
// 随机基准值生成
int GetRandom(int* arr, int left, int right)
{
	return arr[rand() % (right - left + 1) + left];
}

// 快速排序
void _QuickSort(int* arr, int left,int right)
{
	if (left >= right)
	{
		return;
	}

	int key = GetRandom(arr, left, right);

	// 此时得到了三个区间
	// == key
	// < key
	// > key

	int i = left, l = left - 1, r = right + 1;

	while (i < r)
	{
		if (arr[i] < key)
		{
			Swap(&arr[++l], &arr[i]);
			++i;
		}
		else if (arr[i] > key)
		{
			Swap(&arr[--r], &arr[i]);
		}
		else {
			++i;
		}
	}

	_QuickSort(arr, left, l);
	_QuickSort(arr, r, right);

}

void QuickSort(int* arr, int n)
{
	_QuickSort(arr, 0, n - 1);
}
这里其实就可以优化一下就是当数据量小的时候可以用插入排序,这样能保证数据接近有序或数据量少时的时间复杂度在O(N)。
特性:
- 时间复杂度:平均 O(N log N),最坏 O(N^2)(有序且未优化)。
- 空间复杂度:递归栈 O(log N) ~ O(N)。
- 稳定性:不稳定。
既然有递归写法那也通常有迭代写法,快排的迭代写法使用栈来实现:
c
typedef struct Range {
	int left;
	int right;
} Range;

void Partition3Way(int* arr, int left, int right, int* outl, int* outr)
{
	int key = GetRandom(arr, left, right);

	int i = left, l = left - 1, r = right + 1;

	while (i < r)
	{
		if (arr[i] < key)
		{
			Swap(&arr[++l], &arr[i]);
			++i;
		}
		else if (arr[i] > key)
		{
			Swap(&arr[--r], &arr[i]);
		}
		else
		{
			++i;
		}
	}

	*outl = l;
	*outr = r;
}

void QuickSortIter(int* arr, int n)
{
	if (n <= 1)
	{
		return;
	}

	int capacity = 64;
	Range* stack = (Range*)malloc(sizeof(Range) * capacity);

	int top = 0;

	stack[top++] = (Range){ 0, n - 1 };

	while (top > 0)
	{
		Range cur = stack[--top];
		int left = cur.left;
		int right = cur.right;

		while (left < right)
		{
			int l, r;
			Partition3Way(arr, left, right, &l, &r);

			int leftSize = l - left + 1;
			int rightSize = right - r + 1;

			if (leftSize < rightSize)
			{
				if (r <= right)
				{
					if (top >= capacity)
					{
						capacity *= 2;
						stack = (Range*)realloc(stack, sizeof(Range) * capacity);
					}
					stack[top++] = (Range){ r,right };
				}
				right = l;
			}
			else {
				if (l >= left)
				{
					if (top >= capacity)
					{
						capacity *= 2;
						stack = (Range*)realloc(stack, sizeof(Range) * capacity);
					}
					stack[top++] = (Range){ left, l };
				}
				left = r;
			}
		}
	}

	free(stack);
	stack = NULL;
}
因为涉及到了开辟空间所以最好是将判断代码带上,但是快排的迭代写法只需要了解是用什么实现的即可,自己能不能写出来不重要,只需要保证自己能完整的写出递归的版本的三路划分即可
归并排序
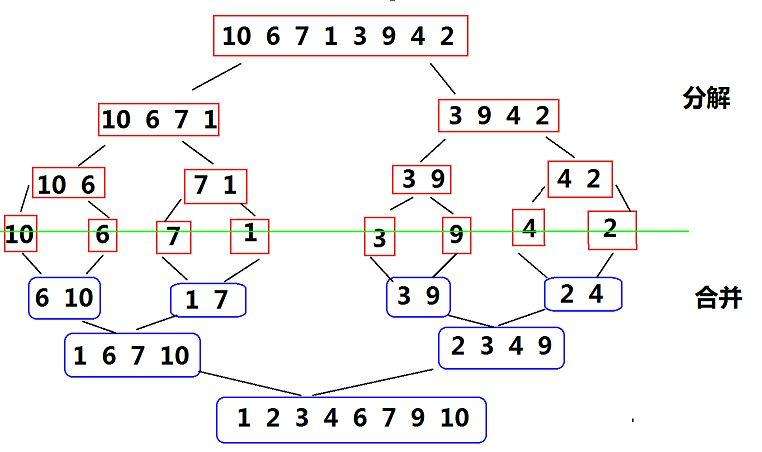
归并排序(MERGE-SORT)是建立在归并操作上的一种有效的排序算法,该算法是采用分治法(Divide andConquer)的一个非常典型的应用。将已有序的子序列合并,得到完全有序的序列;即先使每个子序列有序,再使子序列段间有序。若将两个有序表合并成一个有序表,称为二路归并。 归并排序核心步骤:
c
void _MergeSort(int* arr, int left, int right, int* tmp)
{
	if (left >= right)
	{
		return;
	}

	int mid = left + (right - left) / 2;

	_MergeSort(arr, left, mid, tmp);
	_MergeSort(arr, mid + 1, right, tmp);

	int begin1 = left, end1 = mid;
	int begin2 = mid + 1, end2 = right;
	int index = left;

	while (begin1 <= end1 && begin2 <= end2)
	{
		if (arr[begin1] <= arr[begin2])
		{
			tmp[index++] = arr[begin1++];
		}
		else {
			tmp[index++] = arr[begin2++];
		}
	}

	while (begin1 <= end1)
		tmp[index++] = arr[begin1++];

	while (begin2 <= end2)
		tmp[index++] = arr[begin2++];

	// 把临时数组内容拷回原数组
	memcpy(arr + left, tmp + left, sizeof(int) * (right - left + 1));
}

void MergeSort(int* arr, int n)
{
	int* tmp = (int*)malloc(sizeof(int) * n);
	if (tmp == NULL)
	{
		perror("malloc fail");
		exit(-1);
	}

	_MergeSort(arr, 0, n - 1, tmp);

	free(tmp);
}特性:
- 归并的缺点在于需要O(N)的空间复杂度,归并排序的思考更多的是解决在磁盘中的外排序问题。
- 时间复杂度:O(N*logN)
- 空间复杂度:O(N)
- 稳定性:稳定
非比较排序
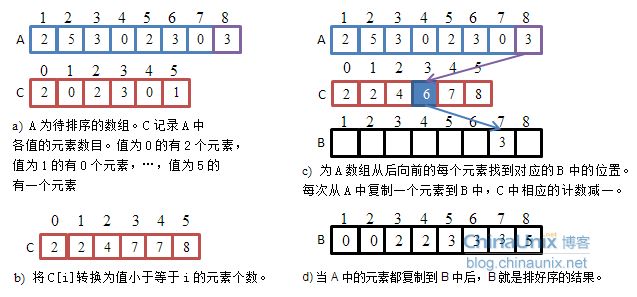
思想:计数排序又称为鸽巢原理,是对哈希直接定址法的变形应用。 操作步骤:
- 统计相同元素出现次数
- 根据统计的结果将序列回收到原来的序列中
c
void CountSort(int* arr, int n)
{
	int min = arr[0], max = arr[0];

	// 找最小和最大,确定范围
	for (int i = 1; i < n; ++i)
	{
		if (arr[i] < min)
		{
			min = arr[i];
		}
		if (arr[i] > max)
		{
			max = arr[i];
		}
	}

	int rang = max - min + 1;

	// 统计次数
	int* count = (int*)calloc(rang, sizeof(int));
	if (count == NULL)
	{
		perror("calloc fail");
		exit(-1);
	}

	for (int i = 0;i < n; ++i)
	{
		count[arr[i] - min]++;
	}

	int index = 0;

	// 按顺序回收
	for (int i = 0; i < rang; ++i)
	{
		for (int j = 0; j < count[i]; ++j)
		{
			arr[index++] = i + min;
		}
	}

	free(count);
}特性:
- 时间复杂度:O(MAX(N, 范围))。
- 空间复杂度:O(范围)。
- 稳定性:稳定
排序算法复杂度及稳定性分析
| 排序方法 | 平均情况 | 最好情况 | 最坏情况 | 辅助空间 | 稳定性 |
|---|---|---|---|---|---|
| 冒泡排序 | O(N²) | O(N) | O(N²) | O(1) | 稳定 |
| 简单选择排序 | O(N²) | O(N²) | O(N²) | O(1) | 不稳定 |
| 直接插入排序 | O(N²) | O(N) | O(N²) | O(1) | 稳定 |
| 希尔排序 | O(N^1.3) ~ O(N²) | 与增量有关 | O(N²) | O(1) | 不稳定 |
| 堆排序 | O(N log N) | O(N log N) | O(N log N) | O(1) | 不稳定 |
| 归并排序 | O(N log N) | O(N log N) | O(N log N) | O(N) | 稳定 |
| 快速排序 | O(N log N) | O(N log N) | O(N²) | O(log N) ~ O(N) | 不稳定 |
| 计数排序 | O(MAX(N, 范围)) | O(N + 范围) | O(N + 范围) | O(范围) | 稳定 |
稳定:冒泡、插入、归并、计数。
不稳定:选择、希尔、堆、快排。
需要额外大空间:归并 O(N)、计数 O(范围)。
快排最坏会退化到 O(N²),三数取中 + 小区间插入优化可缓解。
那些排序稳定,那些排序不稳定都不建议去记,我们可以边写代码边来分析看最终会不会让相等的数据次序发生改变。
完