评估一个领域的数据收得全不全,千问 App数据团队过去要花大半天:导出数据、发版审批、部署常驻服务、等召回跑完。现在,基于阿里云MaxCompute 多模态检索,只需一条提交即跑的数仓 SQL------全链路从约 6 小时 15 分压到约 32 分钟,全程零常驻资源。
业务诉求:从自建向量服务到数仓内批量召回
千问 APP 数据团队负责各领域垂类数据的收集与加工,持续供给 RAG 场景。某领域的数据是否收全,直接决定回答质量的上限,因此团队需要周期性地回答一个问题:各领域数据的覆盖率是多少?
评估方法很直接:以权威数据源为基准抽取一批 query,对向量化后的自有语料做全量向量召回,候选交模型判定命中,命中比例即覆盖率。全流程的关键环节是"全量批量向量召回"------而问题恰恰出在这里。
迁移之前,这一步依赖内部自建的 ude 向量服务。数据在数仓(ODPS)里,召回服务在数仓外,中间隔着导出转换、新建服务、字段配置、发版审批、资源部署等一串环节,一轮评估从准备到出结果,往往要耗大半天。
这条链路带来三方面负担:
•资源常驻:向量服务以固定核数的实例长期部署,即便不做检索时也持续占用资源。
•研发效率受限:发版审批、资源申请、部署等环节串行阻塞、耗时不可控,一轮评估周期长,难以支撑当天多轮迭代。
•数据要出仓:向量数据经由额外链路流出数仓,权限与安全管理的复杂度随之增加。
所以团队要的不是简单换一个检索引擎,而是同时要三样东西:能承载全量批式向量召回的引擎能力;足够低的检索成本,以支撑高频甚至全量重跑;能与既有自研数据处理与向量化链路衔接,无需为迁移重写流程。
解决方案:MaxCompute 离线向量检索承接批量召回
千问 APP 数据团队与阿里云大数据 AI 平台共同梳理了数据链路,形成"自研链路负责数据加工与向量化、MaxCompute 负责存储与批量检索"的分工。
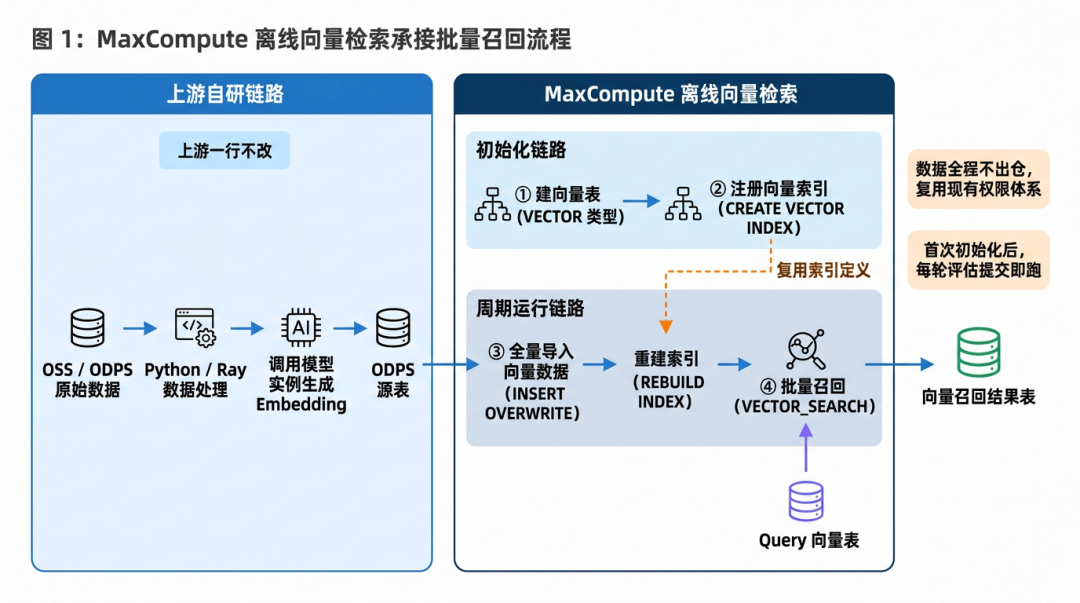
上游,一行不改。 原始数据存储在 OSS / ODPS,由 Python 脚本或 Ray 调用模型实例完成数据处理与向量化,产出的 embedding 直接写入 ODPS 表------这条链路在迁移前后完全不变。
检索,收进一条 SQL。 向量存储、索引构建与全量批式检索三个环节由 MaxCompute 离线向量检索统一承接,"导出转换 + 服务化部署"的整段工程工作被抹掉,收敛为四个动作(SQL 示意):
◆2.1 建表
sql
-- ① 建表:embedding 写入 VECTOR 类型列,数据不出仓
CREATE TABLE IF NOT EXISTS <project>.vector_base (
    unique_key STRING COMMENT '文档唯一标识',
    category   STRING COMMENT '业务元数据,可选',
    emb        VECTOR(FLOAT, 2560) COMMENT 'embedding'
) STORED AS ALIORC
TBLPROPERTIES (
    'table.format.version'   = '2',
    'acid.data.retain.hours' = '24',
    'columnar.nested.type'   = 'true',
    'transactional'          = 'true'
);◆2.2建索引
sql
-- ② 建索引:一次性注册索引定义;实际构建在每轮数据灌入后由 REBUILD 完成。
CREATE VECTOR INDEX vector_base_idx
ON <project>.vector_base (emb)
IDXPROPERTIES (
    'algorithm'     = 'hgraph',
    'distance_type' = 'cosine',
    -- 大表按需设置,公式:ceil(总 bucket 数 / 项目 worker 并发上限)
    -- 'bucket_num_per_index_file' = '8',
    'build_params'  = '{"max_degree":16,"ef_construction":128,"base_quantization_type":"fp16"}'
);◆2.3导入向量数据并建索引
sql
-- ③ 导入向量数据并建索引:INSERT OVERWRITE 全量重灌,天然幂等,随后 REBUILD 索引
INSERT OVERWRITE TABLE <project>.vector_base
SELECT s.unique_key, s.category,
       CAST(CAST(SPLIT(s.slot, ',') AS ARRAY<FLOAT>) AS VECTOR(FLOAT, 2560)) AS emb
FROM (
    SELECT unique_key, category, slot
    FROM <project>.src_table
    WHERE slot IS NOT NULL AND slot != ''
      AND SIZE(SPLIT(slot, ',')) = 2560                        -- 维度校验
      AND SIZE(FILTER(CAST(SPLIT(slot, ',') AS ARRAY<FLOAT>),
                      x -> x IS NULL)) = 0                     -- NULL 元素过滤
) s;

ALTER TABLE <project>.vector_base REBUILD INDEX vector_base_idx;◆2.4批量召回
sql
-- ④ 批量召回:一条 VECTOR_SEARCH,query 集对 base 集全量 top-k,结果直接落表
INSERT OVERWRITE TABLE <project>.vector_result
SELECT query_key, base_key, distance,
       ROW_NUMBER() OVER (PARTITION BY query_key ORDER BY distance) AS rn
FROM (
    SELECT _query.query_key AS query_key,
           _base.unique_key AS base_key,
           distance
    FROM VECTOR_SEARCH(
        (SELECT unique_key, emb FROM <project>.vector_base), emb,
        (SELECT query_key, qemb FROM <project>.vector_query), qemb,
        10, cosine
    )
);
除首次建表建索引外,此后每一轮评估都是"提交即跑"的周期性 SQL 作业:没有审批排期,没有部署等待,数据始终留在数仓内,复用现有权限体系。
合作成效:让覆盖率评估从"重工程"回到"轻查询"
专业文档场景实测(base 约 2400 万 × query 约 120 万):
|------|----------------------|---------------------------|------------|
| 对比项 | 自建向量服务(ude) | MaxCompute 离线向量检索 | 变化 |
| 索引构建 | 2 小时 53 分 | 14 分 12 秒 | 提速约 12 倍 |
| 批量检索 | 约 3 小时 20 分(100 QPS) | 18 分 03 秒(等效吞吐 1100+ QPS) | 提速约 11 倍 |
| 全链路 | 约 6 小时 15 分 | 约 32 分钟 | 提速约 11.6 倍 |
| 资源形态 | 36 核常驻实例,不检索时也占用 | 弹性并行,作业结束即释放 | 零常驻,按量计费 |
*注:表中 1100+ QPS 为批量作业的等效吞吐,用于与批量场景对比,不代表在线服务能力;在线毫秒级点查场景请使用专业向量服务。*
全链路口径的提速,一方面来自索引构建与检索本身的性能提升,另一方面来自导出转换、审批部署等流程环节的彻底消除。
成本结构也随之改变:固定常驻实例换成按量弹性作业,"不用也要花"变成"用多少花多少"。相同预算下,同一领域的覆盖率评估可以更高频地重跑,新增垂类也能低成本接入同一套链路。
迭代方式同样变了。仍以专业文档领域为例:外部权威文档条目清单约百万行作为 query 集,自有文档向量千万条作为 base 集,每条 query 召回 top10 交模型判定,命中比例即覆盖率。升级 embedding,重灌 base 表,一条 SQL;调整 query 集,重落 query 表,一条 SQL;检索结果十几分钟返回,当天即可完成多轮评估。"发现缺口 → 补充数据 → 再评估"的循环,第一次真正转了起来。
"以前一轮评估要经历导出转换、发版审批、资源部署一连串环节,常驻实例的成本也长期摆在那里。现在批量向量检索收敛成了数仓里的一条 SQL 作业------数据不出仓,索引由平台自动维护。我们希望把它推广到更多垂类和更大规模,让覆盖率评估成为可持续、低成本的常规动作。"------ 千问 APP 数据团队
目前该方案已在生产上线,新垂类沿用同一架构;团队还在 亿级向量的全量规模上验证了链路可行性------规模越大,相较常驻服务方案的优势越明显。
展望
覆盖率评估只是这套向量检索能力的起点。随着法律、财经、学术等更多垂类陆续接入同一套架构,数仓内批量召回正在从单一的评估动作,延伸为数据建设各环节的通用底座------无论是训练数据集构建中的 corner case 圈选、候选集的批量生产,还是新增数据的相似性排查,都可以复用同一条 SQL 链路,而无需为每个场景单独搭建和维护向量服务。
对千问 APP数据团队而言,把大规模批量检索交给平台承接之后,团队得以将精力集中在真正构成差异化的环节------垂类数据的理解、加工与向量化质量上。对阿里云大数据 AI 平台而言,这一实践也在持续反哺产品能力:大表索引分片调度参数的沉淀,正推动向量检索在超大规模场景下的易用性完善。双方将围绕检索性能、规模上限与场景覆盖持续联合打磨,让"在数仓里批量找相似"成为一种低门槛、可持续的常规能力。