一、介绍
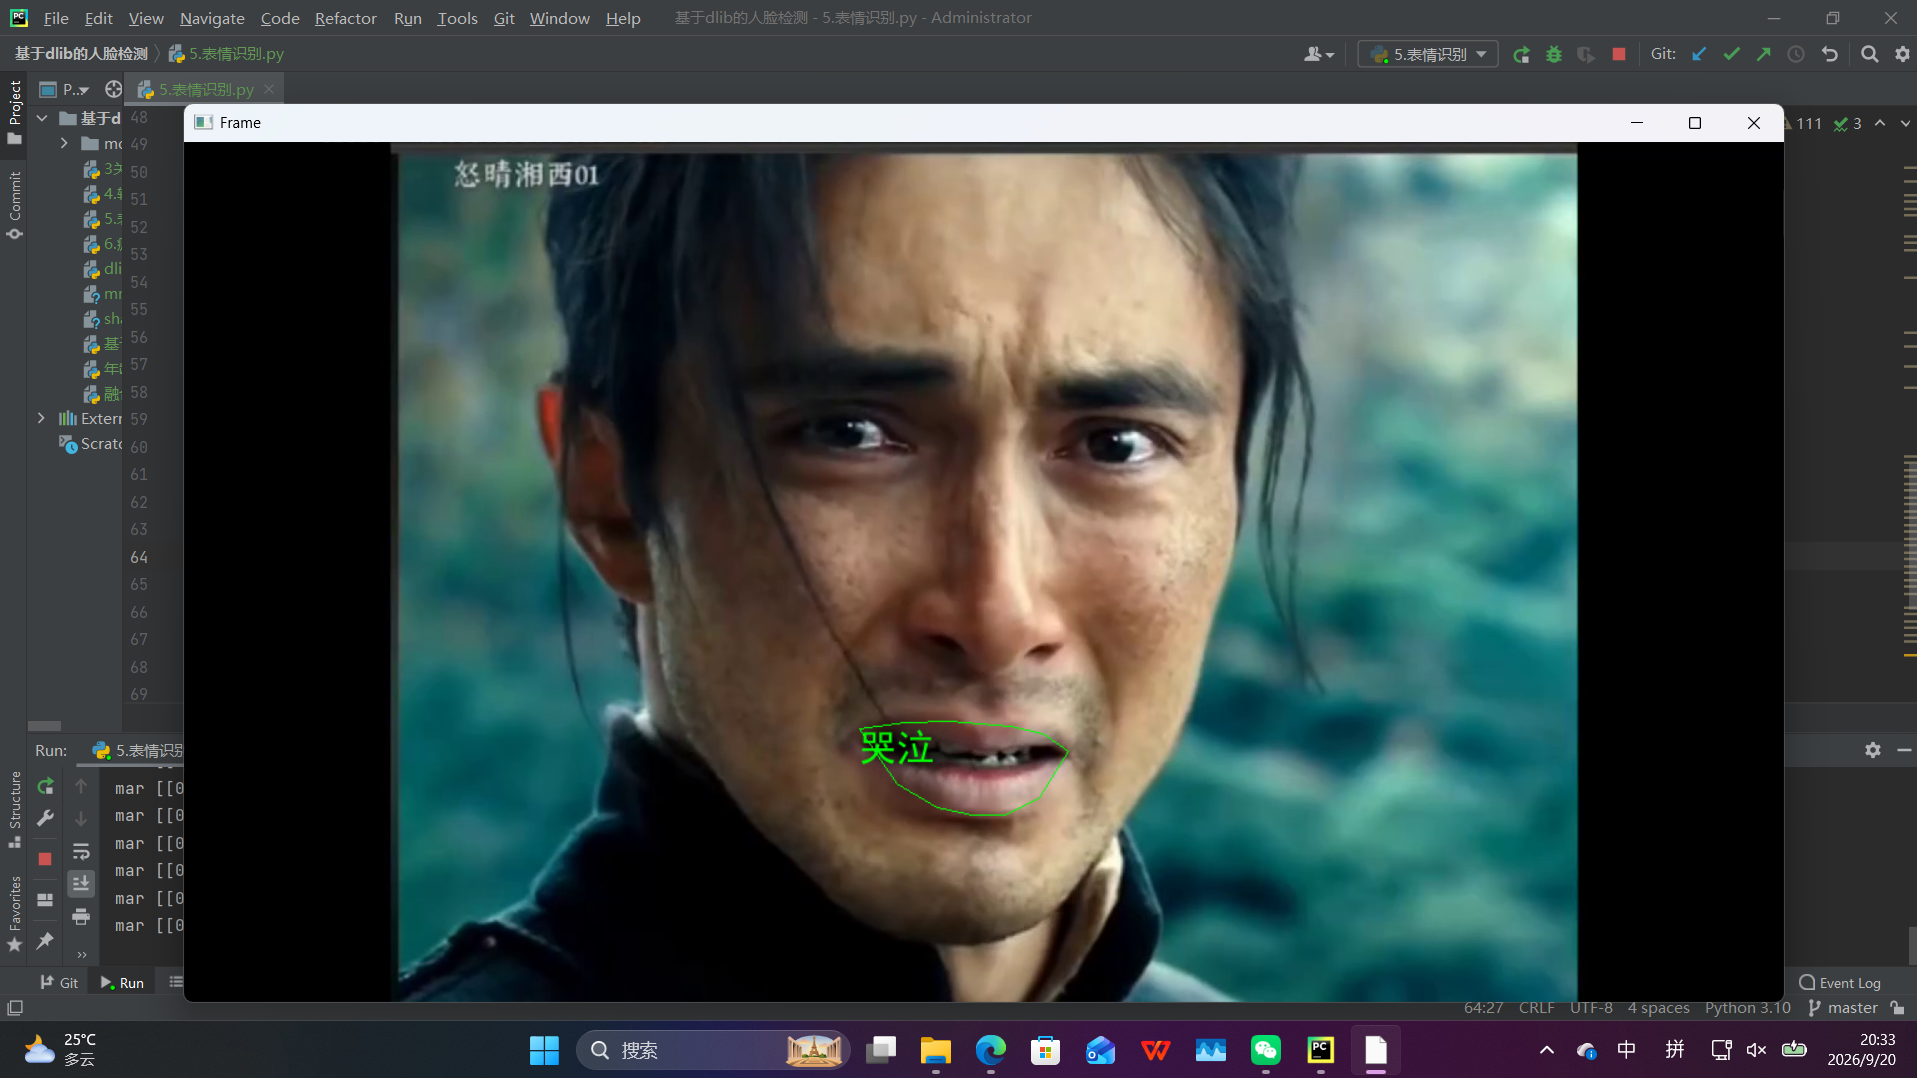
本次是一个基于dlib68点人脸关键点的简单表情识别程序。它从视频中逐帧读取画面,检测人脸,提取嘴部、脸颊、下巴等关键点,计算三个几何比例特征,再通过阈值判断表情:正常、大笑、哭泣、微笑,最后在嘴部画凸包并显示中文标签。
二、核心代码讲解
2.1整体功能与依赖
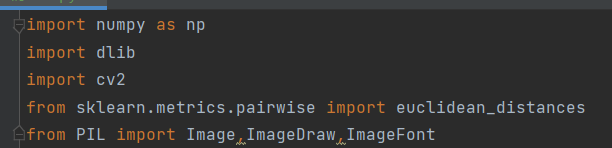
numpy:数组和向量计算。
dlib:人脸检测和68点关键点预测。
cv2:OpenCV,读取视频、显示图像、画轮廓。
eucliden_distances:计算两个点之间的欧式距离。
PIL:在OpenCV图像上绘制中文文字。
2.2三个表情特征函数
2.2.1.MAR(shape):嘴部宽高比,用于检测大笑。
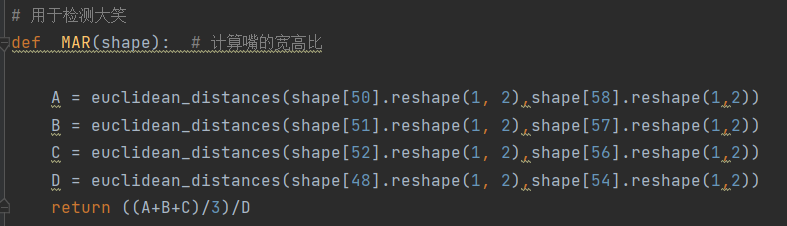
dlib68点中,48到67是嘴部区域。
shape48和shape54是左右嘴角;
shape50、shape51、shape52是上唇附近的点;
shape56、shape57、shape58是下唇附近的点;
A、B、C分别计算上唇到下唇三组垂直距离,取平均值,表示嘴张开的程度。
D是左右嘴角的水平距离,表示嘴的宽度。
MAR=平均上下唇距离 / 嘴角宽度
2.2.2.MJR(shape):嘴宽与脸颊宽比值,用于检测微笑
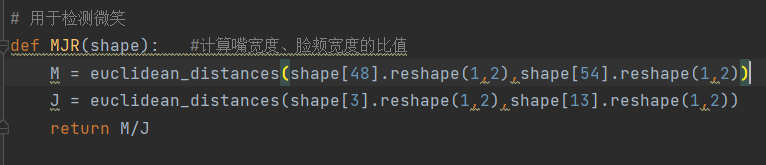
M:左右嘴角距离,即嘴宽。
J:shape3和shape13是下颌轮廓左右两侧的点,近似脸宽。
MJR = 嘴宽 / 脸宽
2.2.3.MDR(shape):嘴角下垂比,用于检测哭泣
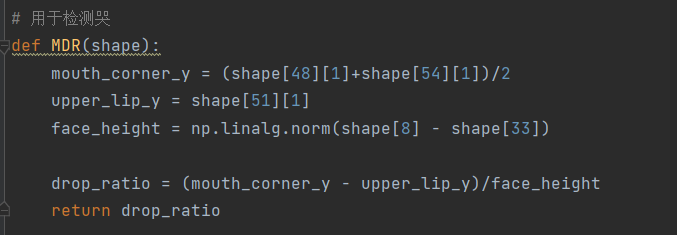
mouth_corner_y:左右嘴角的平均y坐标。
upper_lib_y:上唇某一点的y坐标。
face_height:shape8是下巴,shape33是鼻尖,二者距离近似脸高。
图像坐标中y轴向下增大,所以嘴角越靠下,mouth_corner_y越大,drop_ratio越大。
2.3中文绘制函数cv2AddChineseText
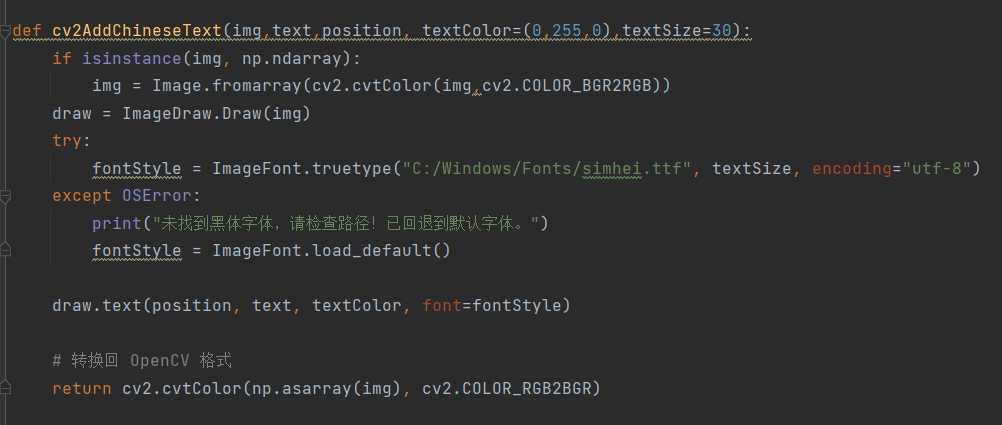
OpenCV自带的cv2.putText()不支持中文,所以这里用PIL绘制。
流程:1.OpenCV图像是BGR格式,先转成RGB。
2.用ImageDraw和黑体字绘制中文。
3.再转回OpenCV的BGR格式。
如果找不到黑体,会回退到默认字体,但默认字体通常不支持中文,可能显示方框。
2.4主程序流程
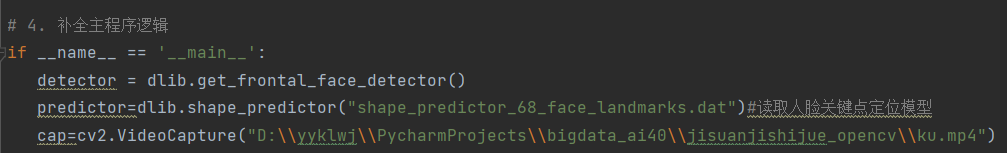
detector:dlib正脸检测器
predictor:68点关键点预测器。
cap:读取指定路径的视频。
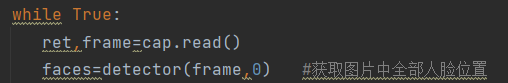
每次读取一帧,然后检测所有人脸。
第二个参数0表示不做上采样,速度快,但小脸可能漏检。
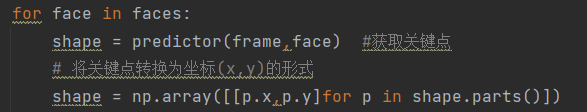
将dlib的关键点对象转成numpy坐标数组,形状为(68,2),每一行是(x,y)。
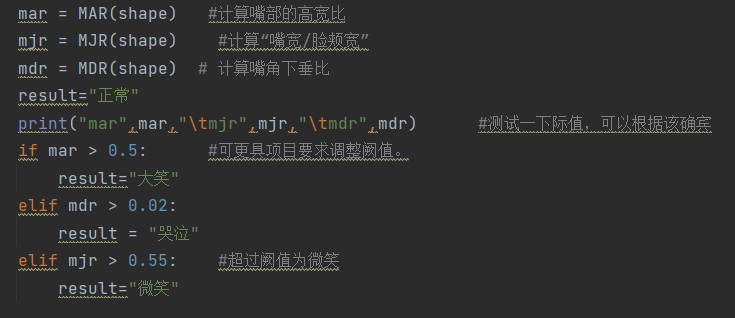
1.先判断大笑:MAR大于0.5.
2.再判断哭泣:MDR大于0.02.
3.再判断微笑:MJR大于0.55
4.都不满足则为正常。
2.5画嘴部凸包并添加中文标签
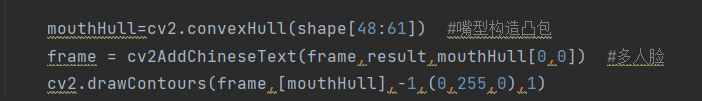
shape48:61取嘴部48到60号点。
cv2.convexHull计算嘴部凸包。
mouthHull0,0作为文字显示位置,通常是凸包第一个点。
cv2.drawContours画出绿色嘴部轮廓。
三、总结
它是一个入门级的计算机视觉表情识别示例,适合学习 dlib 关键点、OpenCV 视频处理和简单几何特征分类。实际项目中需要调整阈值、增加鲁棒性,并考虑使用更先进的表情识别模型。