(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:GE-Act 2.0: Pretraining and Scaling a World-Action Model for Robotic Manipulation
论文作者:智元机器人(AgiBot Research Team)
发表时间:2026年9月4日
本文要点
(1)GE-Act 2.0是智元机器人2026年9月发布的世界-动作模型,可训练的生成模块和动作模块在操作数据上从随机初始化训起。
(2)联合训练从300小时扩到30000小时,G1-OP零样本成功率从17.1%到44.1% ,G2-90D从13.4%到31.1%。
(3)做法上两点最值得看,CoAE把256乘384的一帧压成24个token,KASO只把和记录动作行为相容的预测未来拿去联合训练。
(4)短板在顺序指代,Pick和Place的Follow Score只有13.3%和26.7%;仿真LIBERO-Plus总分80.4,输给π0.5的84.4。
(5)项目页代码入口仍写Coming soon,文末只交代入口,没有可跑的推理示例。
智元机器人在2026年9月9日放出了GE-Act 2.0。技术报告9月4日挂上arXiv,编号2609.05588。我把HTML版报告和项目页对着读了一遍。
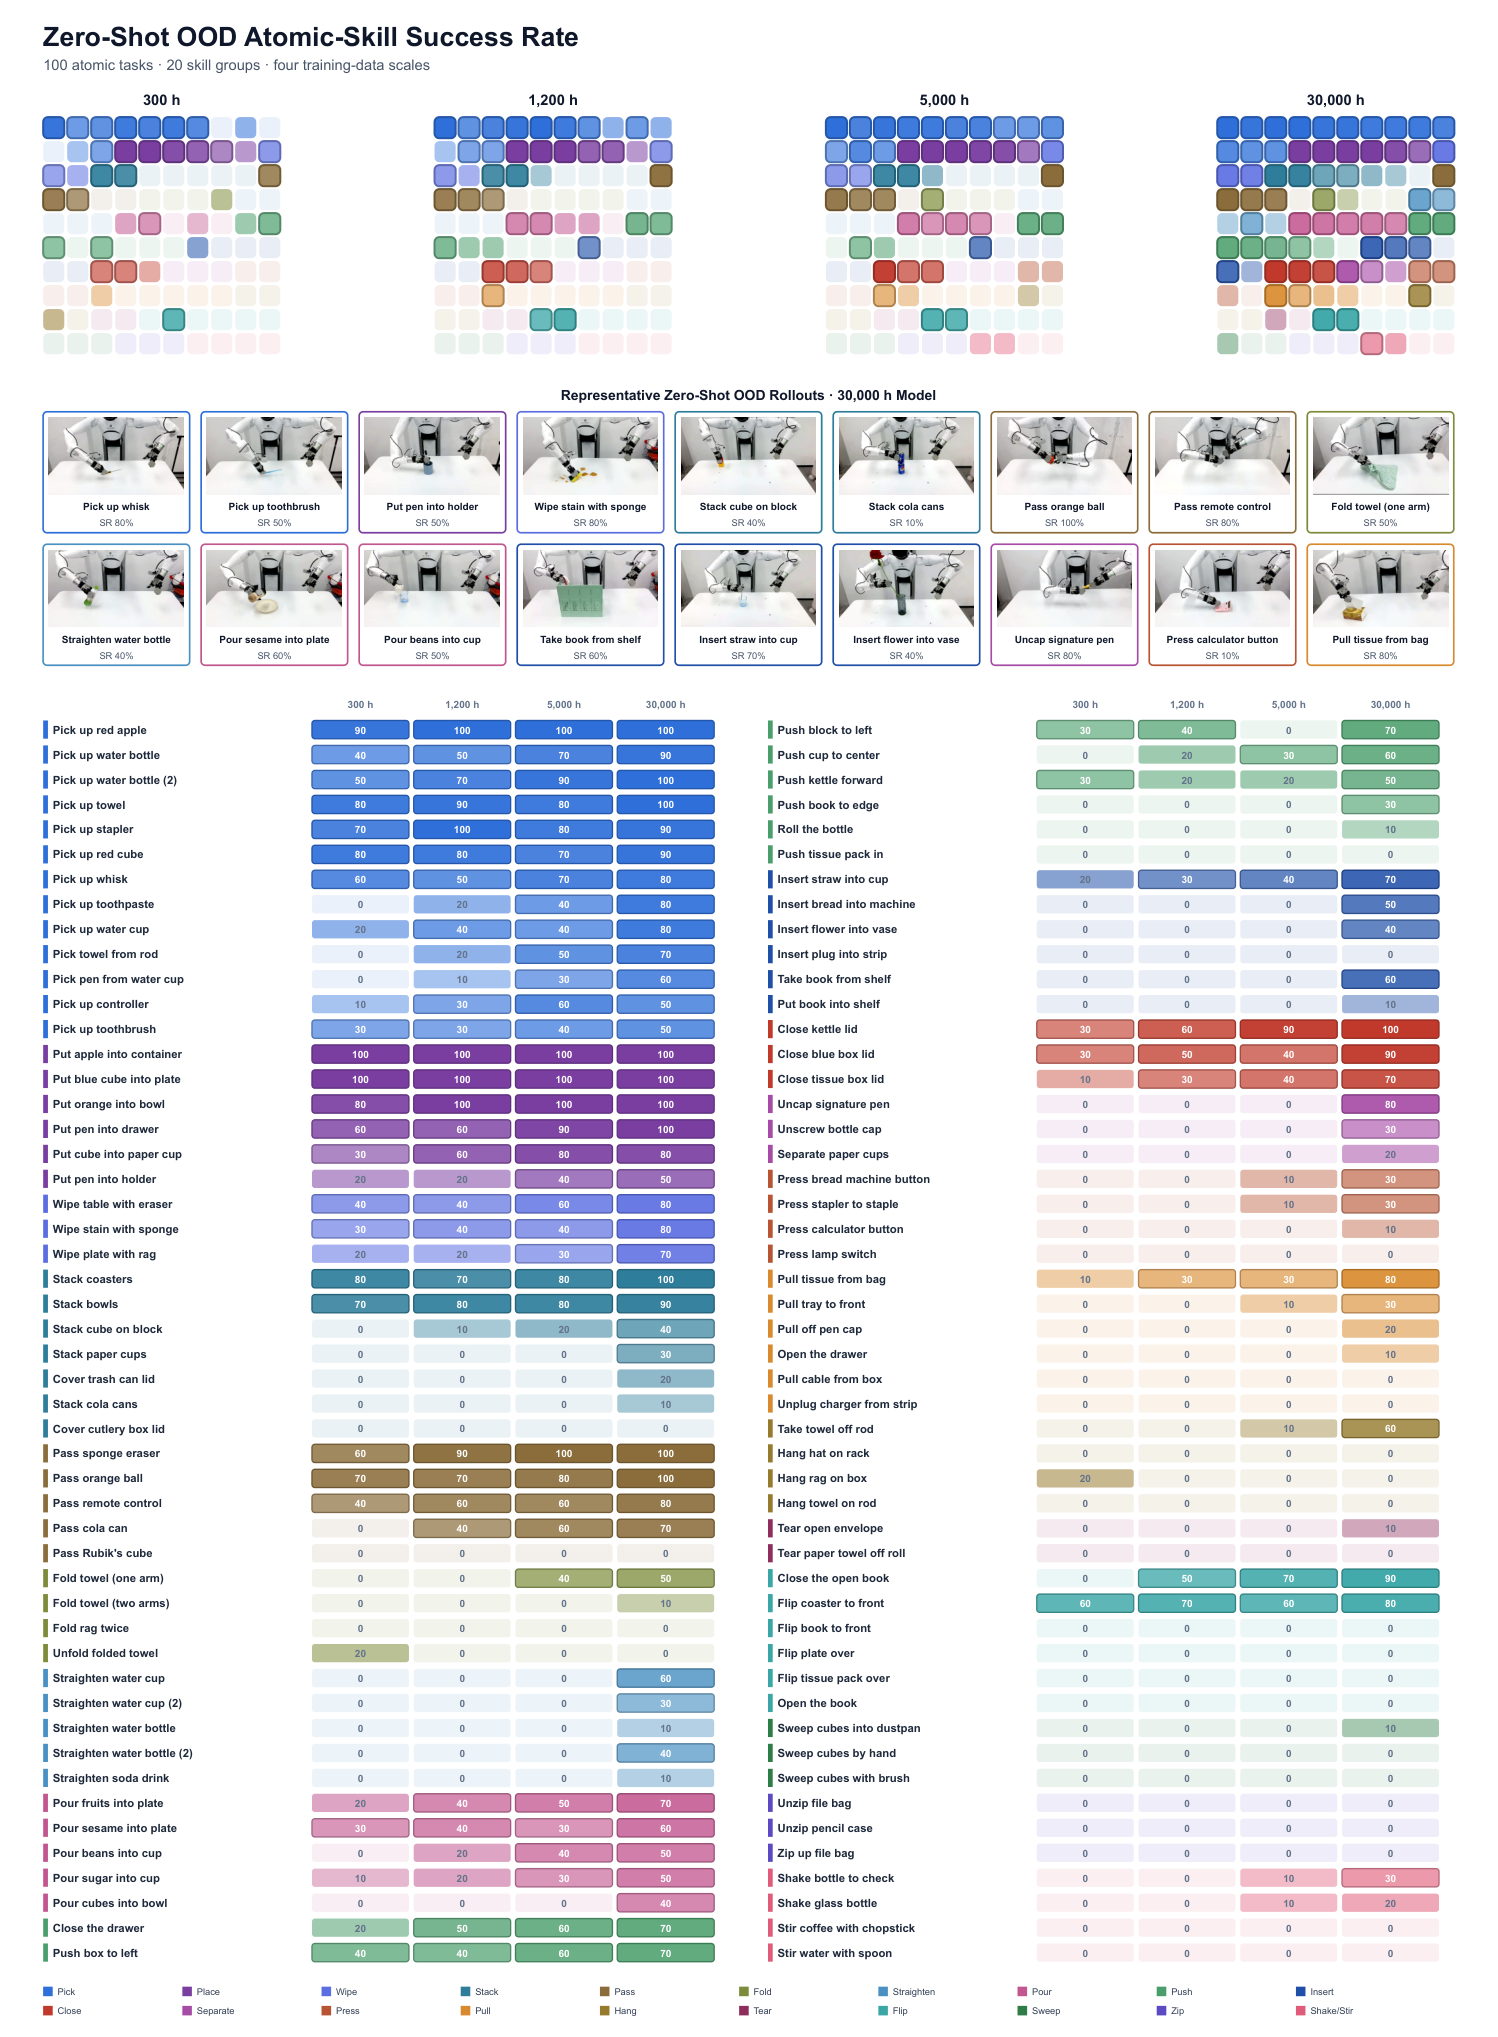
媒体抓住的是那组scaling数字。联合训练从300小时扩到30000小时,G1-OP上100项原子任务的零样本成功率从17.1%走到44.1%。截至9月16日,Hugging Face论文页有59个赞。
我更在意报告开头那句设定。现有世界-动作模型大多继承Wan、NVIDIA Cosmos这类预训练视频生成器,再把动作模块接上去。GE-Act 2.0把可训练的生成模块和动作模块全部放到操作数据上,从随机初始化开始训。业界常把1X的视频世界模型也算进这条继承路线,论文没有点名比较,点名的对照就是Wan和Cosmos。
一、继承预训练视频生成器的瓶颈
世界-动作模型先预测场景接下来会变成什么样,再用这个预测去生成动作。没有动作标注的视频,以及有动作、不一定有指令的机器人轨迹,都能喂进去。
现有做法通常先拿一个训好的视频生成器。潜空间来自普通视频自编码器,优化目标是画面重建,每个未来预测都要扛很密的token网格。生成又是多步去噪,动作损失要传回生成器,就得把整条去噪链留下来求导。
GE-Act 1.0、VPP、DreamZero因此改从生成器的中间特征里读动作。动作模块就绑在生成器内部表示上,没法单独拿失败尝试、部署回放这类有动作没指令的轨迹先训一遍。
二、CoAE、SVP与IDM模块衔接
三个模块按观察、预测、动作排开。
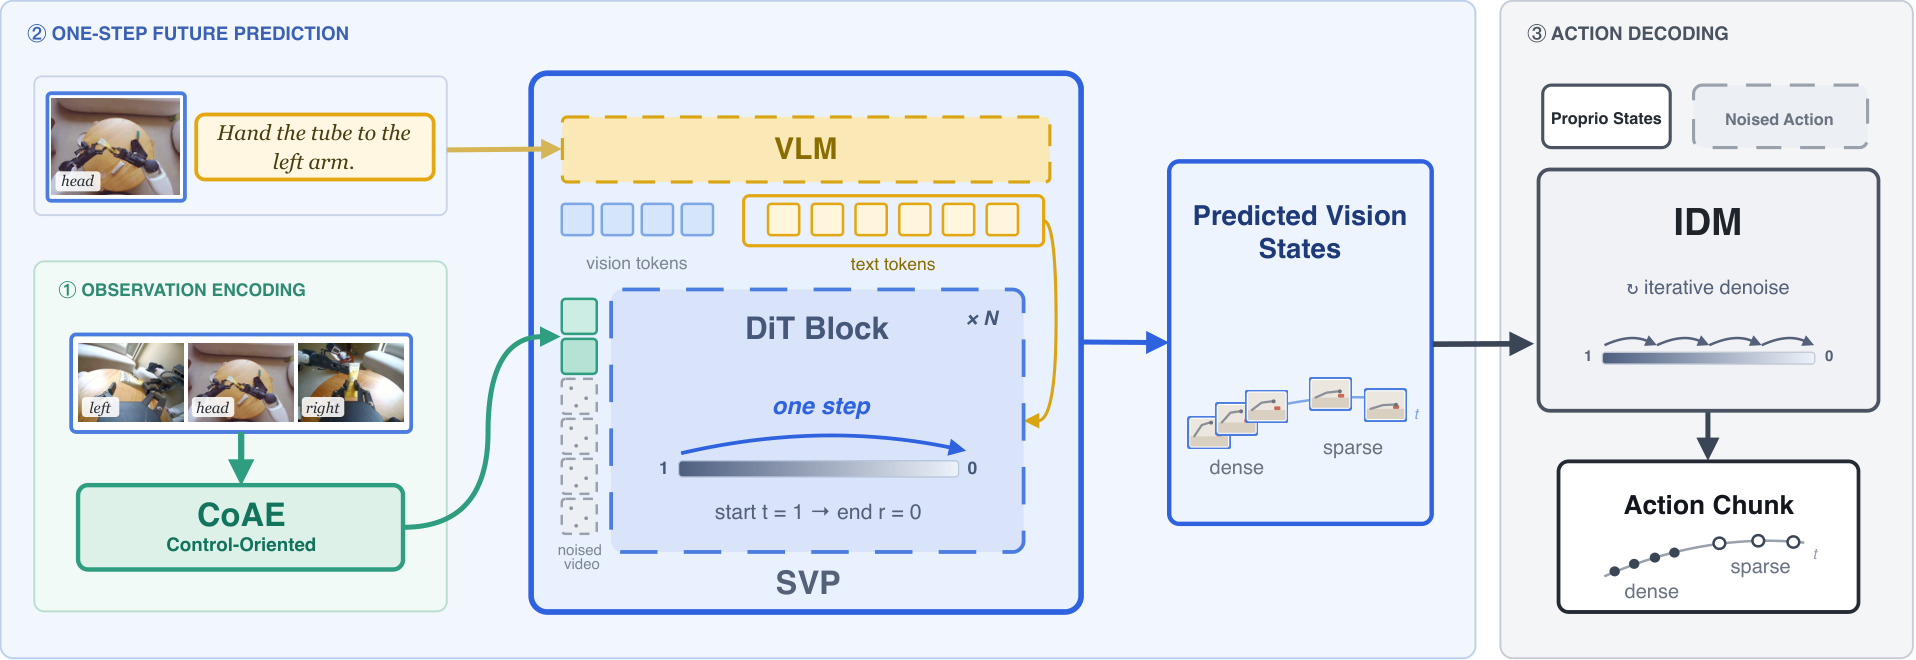
面向控制的自编码器CoAE把多视角相机画面压成短序列。单步视觉规划器SVP以当前潜变量和指令为条件,一次前向生成近期密集、远期稀疏的未来视觉状态。逆动力学模型IDM读当前潜变量、预测未来和本体感觉,输出动作块。
部署时机器人只执行密集段。稀疏动作只在训练里当辅助目标。
可训练部分里,SVP的流生成器2.51B ,IDM为0.56B。CoAE参数量未报告。冻住的Qwen3.5-2B有2.72B,不计入上面两个数。联合训练阶段流生成器和IDM继续更新,VLM和CoAE保持冻结。
三、一帧压缩24个token的CoAE
普通视频自编码器沿每个空间轴下采样8倍或16倍。CoAE用64倍,256乘384的一帧变成4乘6的网格,每格512通道,正好24个token。
它从128通道的DC-AE迁入兼容权重,再把通道扩到512,新参数随机初始化。CoAE本身有预训练起点。报告强调的从零,指的是后面那个流生成器和IDM。
重建之外另接三个特征匹配头,分别去贴冻住的SigLIP 2语义特征、V-JEPA 2.1运动特征、DINOv3密集结构特征。重建管得住能不能解码回图,三个头管的是压缩之后还剩不剩操作要用的信息。
他们冻住编码器,用同一个两层逆动力学探针做动作恢复。CoAE的动作MAE是0.01673,比DINOv3和V-JEPA 2.1高13%到31%,token数只有对方的十六分之一。指令匹配探针上准确率97.95%,五个表征里最高。
四、SVP单步规划与分轨预训练
SVP把多视角未来预测写成一次MeanFlow前向。给条件和一段噪声,完整的未来潜变量序列一次就能出来,并且可导。
这一步换来的是数据接口。SVP预训练用39000 小时带指令的视频,可以含没有机器人动作的自我中心视频。IDM预训练用32000小时带动作的轨迹,可以含失败尝试和部署回放。两套数据和后面规模实验里最大的30000小时联合训练池不是同一份。
指令接地交给冻住的Qwen3.5-2B,它看头部相机和文本。IDM不直接吃指令,语言只能通过生成出来的未来画面起作用。
五、KASO机制剔除与动作不相容的预测目标
同一场景、同一条指令,从左边拿杯子和从右边拿都可以算完成。示范只记录了其中一种。生成器独立采样,完全可能画出另一种合法未来。把这张未来和记录动作绑在一起训,画面和动作就不在同一个行为模态上。报告把这个错配叫做有效性缺口。把生成画面训得更像真,填不上这个缺口。
报告把这套选择方法叫做KASO。每个优化步让SVP先无梯度抽出4个候选,当前IDM在高噪声动作流上打分,只把和记录视频动作响应差最小的那一个带梯度重放,实现里k取1。比较发生在动作空间,背景动一动但行为一样的候选可以留下。
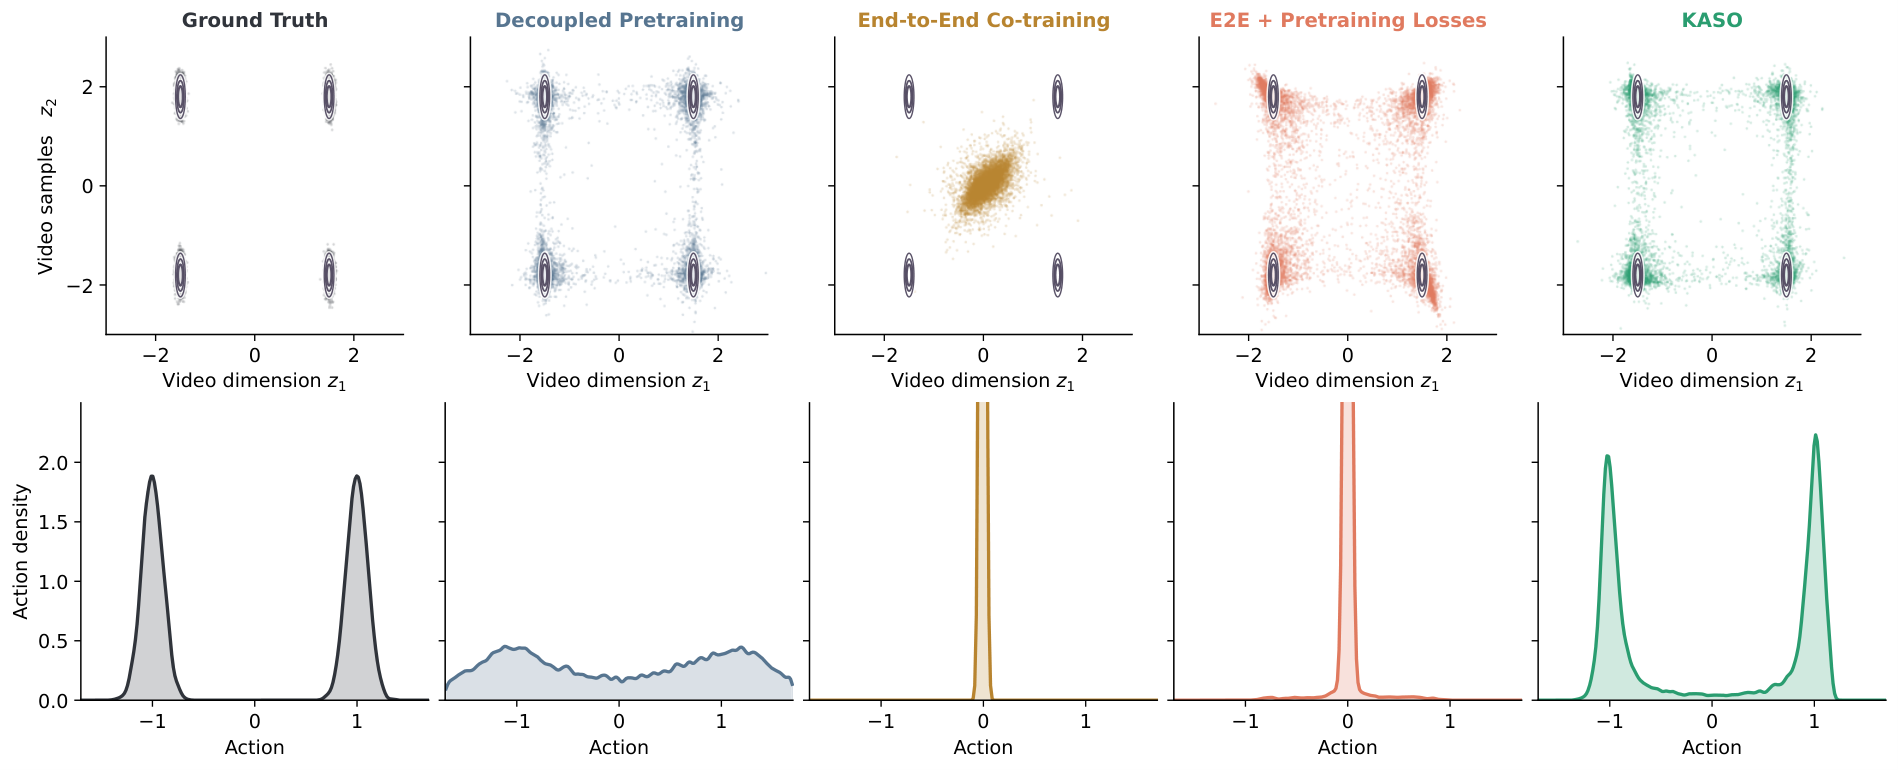
玩具系统里,端到端联合训练会把视频模态和动作分布一起压塌。补上预训练损失能保住四个视频模态,动作仍被回归到两个模态的均值附近。KASO把四个视频模态和两个动作模态都保住了。
真机消融是另一场受控实验。各方都从同一份全量预训练模块出发,只用300小时做连接阶段,其中30小时来自G2-90D,不能把它读成规模实验里那个300小时检查点。四物体场景里KASO和E2E+PT的跟随分都是95%,抓取成功率KASO是37.5% ,E2E+PT是22.5%。单物体小方块抓取从12%到40%。
六、G1-OP零样本从17.1%到44.1%
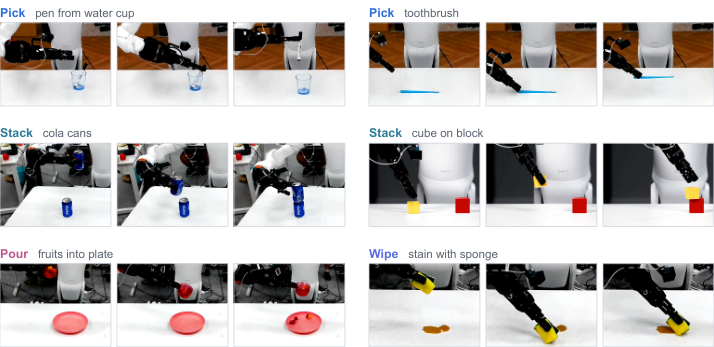
规模实验用四个嵌套的联合训练池,300、1200、5000、30000小时,预训练模块和配方相同。评测覆盖20类技能里的100项原子任务,G1-OP和G2-90D各跑一遍,每项10次试验。场景、背景、光照、物体实例都是训练没见过的,也不做任务微调。
G1-OP占联合训练数据一半以上,G2-90D不足2%。两台机器人完全不同,涨幅只在各自本体内部比。
| 联合训练时长 | G1-OP成功率 | G2-90D成功率 | G1-OP非零成功任务数 | G2-90D非零成功任务数 |
|---|---|---|---|---|
| 300小时 | 17.1% | 13.4% | 39 | 24 |
| 1200小时 | 22.6% | 21.0% | 未报告 | 未报告 |
| 5000小时 | 27.3% | 23.5% | 未报告 | 未报告 |
| 30000小时 | 44.1% | 31.1% | 76 | 72 |
5000小时再到30000小时仍在往上走,报告说测到的范围内没有饱和迹象。20类技能里,G1-OP有19类、G2-90D有18类在最大规模上高于300小时。
技能覆盖和成功率绑得很紧。去掉更简单的Close类,剩下19类的训练小时数和G1-OP在30000小时检查点上的成功率,Pearson相关是0.80,Spearman相关是0.85。擦拭有824.1小时,成功率76.7% 。清扫动作相近,只有64.6小时,成功率3.3%。扶正有510.5小时,5000小时之前一直是0.0%,到30000小时才到30.0%。
G2-90D自己的数据很少,最大规模下仍有10类技能不足5小时,4类不足1小时。共享语料变大以后,这个不足2%的本体仍涨了17.7个百分点,报告把这读成跨本体迁移的信号。
仿真是另一套口径。模型先在各基准指定的分布内条件上做SFT,再测留出的分布外条件。RoboTwin的Hard项拿到60.52%,比π0.5的47.90%高12.62个百分点。LIBERO-Plus总分80.4,低于π0.5的84.4,背景扰动只有60.5%。
七、细粒度指代评测与顺序短板
细粒度指代评测把动作限制在取和放,59条指令各5次,一共295次真机回放。物体类别、颜色、形状、位置这四维,取和放的Follow Score都不低于90.0%。尺寸掉到82.5%和65.7%。顺序是明显短板,取和放分别只有**13.3%**和26.7%。
295次总体Follow Score是83.1%,完整任务成功率72.9%。训练集里顺序描述只占0.13%,形状只占0.67%却仍有90.0%,频率解释不了全部差异。
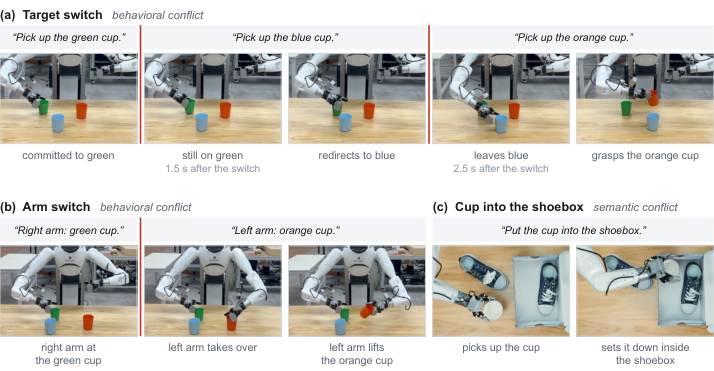
指令和当前行为打架的测试只有定性例子。夹爪已经靠近杯子A,指令改成B再改成C,机器会先残留一小段旧方向,随后转去抓最后那个目标。把杯子放进鞋盒这种例子里也执行了。报告写明这些只是示意。
八、代码与权重尚未开放
项目页写着Code Coming soon。我9月16日又看了一遍,代码和权重入口仍是即将开放,Hugging Face论文页也没有挂上关联模型。没有可跑的推理示例,这一节只交代入口,链接放在文末。
项目页还写了单张RTX 5090上从三路相机到一个动作块要104毫秒,对应30Hz下52步。论文部署节写的是SVP一次前向、IDM五步欧拉、每次先执行密集块的前30步,没有重复这条104毫秒。
九、总结与思考
不继承预训练视频生成器这件事,比44.1%这个数更值得看。100项任务里仍有24项一次都没成功,当成能用的通用操作策略还早。
对照实验的口径干净。同一套预训练模块,同一套配方,评测不做任务微调,四个规模嵌套着往上加数据。5000小时到30000小时还在涨,至少说明这条从零训起来的世界-动作模型,在他们测到的范围内还没有撞上墙。
短板也写在纸上。顺序指代几乎不会。LIBERO-Plus里背景扰动只有60.5%,π0.5有94.1%。报告把模型定位成System-1式的指令条件控制,没有任务分解和自我纠正。
CoAE从DC-AE迁了权重,指令接地用的是冻住的Qwen3.5-2B。说原生,要记得这两块不是随机初始化。代码和权重还没放出来,scaling这条曲线目前只能看报告,不能复现。
参考链接
- 技术报告原文 arXiv 2609.05588 v1,2026年9月
- 项目页,代码与权重截至2026年9月16日仍为Coming soon
- Hugging Face论文页 2609.05588
- 智元官方通稿 智元发布GE-Act 2.0,2026年9月9日
- 论文点名的对照路线 Wan视频生成、NVIDIA Cosmos
- 上一代 GE-Act 1.0 / Genie Envisioner