目录
[1. 研究背景](#1. 研究背景)
[2. 数据处理流水线](#2. 数据处理流水线)
[2.2. 视频过滤、分割与标注](#2.2. 视频过滤、分割与标注)
[2.3 统一动作空间和坐标系](#2.3 统一动作空间和坐标系)
[2.4. 统一多视角输入](#2.4. 统一多视角输入)
[3. VPP模型策略](#3. VPP模型策略)
[3.1 模型三阶段训练](#3.1 模型三阶段训练)
[3.2 VLM用于高级规划](#3.2 VLM用于高级规划)
[4. 实验以及结果](#4. 实验以及结果)
[4.1 视频预测质量分析](#4.1 视频预测质量分析)
[4.2 策略执行结果分析](#4.2 策略执行结果分析)
[5. 总结](#5. 总结)
论文:Video Prediction Policy 2: Predict Better, Act Better
机构:星动纪元、清华大学等
主页:Video Prediction Policy 2: Predict Better, Act Better
1. 研究背景
目前许多 WAMs 建立在视频基础模型之上,试图将视频模型中海量的物理动力学先验知识 (priors about physical dynamics) 迁移到策略学习中,但现有 WAMs 面临严重的泛化瓶颈:
-
分布外 (OOD) 表现差: 现有 WAMs 通常只在狭窄的已见任务集上表现良好,在未见过的、分布外的场景中会产生不可靠的未来运动预测,进而导致错误的动作。
-
基准测试暴露问题: 在标准评估套件上成功率近乎完美的机器人策略(包括 WAMs),在面对扰动任务配置和新技能组合时,性能会大幅下降
论文指出导致这些局限性的两个关键因素:
-
基础视频模型优化目标偏差: 基础视频模型主要针对创意内容生成和美学质量 进行优化,而非精确的物理动力学。因此,它们往往无法忠实遵循操作指令。
-
引入动作组件导致泛化退化: 将动作特定组件或训练目标引入预训练的视频基础模型中,会大幅降低其泛化能力。
为了解决上述问题,提出了 VPP2 (Video Prediction Policy 2),旨在视频预测和动作生成上实现强大的零样本泛化。其方法论分为三个核心步骤:
-
训练可泛化的视频基础模型 (Train a generalizable video foundation):
-
手段: 为每个视频片段标注详细描述(明确操作过程、活动末端执行器、目标物体)。
-
核心技术:事件级视频预测训练 (event-level video prediction training)。详细描述和完整的事件级轨迹预测能显著减少未来预测的不确定性,鼓励从语义描述到视觉轨迹的一致映射,从而提高泛化能力。
-
-
蒸馏单步视觉规划器 (Post-train & Distill):
-
后训练视频模型以预测固定视野的未来块 (fixed-horizon future chunks)。
-
应用一致性蒸馏 (consistency distillation) 技术,获得用于实时机器人执行的单步视觉规划器。
-
-
引入动作专家模块 (Introduce action expert):
-
采用混合Transformer (Mixture-of-Transformers, MoT) 架构。
-
学习一个隐式逆动力学模型,其条件是基于预测的未来。
-
执行阶段: 搭配一个 VLM 规划器,将开放式指令翻译成明确的子任务指令。
-
2. 数据处理流水线
2.1.视频来源与收集
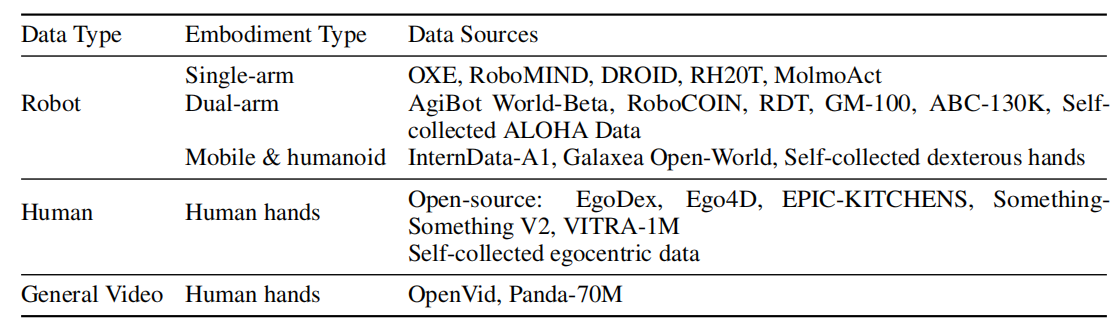
为了对开源视频基础模型进行持续的预训练,作者构建了一个大规模、多样化的操作视频集合。数据主要跨越三个类别:
-
机器人操作数据集 (Robot manipulation datasets): 真实的机器人执行任务的视频。
-
人类活动数据集 (Human activity datasets): 记录人类进行类似操作活动的视频。
-
通用视频数据集 (General-purpose video datasets): 互联网上的通用视频。
由于通用视频数据包含大量无关内容,作者应用了广泛的过滤流水线 (类似于 LVP 的方法),仅保留描绘与操作相关的活动的视频。
数据集来源如下表所示:
2.2. 视频过滤、分割与标注
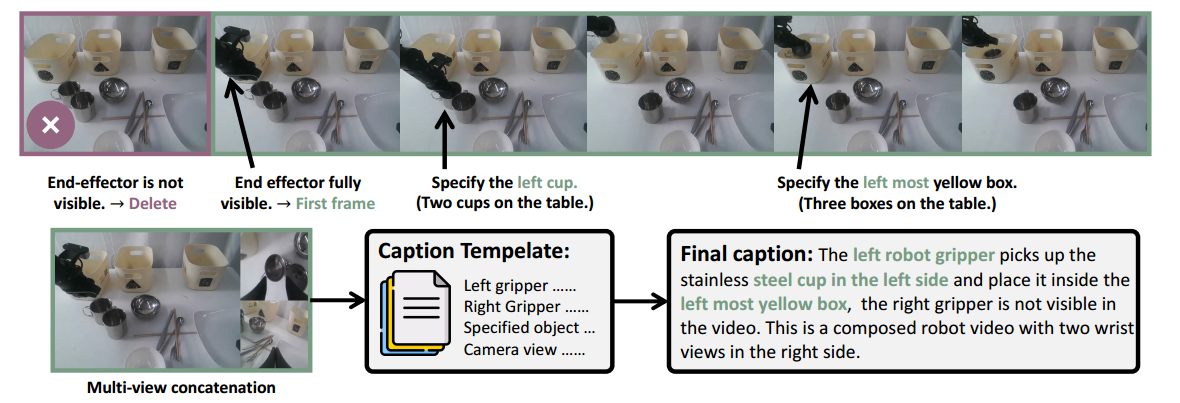
分为三个精细的步骤,旨在将原始长视频转化为适合模型训练的"事件级"片段:
- 过滤与初始分割 (Filtering & Initial Segmentation)
-
去除损坏数据: 首先剔除损坏的轨迹(如相机故障、突然的中断/不连续)。
-
语义连贯片段分割: 将剩余轨迹分割成1到12秒的语义连贯片段。
-
边界识别: 利用与自然过渡相关的启发式线索来识别片段的候选边界。这些线索包括:
-
人手或末端执行器速度的局部极小值 (local minima)(通常意味着动作的停顿或转换)。
-
夹爪或手指张开或闭合的时刻。
-
-
VLM 细化分割: 使用视觉语言模型 (VLM) 进一步细化分割结果。VLM 会合并相邻的合适片段,并调整片段的起始和结束点,以确保语义的完整性。
- 详细标注 (Captioning)
分割完成后,为每个视频片段生成详细的文本描述 (detailed captions)。这些描述必须包含以下关键信息:
-
描述任务: 正在执行什么操作。
-
明确活动末端执行器 (active end effectors): 是机械臂的夹爪,还是人手等。
-
明确目标物体 (target objects): 操作的具体对象是什么。
-
表征相机视角和运动 (characterize the camera views and motion): 视频的拍摄角度和镜头运动情况。
2.3 统一动作空间和坐标系
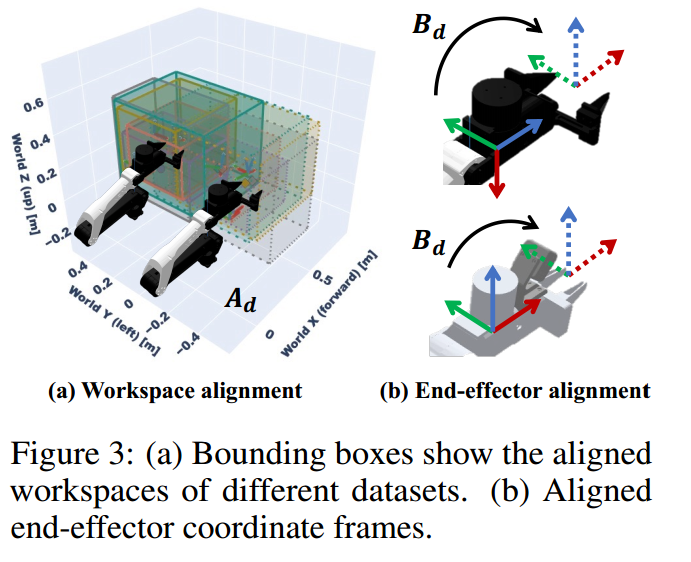
问题:不同的机器人数据集通常采用不一致的坐标系和相机视角。这导致视觉上相似的动作在不同数据集中有着完全冲突的动作表示
论文聚焦于自我中心的双臂数据集 (egocentric bimanual datasets)(包括 ALOHA 风格、人形风格和人类自我中心数据集)。这些数据占总数据的 80% 以上,且具有相似的双臂结构和相机视角。
为了统一这些数据,作者在两个层级上显式地对齐了坐标系:
-
工作空间对齐 (Workspace alignment):应用一个世界坐标系变换
-
末端执行器对齐 (End-effector alignment):应用一个局部变换
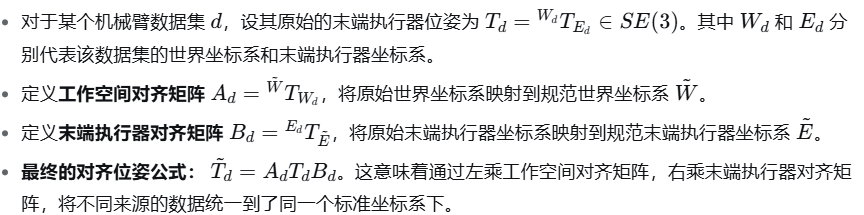
数学公式表达如下:
2.4. 统一多视角输入
作者将它们排列成一个 "T型复合图像 ",
-
主视角 (Primary view): 放置在左侧。
-
辅助视角 (Auxiliary views): 两个辅助视角垂直堆叠在右侧。
如果某个数据集提供的辅助视角少于两个,则使用黑色占位图 (black placeholder images) 填充缺失的槽位
3. VPP模型策略
-
基础模型: 建立在预训练的视频基础模型 Wan2.1-I2V-14B 之上。
-
架构: 采用混合Transformer (Mixture-of-Transformers, MoT) 架构引入动作专家 (Action Expert)。
3.1 模型三阶段训练
训练被组织为三个阶段(如图 4 所示),以最大化策略的泛化能力。
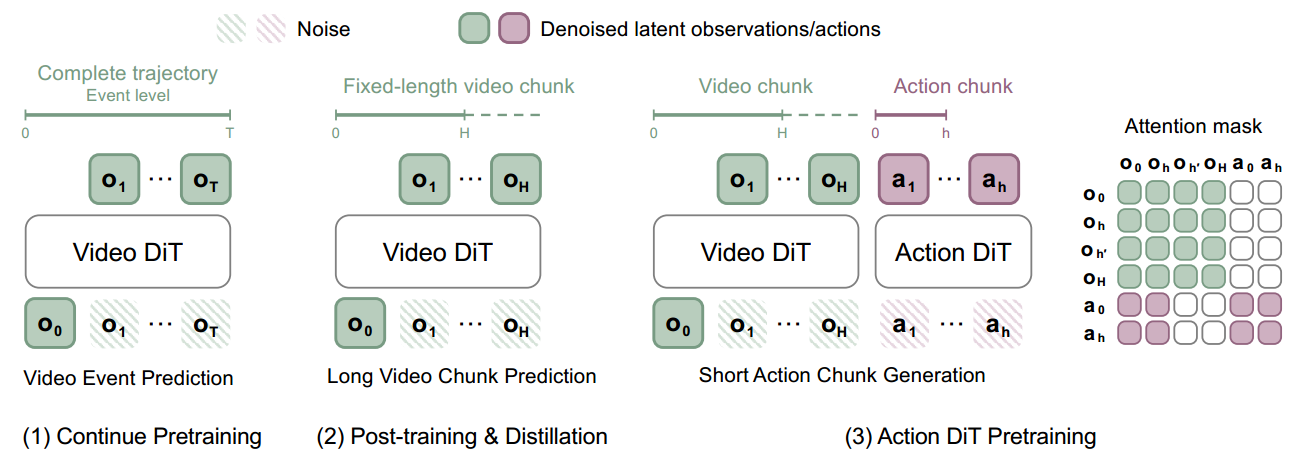
阶段一:事件级视频模型持续预训练
为了将预训练的视频生成模型适配到机器人操作领域, 每个训练样本覆盖一个完整的操作子任务 (manipulation subtask),将子任务描述与从初始观察到子任务完成的视觉演变对齐
给定演示轨迹 ,在整个事件中均匀采样 N个未来帧
其中,T是最终帧索引,使用视频编码器 E 获取潜在表示 ,构建插值潜在变量
优化目标是最小化预测流速与实际流速之间的误差:
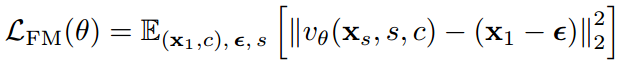
c 包括子任务指令和初始观测值O0
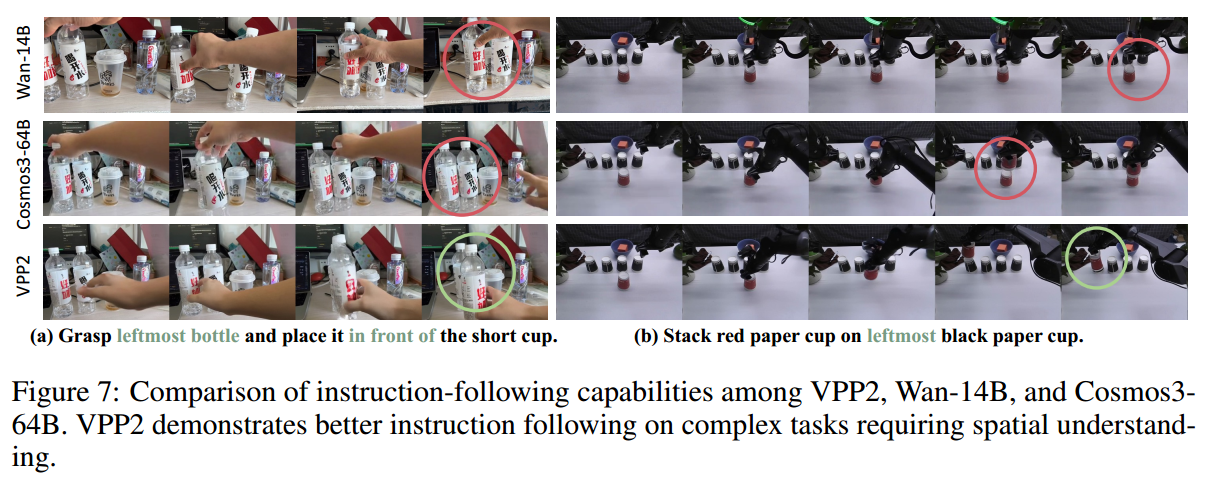
训练细节:预测 49 帧(分辨率 416x240),持续训练 30,000 步,批次大小 1,024,学习率 1e-5。实验表明,此阶段后的模型在遵循操作指令方面超越了 64B 的 Cosmos3 模型。
阶段二:块级视频模型后训练与蒸馏
阶段 1 虽然泛化好,但采样帧的时间间隔不固定,导致与下游动作对齐困难。阶段 2 旨在解决时序一致性和推理速度问题。
1. 块级视频模型后训练 (Chunk-level Post-training)
-
目的: 预测固定时长 (fixed-duration) 的未来视频块,建立一致的时间尺度。
-
设置: 人类手部操作预测 2 秒,机器人操作预测 8 秒。
-
数学表达: 设预测视野为 H 秒,数据集帧率为 f fps,则采样帧之间的标称间隔为 δ=f H/N。目标视频块为:
-
优化: 依然使用阶段 1 的流匹配目标,但现在的数据是固定时间间隔的视频块
2. 一致性蒸馏 (Consistency Distillation)
-
目的: 将块级视频模型蒸馏为单步生成 (single-step generation) 模型,以满足实时推理需求。
-
方法: 强制相邻流时间的终端预测保持一致性:
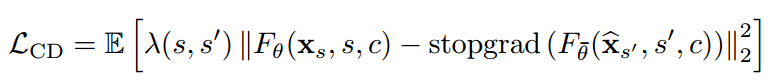
-
Fθ是学生模型,Fθˉ是教师模型(EMA参数)。
-
通过这种约束,学生模型学会了在单次前向传播中从噪声直接生成清晰的视频潜在变量 Fθ(ϵ,0,c)。
-
阶段 三:动作专家预训练
这是将视觉预测转化为实际机器人动作的最后一步
动作专家的预训练
- 数据基础: 使用经过前文所述"统一工作空间和末端执行器坐标系"处理过的双臂数据集
- 架构 :一个 0.9B 参数 (0.9B-parameter) 的扩散 Transformer,采用标准的混合 Transformer (MoT) 架构
- 条件机制: 动作专家的生成条件是单步视频潜在变量
- **注意力掩码 (Attention Mask):**它允许视频 token和动作 token之间进行特定的交叉注意力计算,确保动作生成能够充分利用视频预测的上下文信息。
- 训练策略: 因为动作专家是新初始化 的,所以在动作训练的早期阶段,冻结视频 DiT 的基础参数,仅使用LoRA 微调来适配视频骨干网络
推理延迟: 将视频输入分辨率降低至 17×416×240,并利用阶段 2 蒸馏出的单步生成 (one-step generation) 模型,视频模型生成耗时:约 0.12 秒; 动作专家生成动作块(基于视频潜变量,5 步去噪):约 0.1 秒;每个动作块的总延迟:约 0.22 秒。
总结:
- 阶段 1 : 通过海量事件级数据,让视频模型理解操作任务的物理规律和语义(强泛化)。
- 阶段 2 : 通过固定时长后训练和一致性蒸馏,让模型具备实时预测长视野未来的能力(高效率)。
- 阶段 3 : 训练动作专家,基于视频模型的单步预测结果,直接输出可执行的动作块(强执行)
3.2 VLM用于高级规划
采用分层架构, VLM充当高层规划器,将模糊的人类指令 拆分为明确子任务指令,专注于将明确的指令映射为轨迹 (trajectories)。
同时,VLM 规划器不仅要输出子任务,还要生成与训练时使用的标注模板相匹配的详细子任务描述。
VLM 可以本地部署,也可以通过 API 调用前沿的大模型(如 GPT-4V 等)
4. 实验以及结果
4.1 视频预测质量分析
定量比较与基线模型
-
Wan-2.1-I2V-14B-480p: VPP2 的基础模型。
-
LVP: 同样将 Wan-2.1-I2V-14B-480p 适配到操作任务的模型。
-
Cosmos3-Nano-16B: 在机器人操作数据上广泛训练的模型。
-
Cosmos3-Super-Image2Video-64B: Cosmos 3 系列中最强的模型(64B参数)。
-
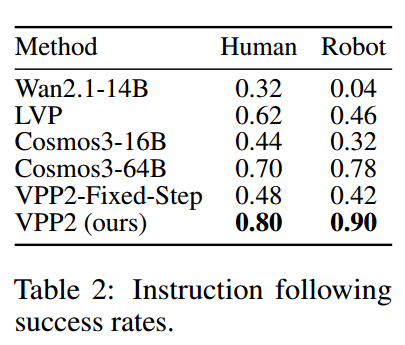
VPP2-Fixed-Step (消融实验): 预测固定时长的未来块,而不是完整的事件(Event)。作者指出,这种方法可能会导致预测的未来与描述整个事件的指令错位。
测试方法: 从先前的工作中随机抽取测试用例,在办公环境和机器人工作空间 中拍摄照片,并搭配自由选择的操作指令,分析模型视频预测的指令遵循成功率
评估方法:GPT 评估器、人类评估者
结果如下所示:
4.2 策略执行结果分析
真实世界 ALOHA 机器人的零样本性能
实验设置:
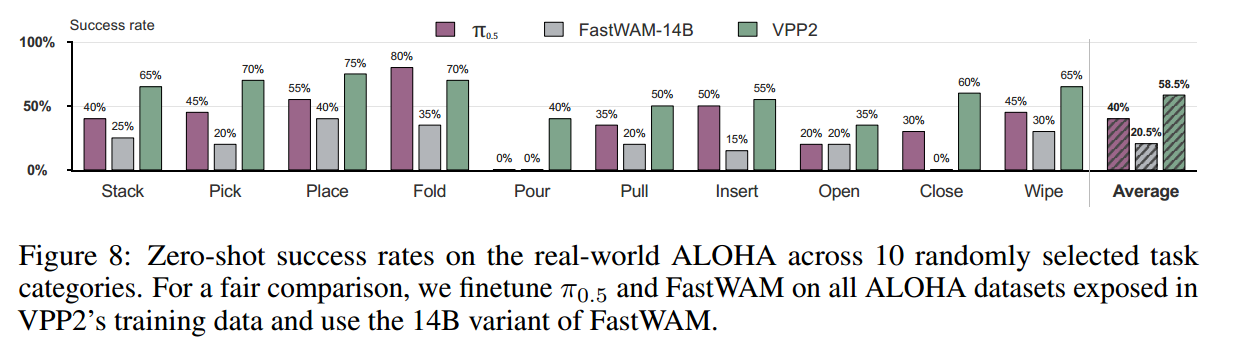
-
直接将 VPP2 部署在训练期间见过的机器人本体(ALOHA)上,无需任何特定任务的微调 (without task-specific fine-tuning)。
-
对比基线: 在相同数据上训练的 π0.5π0.5 (Intelligence et al., 2025) 和 Fast-WAM (Wan-14B 版本)
VPP2 在真实世界的零样本操作任务中具有压倒性优势
LIBERO 基准测试
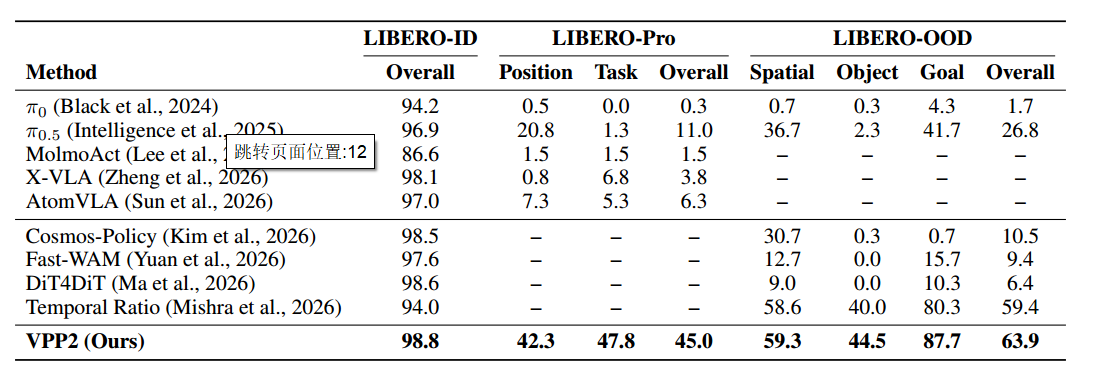
作者在标准的 LIBERO 仿真基准上进行了测试,在三种不同条件下评估
-
LIBERO-ID (分布内): 测量标准的分布内操作性能。
-
LIBERO-Pro (分布外泛化): 评估位置 (Position) 和任务 (Task) 扰动下的泛化能力。
-
LIBERO-OOD (组合泛化): 评估在空间、物体和目标维度上重新组合已知元素形成未见任务配置的能力。
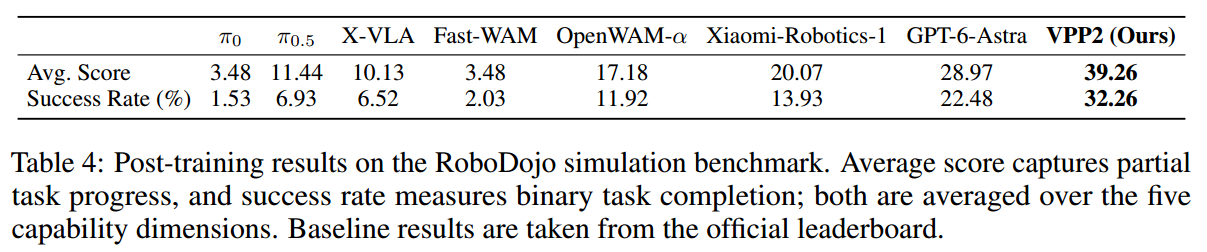
RoboDojo 基准测试
测试结果如下
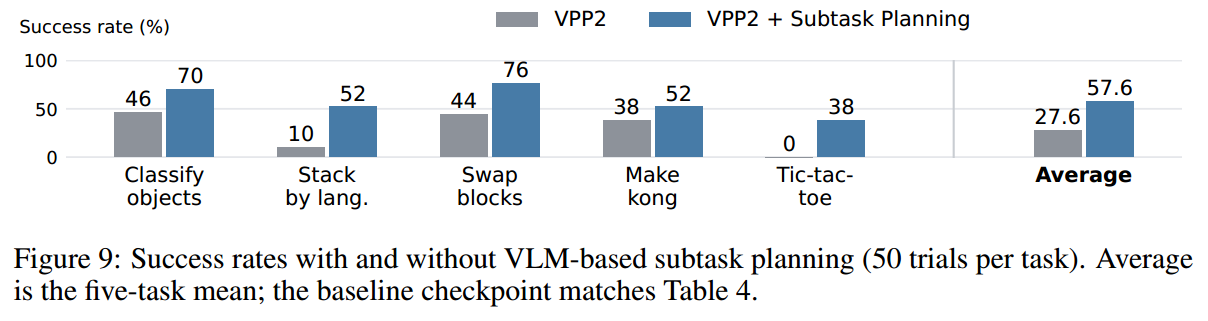
结合子任务规划的 VPP2
作者进一步探索了 VPP2 与 VLM(视觉语言模型)结合的潜力,
-
训练: 将演示轨迹分割成片段,并将每个片段与一个子任务指令配对,训练出"子任务条件策略"。
-
测试: VLM 利用视觉观察和执行反馈来选择下一个让 VPP2 执行的子任务。
5. 总结
引入了视频预测策略2(VPP2),这是一种WAM,能够实现在视频预测和动作生成方面的强大零样本泛化。
整个流程如下:
(1)事件级视频预训练: 整理了一个大规模、多样化的操控视频数据集,以继续对基础视频模型进行预训练。我用详细的描述标注视频片段,并进行事件级视频预训练,以促进在开放式操控任务上的泛化能力。
(2) 单步视觉规划: 对视频模型进行训练后处理,并将其蒸馏为一个具有固定预测时域的单步视觉规划器。
(3) 动作学习:通过混合专家(MoT)架构引入动作模块,以学习隐式逆动力学模型。