屏幕上一张热力图,蓝底上一团红,看着非常"科学"。
但你有没有想过一个问题:那团红色到底有多大?
不是"屏幕上多大"------是地面上多少公里。你把"画布宽度"从 1000 拖到 2000,画面几乎没变(还是那团红),可它的物理尺寸缩到了原来的一半。你把地图往北拖一点,同一个圆斑,南北向被拉长了 30%。这些都不是渲染 bug,是那三行算画布尺寸的代码决定的。
前面几篇我们一直在三维特效里量账,这次换个方向,到数据分析这条线里,量一笔更朴素、也更容易被忽略的账:一个热力半径,究竟等于几公里。
我是 Cesium酱,一只在 WebGIS 领域摸爬滚打多年的前端猿。这个系列写到第 51 篇,规矩一直没变:只要面板上有数字,就得拿进几何里对一遍账。而这篇文章的账,恰恰是所有"数据可视化"类面板的通病------滑块上写的是"热力半径 70",没人告诉你这个 70 的单位是像素。
本文目标:把一个热力图从「一行数据」到「屏幕上一团颜色」之间的每一笔账拆开算清------哪个点会被悄悄丢掉、圈出来的到底是圆还是椭圆、为什么密度永远到不了满、以及那个会自己往上爬的滑块。💪
💡 本文涉及的全部代码均已开源,完整的仓库地址见文末,可自行取用、随意魔改。
一、痛点与场景:为什么「一团颜色」也需要对账?
🎯 背景现状:热力图是最常见的空间数据表达方式之一------它不画精确的边界,只传达"这里比较热"。正因为"差不多就行",它身上的参数最容易被当成感觉量来调:拖到"看着舒服"就收工,没人去管它对应的物理尺度。
- 🎯 点位告警密度:某个区域短时间内的告警点位扎堆,用热力图看聚簇
- 🎯 客流/车流热度:从采样点反推人流密度,做运营决策
- 🎯 设备负载分布:基站、充电桩、传感器的负载值铺成一张面
- 🎯 POI 热度:搜索热度、点评数量,做选址参考
🤦 传统痛点:热力图的实现路线很多,但每条都有一个不太好说出口的硬伤。
| 方案 | 问题 |
|---|---|
| 直接画彩色圆点 | 只表达"点",不表达"面";点一多就糊成一坨,谁热谁冷看不出来 |
| 每个点画一层带透明度的圆,叠起来 | 叠得越多越深,但叠到一定程度就分不出 10 个点和 100 个点 |
| 引入成熟的 heatmap 库 | 依赖一套渲染管线,和 Cesium 的坐标系之间还得多套一层转换 |
| Cesium 自带的图元 | 没有热力图;得自己把数据变成一张图,再想办法贴上去 |
💡 本文方案 :不引第三方库,就在离屏 canvas 上手工把密度"算"出来,再当纹理贴到 Rectangle 上。三件事:
1️⃣ 生成数据:用可复现的伪随机,把点撒成四种典型分布(聚簇 / 带状 / 环形 / 核聚),保证同一 seed 永远同一张图
2️⃣ 渲染密度 :每个点画一个带渐变的圆盘,用 globalAlpha 记归一化值,靠 canvas 的 source-over 自然累加成密度场
3️⃣ 上色贴合 :把灰度密度按 alpha 查一条 256 色的色带,转成 dataURL,交给 ImageMaterialProperty 贴到矩形上
✨ 一句话总结:把「密度」当成一张灰度图,用 canvas 的合成能力当累加器,再把灰度写成颜色"翻译"成一张纹理------整条链路里没有一个参数带单位,这就是所有账的起点。
二、核心技术原理:一笔热力账的三层换算
2.1 数据结构:四个场景,一个种子
先看数据是怎么来的。它不读文件、不请求接口,四个场景全是现场生成的------但生成的方式是确定性的。
ts
// 源码级剧透:heatmap-data.ts
export type HeatmapScene = {
  id: string
  label: string
  bounds: Bounds          // west / south / east / north(经纬度)
  defaultRadius: number   // 面板上的「热力半径」默认值
  pointCount: number
  description: string
}

export type SceneData = {
  points: HeatPoint[]     // { x: 经度, y: 纬度, value: 0~1000 }
  valueMin: number
  valueMax: number
}四个场景的差别只有一行公式(mode)我列一下,后面量账会反复用到:
- 🔵 beijing-clusters(北京多中心) :三个随机核心,各撒高斯噪声;
value = 500 + |g| × 250 + rand × 250 - 🟢 shanghai-band(上海沿江带状) :
lat沿中心线高斯抖动,value随经度成正弦波动(0~900) - 🟡 guangzhou-ring(广州环形) :极坐标撒在环带半径 0.28~0.52 之间,
value带三次谐波起伏 - 🔴 chengdu-core(成都核心聚集) :单一中心高斯聚簇,
value = 600 + |g| × 200 + rand × 200
ts
function seededRandom(seed: number): () => number {
  let state = seed >>> 0
  return () => {
    state |= 0
    state = (state + 0x6d2b79f5) | 0
    let t = Math.imul(state ^ (state >>> 15), 1 | state)
    t = (t + Math.imul(t ^ (t >>> 7), 61 | t)) ^ t
    return ((t ^ (t >>> 14)) >>> 0) / 4294967296   // 🌰 mulberry32:同一个 seed → 同一个 [0, 1)
  }
}

function gaussian(random: () => number): number {
  let u = 0
  let v = 0
  while (u === 0) u = random()
  while (v === 0) v = random()
  return Math.sqrt(-2 * Math.log(u)) * Math.cos(2 * Math.PI * v)   // 🌰 Box--Muller 变换
}
🔑 关键点说明:
seededRandom是 mulberry32,位数运算 + 位异或,几十毫秒就能吐出十万个数- 注意
while (u === 0)这两行:Box--Muller 里Math.log(0)是-Infinity,while反复抽直到抽到非零------这是这套代码里唯一一处"不确定循环多少次"的地方,理论上可以死循环(概率为 0) - 面板上那个「随机生成」按钮,干的事就是
randomSeed.value = Math.floor(Math.random() * 1e9)------换种子,不换公式 - 页面初始的 seed 是 20260827。本文后面所有数字都是在这个 seed 下量出来的,你自己跑一遍应该能对上
2.2 完整技术路线
我们设计的完整技术路线:
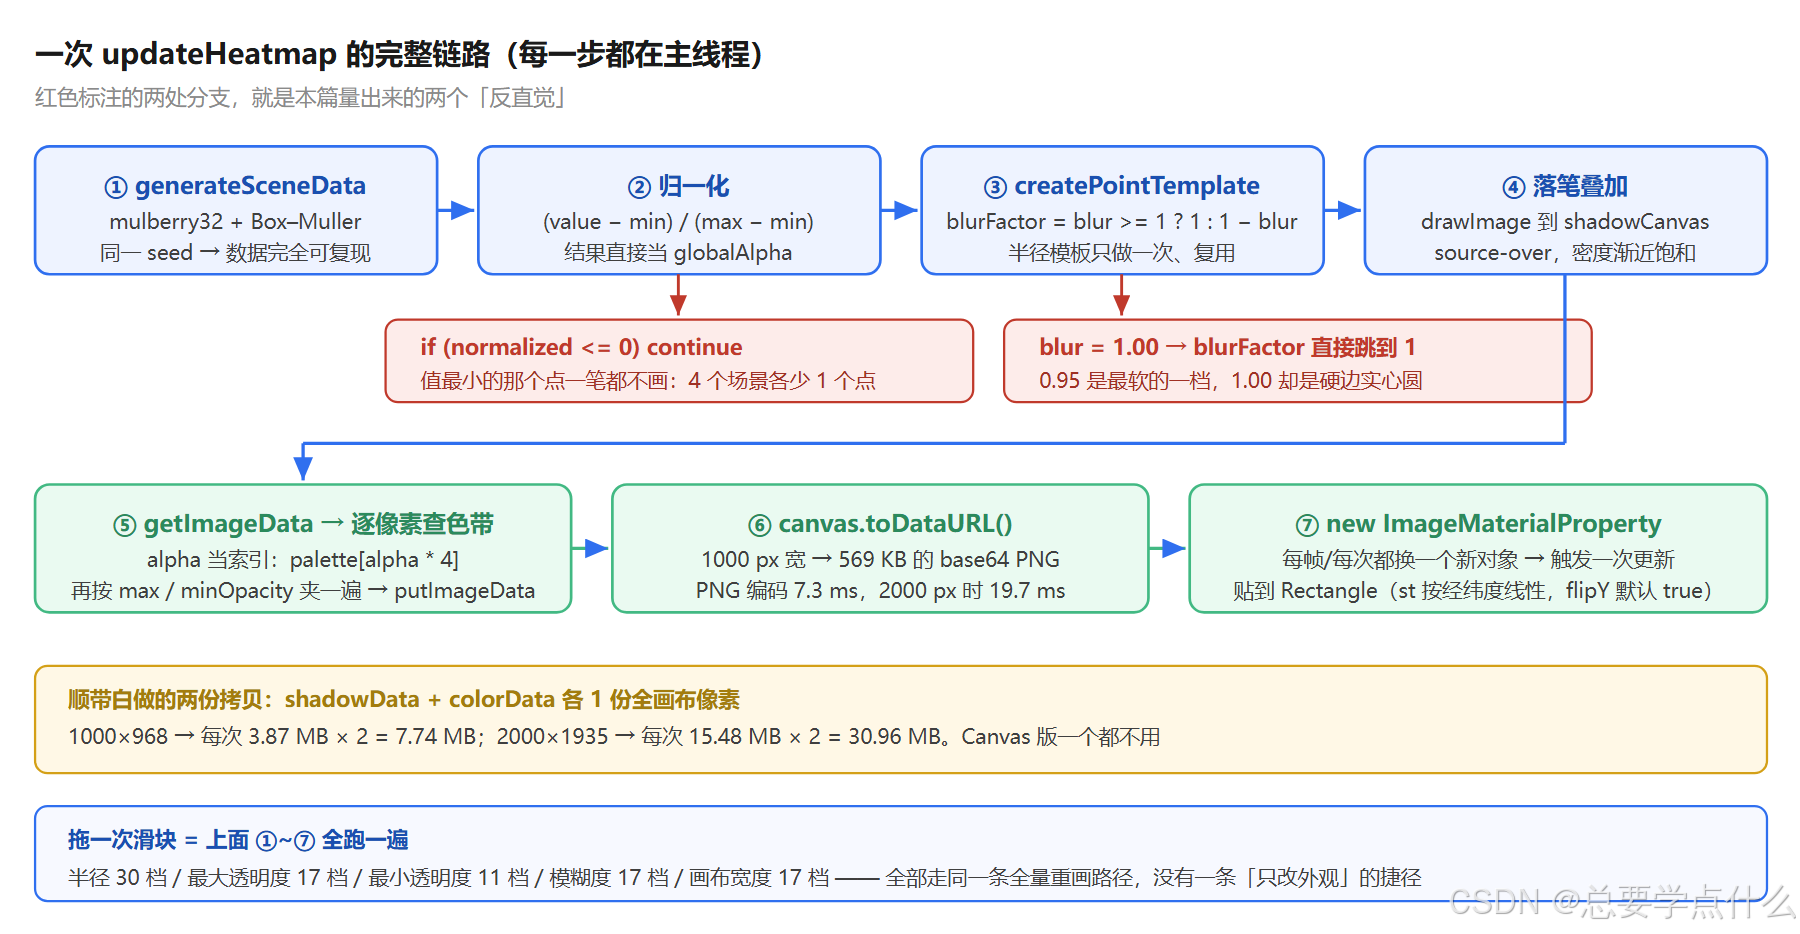
核心亮点:第 ③ 步 createPointTemplate 和第 ⑤ 步「逐像素查色带」是本文的两把刀 🔪 ------前者决定了笔刷长什么样,后者决定了这张图最终"好看不好看"。而这条链路上最反直觉的两处,一处藏在第 ③ 步的 blurFactor,一处藏在第 ② 步的 continue。
2.3 为什么用 Canvas 而不是着色器
| 方案 | 原理 | 性能 | 复杂度 |
|---|---|---|---|
| GLSL 后处理 | 把每个点当片元,GPU 里逐像素叠加 | ⚡ 十万点也不喘 | 🔴 高:得自己搭 FBO、传 uniform 数组 |
| Canvas 手动叠加 | 每个点画一个圆盘,靠 source-over 累加 |
🐢 千点级还行(本机 1000 px 约 10.6 ms) | 🟢 低:几行 drawImage |
| WebGL 粒子 | 每个点一个 quad,加法混合 | ⚡ 快 | 🔴 高:还得处理颜色映射回读 |
| 服务端出图 | 后端渲染好 PNG,前端只贴图 | 🐢 网络往返 | 🟡 中:但交互(拖半径)就废了 |
简单说:热力图的点数通常只有几百到几千,Canvas 的合成能力绰绰有余;而"拖一下滑块立刻重画"这个交互,恰恰是 GLSL 那条路最不划算的地方。 用 Canvas,是为了让参数调整保持在"重跑一个几十毫秒的函数"这个量级。
三、代码实战:关键实现拆解
⚠️ 温馨提示 :本文只拆 heatmap-canvas 这一个案例(Canvas 版)。仓库里还有热力图的三维版,那是另一套坐标系和另一篇文章的事。另外,本文所有耗时数字都是**本机无头浏览器(软件渲染、--disable-gpu)**跑出来的,绝对值会比你的真机慢,但相对关系是准的。
3.1 归一化:为什么最小值那个点一笔都不画
拿到点之后,第一件事是把它压到 [0, 1]。
ts
const values = points.map((point) => point.value)
const dataMin = options.min ?? (values.length ? Math.min(...values) : 0)
const dataMax = options.max ?? (values.length ? Math.max(...values) : 1)
const min = Math.min(dataMin, dataMax)
const max = Math.max(dataMin, dataMax)
...
for (const point of points) {
  const value = Math.min(point.value, max)                        // ⚠️ 只夹了上界
  const normalized = max > min ? (value - min) / (max - min) : 0
  if (normalized <= 0) continue                                   // 🔑 值等于 min 的点,直接跳过
  shadowContext.globalAlpha = normalized
  shadowContext.drawImage(template, x - radius, y - radius)
}
🔑 关键点说明:
<和<=的分界点,正好落在数据里最大的那个"最小值"上。 自动范围时min就等于数据的最小值,于是必然有至少一个点的normalized恰好是 0,被continue跳过。四个场景实测各少一个点:
| 场景 | 点数 | 实际落笔 | 被跳过 |
|---|---|---|---|
| 北京多中心 | 120 | 119 | 1 |
| 上海沿江带状 | 100 | 99 | 1 |
| 广州环形 | 80 | 79 | 1 |
| 成都核心聚集 | 60 | 59 | 1 |
北京场景实测 valueMin = 511.28、valueMax = 1000.00------被跳过的正是那个 511.28 的点。
- 如果数据里有并列最小值,跳过的就不止一个。 本猿另造了一组 10 个点、其中 5 个值都是 100 的数据:实测落笔 5 个、跳过 5 个。把固定下界手动设成 90,落笔立刻回到 10 个。
Math.min(point.value, max)只有上界、没有下界 ------配合那个continue,就意味着固定范围的下界一拉高,低值点不是变淡,而是整点消失。实测(同一个 seed):
| 场景 | 引擎 min/max | 落笔 | 消失 | 消失占比 |
|---|---|---|---|---|
| 北京多中心 | 自动范围 | 119 | 1 | 0.8% |
| 北京多中心 | 600 ~ 1000 | 111 | 9 | 7.5% |
| 北京多中心 | 800 ~ 1000 | 57 | 63 | 52.5% |
| 广州环形 | 600 ~ 1000 | 62 | 18 | 22.5% |
| 广州环形 | 800 ~ 1000 | 23 | 57 | 71.3% |
这个行为在业务上通常是反的:你拉高下界,本意是"让低值不要那么显眼",结果它把低值整个抹掉了。地图上直接少掉七成的点,而面板上「数据点数」那栏还理直气壮地写着 80。
- 还有一处只夹上限 带来的副作用:
clampValue(value, 0, 1000)把value压到 1000 封顶,而自动范围的max又恰好取到这同一个 1000。北京 120 个点里,有 19 个被压到 1000(15.8%) ,它们的normalized全是 1.000------也就是说,这 19 个点在画面上完全等价,一个比一个深都没有。数据分布的那点层次,在封顶的一瞬间就没了。
3.2 画布尺寸:按「度」算,不按「米」
这一步只有三行,但它是整篇文章最值钱的三行:
ts
const width = Math.max(8, Math.round(options.canvasWidth ?? 1000))
const height = Math.max(8, Math.round(
  (width / Math.max(bounds.east - bounds.west, 1e-6)) * Math.max(bounds.north - bounds.south, 1e-6)
))
// 🔑 宽高比 = 经度跨度 : 纬度跨度,两边都是「度」
🔑 关键点说明:
- 这个式子保证的是**"每像素代表多少个度"在两个方向上都一样**。它保证不了"每像素代表多少米"一样------因为 1 度纬度 ≈ 111.32 km,1 度经度 ≈ 111.32 × cos(纬度) km。
- 所以画布上的正圆笔刷,落到地面上必然是个椭圆 :南北向被拉长
1 / cos(纬度)倍。写对这条式子应该长这样:height = width × (latRange × 111.32) / (lonRange × 111.32 × cos(lat)),约掉 111.32 之后,分母上还差一个cos(lat)。 - 实测四个场景的每像素米数:
| 场景 | 中心纬度 | 每像素东西向 | 每像素南北向 | x / y | cos(纬度) | 偏差 |
|---|---|---|---|---|---|---|
| 北京多中心 | 39.90° | 265.09 m | 344.11 m | 0.77037 | 0.76717 | 0.32 个百分点 |
| 上海沿江带状 | 31.25° | 142.88 m | 166.25 m | 0.85945 | 0.85491 | 0.45 个百分点 |
| 广州环形 | 23.05° | 122.98 m | 132.85 m | 0.92575 | 0.92016 | 0.56 个百分点 |
| 成都核心聚集 | 30.70° | 95.80 m | 110.86 m | 0.86413 | 0.85985 | 0.43 个百分点 |
比值和 cos(纬度) 对得很好(余下那零点几个百分点来自 WGS84 子午圈与卯酉圈半径本来就不同)。
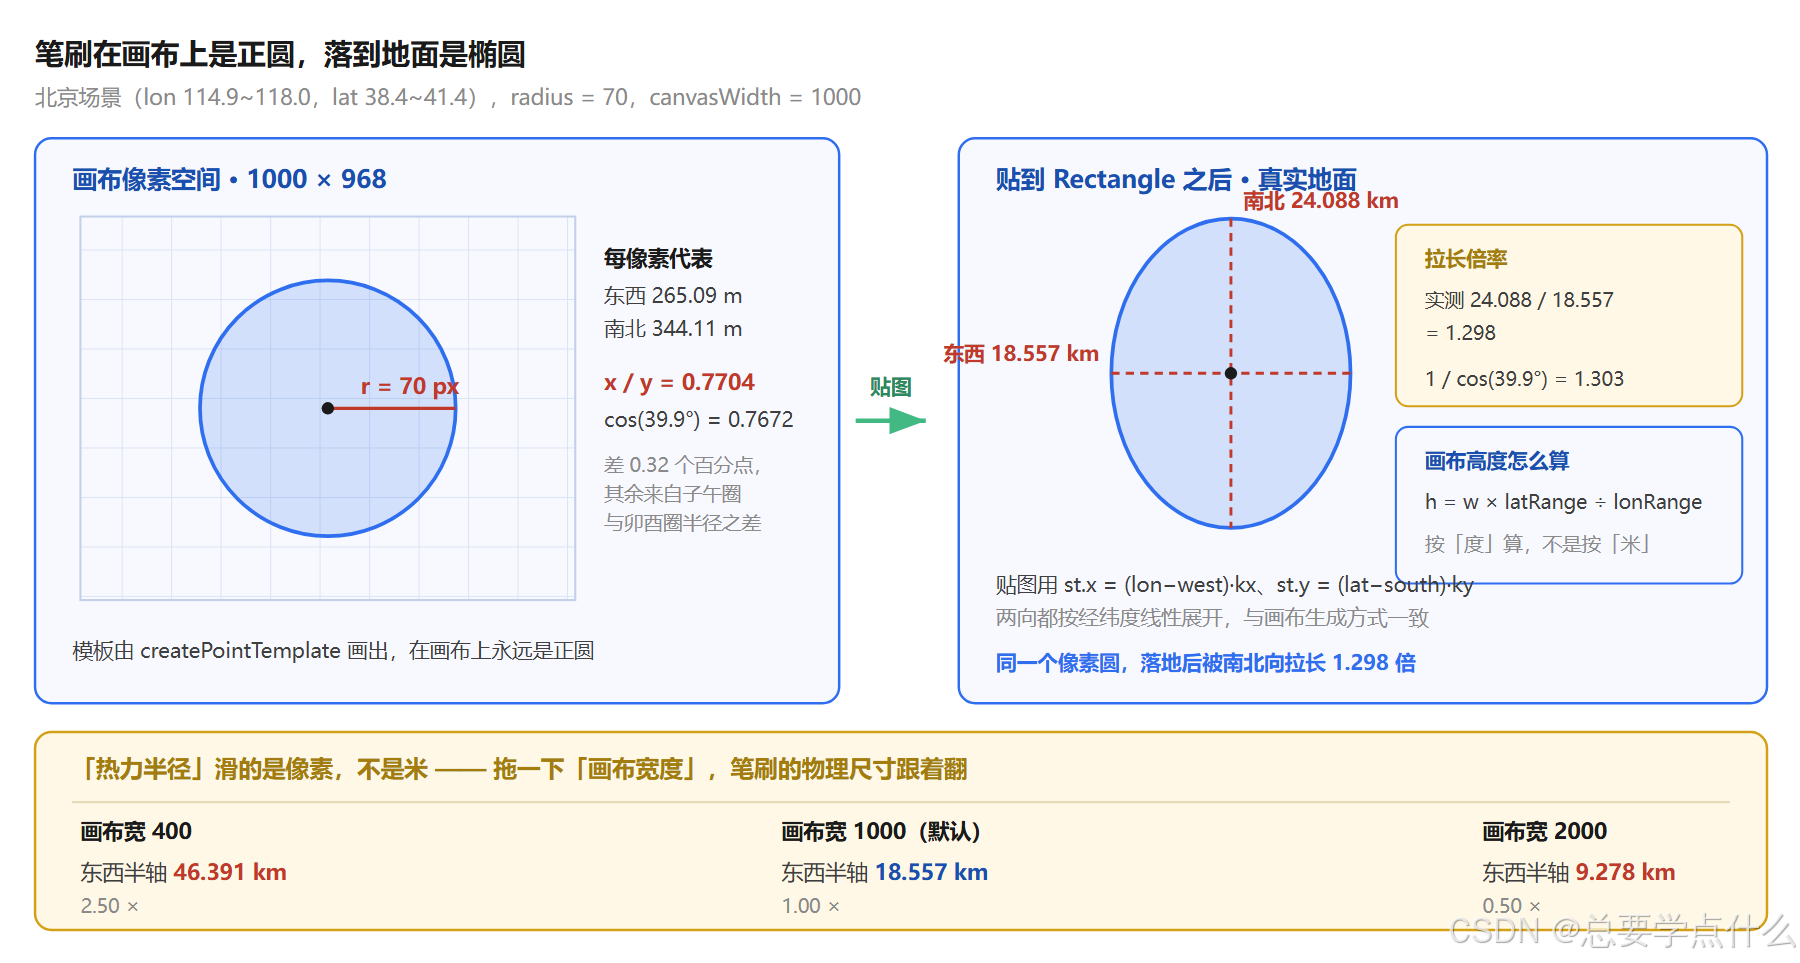
- 于是「热力半径 = 70」的真实含义是:在北京,东西向半轴 18.557 km、南北向半轴 24.088 km (拉长 1.298 倍,而
1 / cos(39.9°) = 1.303,两者只差 0.4%------这个 0.4% 就是椭球两半径不同带来的)。它不是 70 米,不是 70 公里,是 70 个像素。 - 更麻烦的是:这个像素的含义还会随"画布宽度"变。
| canvasWidth | 每像素东西向 | 半径 70 的东西半轴 | 相对 1000 px |
|---|---|---|---|
| 400 | 662.73 m | 46.391 km | 2.50 × |
| 1000(默认) | 265.09 m | 18.557 km | 1.00 × |
| 2000 | 132.55 m | 9.278 km | 0.50 × |
也就是说,你把"画布宽度"从 400 拖到 2000,同一张图、同一个半径 70,笔刷的物理尺寸缩到了原来的五分之一。 画面上看起来几乎没变(都是圆圆的色斑),变的是"一个色斑代表多少公里"------而这恰恰是热力图上最该被说清楚的那个数。
- 顺带说一句反向的坑:既然画布高度是按经纬度跨度等比算的,那么场景的 bounds 如果南北跨度大、东西跨度小,画布就会变得又高又窄(成都 1000×800,广州 1000×917,北京 1000×968)。这不是 bug,但如果你把这块画布当成"方形纹理"来用,就要留意它其实不是方的。
3.3 笔刷模板:「模糊度」拉到 1.00 反而变成硬边实心圆
笔刷的生成只有几行,但这里埋了本篇最漂亮的一个反转:
ts
function createPointTemplate(radius: number, blurFactor: number): HTMLCanvasElement {
  const template = document.createElement('canvas')
  template.width = template.height = radius * 2
  const context = template.getContext('2d')
  if (blurFactor >= 1) {                                     // ⚠️ blur === 1.00 会掉进这里
    context.beginPath()
    context.arc(radius, radius, radius, 0, 2 * Math.PI, false)
    context.fillStyle = 'rgba(0,0,0,1)'
    context.fill()                                           // 实心圆:一点渐变都没有
  } else {
    const gradient = context.createRadialGradient(
      radius, radius, radius * blurFactor,                   // 内圈半径 = r × blurFactor(alpha 1)
      radius, radius, radius                                 // 外圈半径 = r(alpha 0)
    )
    gradient.addColorStop(0, 'rgba(0,0,0,1)')
    gradient.addColorStop(1, 'rgba(0,0,0,0)')
    context.fillStyle = gradient
    context.fillRect(0, 0, 2 * radius, 2 * radius)
  }
  return template
}

// 调用处:
const blurFactor = blur >= 1 ? 1 : 1 - blur
🔑 关键点说明:
blurFactor是内圈实心核的半径占比 :它越小,实心核越小、渐变段越长,笔刷越软。blurFactor = 1 - blur,所以面板上的「模糊度」越大,blurFactor越小 → 越软。这个方向是对的。- 但滑块最大值恰好是 1。
blur = 1时blurFactor = 1 - 1 = 0......如果代码真这么写,createRadialGradient(r, r, 0, r, r, r)会得到一个"从圆心 0 开始就是 0"的退化渐变(内圈半径 0 意味着内圈退化成一点,实际上会画出最软的 一个圆)。可代码不是这么写的------它写的是blur >= 1 ? 1 : 1 - blur,在最后那一格直接短路到"实心圆"分支。 - 实测(单点、r = 70、
maxOpacity = 0.9、minOpacity = 0.1),笔刷中心的实心核半径:
| 模糊度 | blurFactor | 实心核 | 可见半径 | 平台宽度 |
|---|---|---|---|---|
| 0.20 | 0.80 | 55 px | 70 px | 1 px |
| 0.40 | 0.60 | 41 px | 70 px | 3 px |
| 0.60 | 0.40 | 27 px | 70 px | 4 px |
| 0.85(默认) | 0.15 | 10 px | 70 px | 6 px |
| 1.00 | 1.00 | 68 px | 70 px | 71 px |
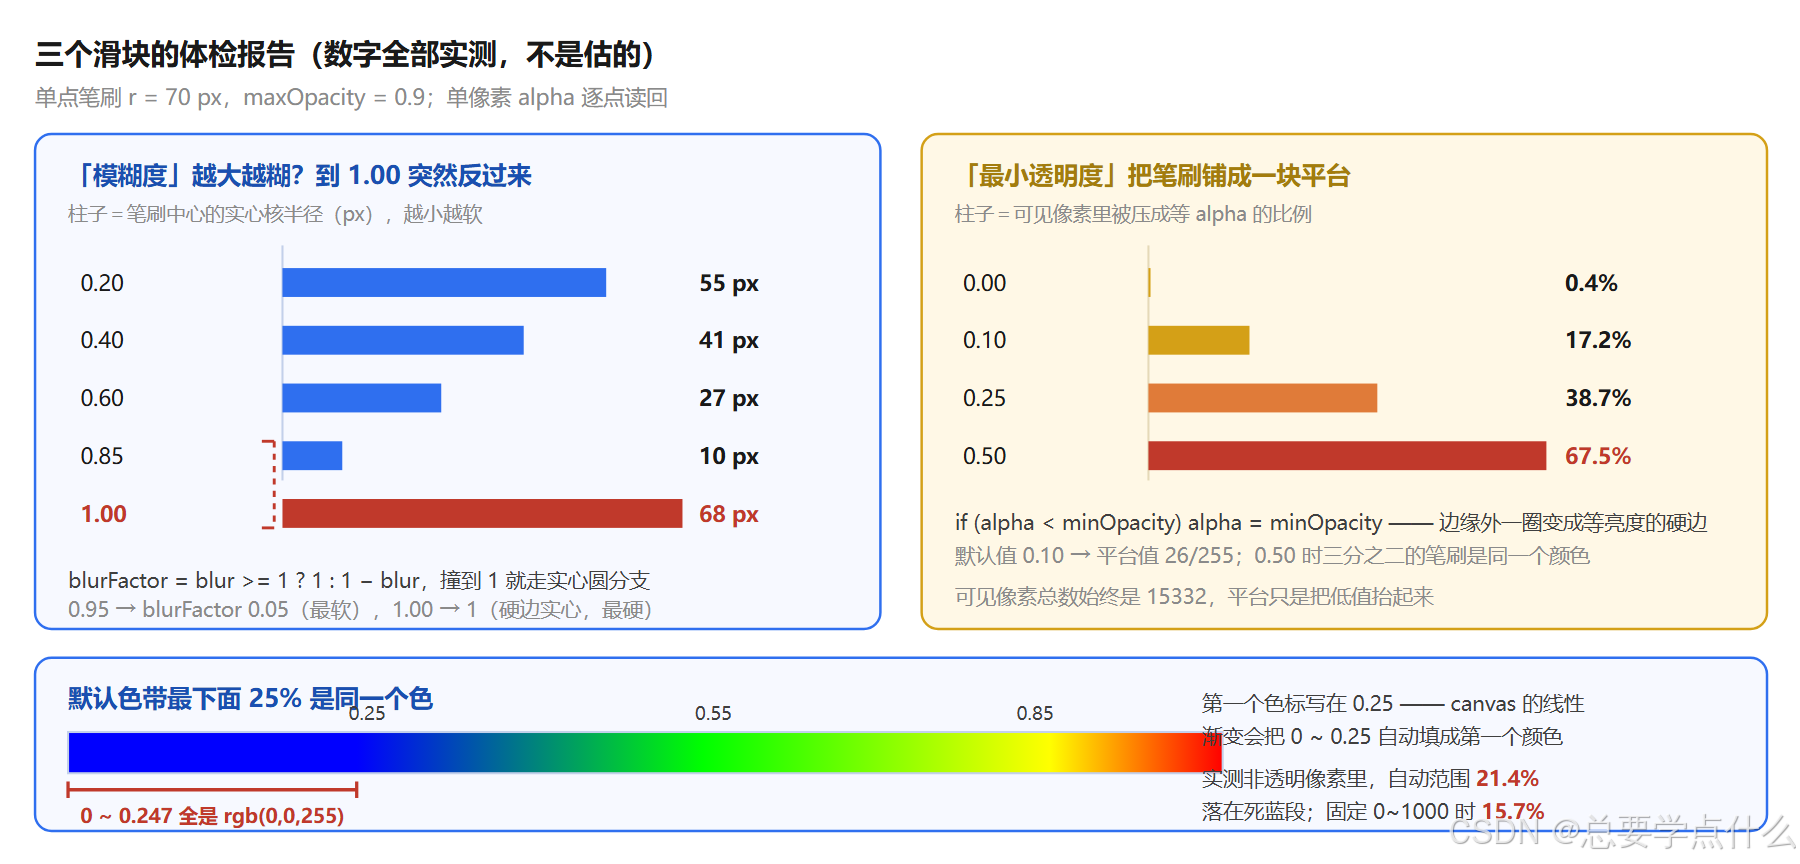
看得清清楚楚:从 0.85 到 1.00,实心核从 10 px 跳到 68 px 。如果滑到 0.95,blurFactor 是 0.05,那是全场最软 的一档;再往右拖一格到 1.00,它变成了全场最硬的一档。滑块最右边那 5% 的行程里,藏着一次完全反向的跳变。
顺便说一句:这也就是本猿在写这篇之前的那点私心------面板上凡是"越大越 X"的滑块,都值得把它拖到最右看一眼。
- 另外注意模板是按
radius缓存在 Map 里的 (templates.get(radius)),而blurFactor不在 key 里。这里之所以没出问题,纯粹是因为createHeatmapCanvas每次都是重新调用的、Map 每轮都是新的。如果哪天有人把templates提到函数外面去做跨帧缓存,改模糊度就会失效------这个坑先记在这。
3.4 落笔叠加:为什么密度永远到不了满
ts
shadowContext.globalAlpha = normalized
shadowContext.drawImage(template, x - radius, y - radius)
🔑 关键点说明:
- canvas 的默认合成模式是
source-over:新画的像素以globalAlpha为权重盖在旧像素上。这不是加法,是"剩下的部分再盖一层"。 - 所以 k 个归一化值都是 n 的点叠在一起,中心的 alpha 是
1 - (1 - n)^k,而不是k × n。实测 n = 0.5:
| 叠了几层 | 实测 alpha | 理论 1 − (1 − 0.5)^k |
|---|---|---|
| 1 | 128 | 127.5 |
| 2 | 191 | 191.25 |
| 3 | 223 | 223.125 |
| 5 | 247 | 247.03 |
- 它永远到不了 255。 100 个点叠在一起也只是 0.99999...... 这是个纯粹的数学结论:
(1 - n)^k只有在 k 无穷大时才趋近 0。 - 这件事的工程含义是:热力图的"密度"天生是对数式饱和的 。想区分"100 个点"和"1000 个点",光靠叠是区分不出来的------你必须在某个地方把它线性化(比如按点数量除以一个基数),或者干脆换个叠加方式。这不是这段代码的缺陷,是所有基于 alpha 叠加的热力图共同的天花板。
3.5 染色:alpha 当索引,以及色带上那 25% 的死区
密度场画完了,它还是一张灰度图。上色这一步是关键:
ts
const offset = alpha * 4                     // 🌰 直接拿 alpha(0~255)当色带下标
let finalAlpha: number
if (alpha > maxOpacity) {
  finalAlpha = maxOpacity
} else if (alpha < minOpacity) {
  finalAlpha = minOpacity                  // 🔑 平台就是这么来的
} else {
  finalAlpha = alpha
}
imageData[i - 3] = palette[offset]         // 色带只有 256 项,乘 4 正好对上 Uint8 的四通道
imageData[i - 2] = palette[offset + 1]
imageData[i - 1] = palette[offset + 2]
imageData[i] = finalAlpha
🔑 关键点说明:
palette是一张 256 × 1 的渐变,alpha 直接就是色带位置。这意味着色带的分辨率只有 256 级------对热力图来说完全够,因为它本来就不是拿来看细节的。- 第一个坑:色带会被 canvas 自动"延伸填补"。 默认色带是:
ts
const gradient = options.gradient ?? { 0.25: 'rgb(0,0,255)', 0.55: 'rgb(0,255,0)', 0.85: 'yellow', 1: 'rgb(255,0,0)' }注意第一个色标在 0.25,不是 0 。canvas 的 createLinearGradient 会把 0 ~ 0.25 这一段全部填成第一个颜色 ------于是色带最下面 25% 是一片死蓝 。实测逐点取样:alpha = 0 ~ 63(归一化密度 0 ~ 0.247)全部是 rgb(0,0,255),alpha = 64 才开始有第二个分量。
这个死区有多大?北京场景 1000 px 画布,非透明像素 377538 个,其中落在死蓝段的有 80931 个,占 21.4% (固定范围 0~1000 时是 15.7%)。也就是说,你图上超过五分之一的颜色,其实是同一个颜色。
另外三个色带都聪明得多:thermal / hot / viridis 的第一个色标都写在 0,死区只占色带 0.4%。这个差别在面板上就是个"换个色带看着更舒服"的感觉------但数值上的差别是 21.4% vs 0.4%。
-
第二个坑:
minOpacity会把笔刷压成一块平板。alpha < minOpacity的像素被统一抬到 minOpacity,而这些像素本来是从中心到边缘连续衰减的。于是笔刷边缘原本那个柔和的淡出,被一刀切成"整块都是一个亮度,然后突然归零"。实测(单点、r = 70、
blur = 0.85、maxOpacity = 0.9,可见像素总数恒为 15332):
| minOpacity | 平台值 | 被拍平的像素 | 占可见像素 |
|---|---|---|---|
| 0.00 | 0 | 64 | 0.4% |
| 0.10(默认) | 26 | 2640 | 17.2% |
| 0.25 | 64 | 5936 | 38.7% |
| 0.50 | 128 | 10348 | 67.5% |
默认值 0.10 就把 17.2% 的像素压成了一个恒定的 26/255;拖到 0.50,三分之二的笔刷是同一个颜色,你看到的就是一个边缘锐利的圆盘,而不是热力晕染。
- 第三个坑:平台只在"落过笔"的地方生效。 循环开头有
if (alpha <= 0) continue,所以笔刷外面 的像素不会被抬到 minOpacity。这个处理是对的(不然整张画布都会铺满一层底),但它也意味着平台的内外两侧是一个硬边 :从 minOpacity 直接掉到 0。想要"最小透明度"这个滑块名副其实,其实应该把笔刷的globalAlpha下限也一起抬起来,而不是只在最终结果上夹一刀。
3.6 出图与贴合:dataURL 和它的 569 KB
ts
const dataUrl = heatmap.canvas.toDataURL()
const material = new Cesium.ImageMaterialProperty({
  image: dataUrl,
  transparent: true
})
if (!heatmapEntity) {
  heatmapEntity = viewer.entities.add({
    rectangle: {
      coordinates: Cesium.Rectangle.fromDegrees(scene.bounds.west, scene.bounds.south, scene.bounds.east, scene.bounds.north),
      material
    }
  })
} else {
  heatmapEntity.rectangle!.material = material     // ⚠️ 每次都换一个新对象
}
🔑 关键点说明:
toDataURL()出来的是未压缩的 base64 PNG 。实测 1000 px 宽的画布 → 569 KB;2000 px → 1408 KB。这个字符串每次更新都要重新生成一遍。- 纹理坐标这边可以放心:
RectangleGeometryLibrary.computePosition里是st.x = (lon − west) × lonScalar、st.y = (lat − south) × latScalar,经纬度线性 ,和画布生成的映射方式完全一致。而 Cesium 的Texture构造函数里flipY的默认值就是true(Cesium.js第 42302 行),所以画布第一行(北)正好落在 v = 1------方向是对的,不需要手动翻图。这一处是"看着该翻、其实不用翻"。 Rectangle走的是GroundGeometryUpdater那条路(RectangleGeometryUpdater继承它),它的observedPropertyNames只有["availability", "rectangle"]------换材质不会触发几何重建,只走材质/外观更新那条线。这一点比 #49 那个"每次都重建"要健康得多。- 但注意那句
heatmapEntity.rectangle!.material = material:每次updateHeatmap都new一个ImageMaterialProperty,哪怕图像内容一模一样。它触发的是一次纹理上传,而不是几何重建------不过在"拖滑块"这种高频场景里,这也是一笔白白多花的钱。
四、功能亮点与性能优势
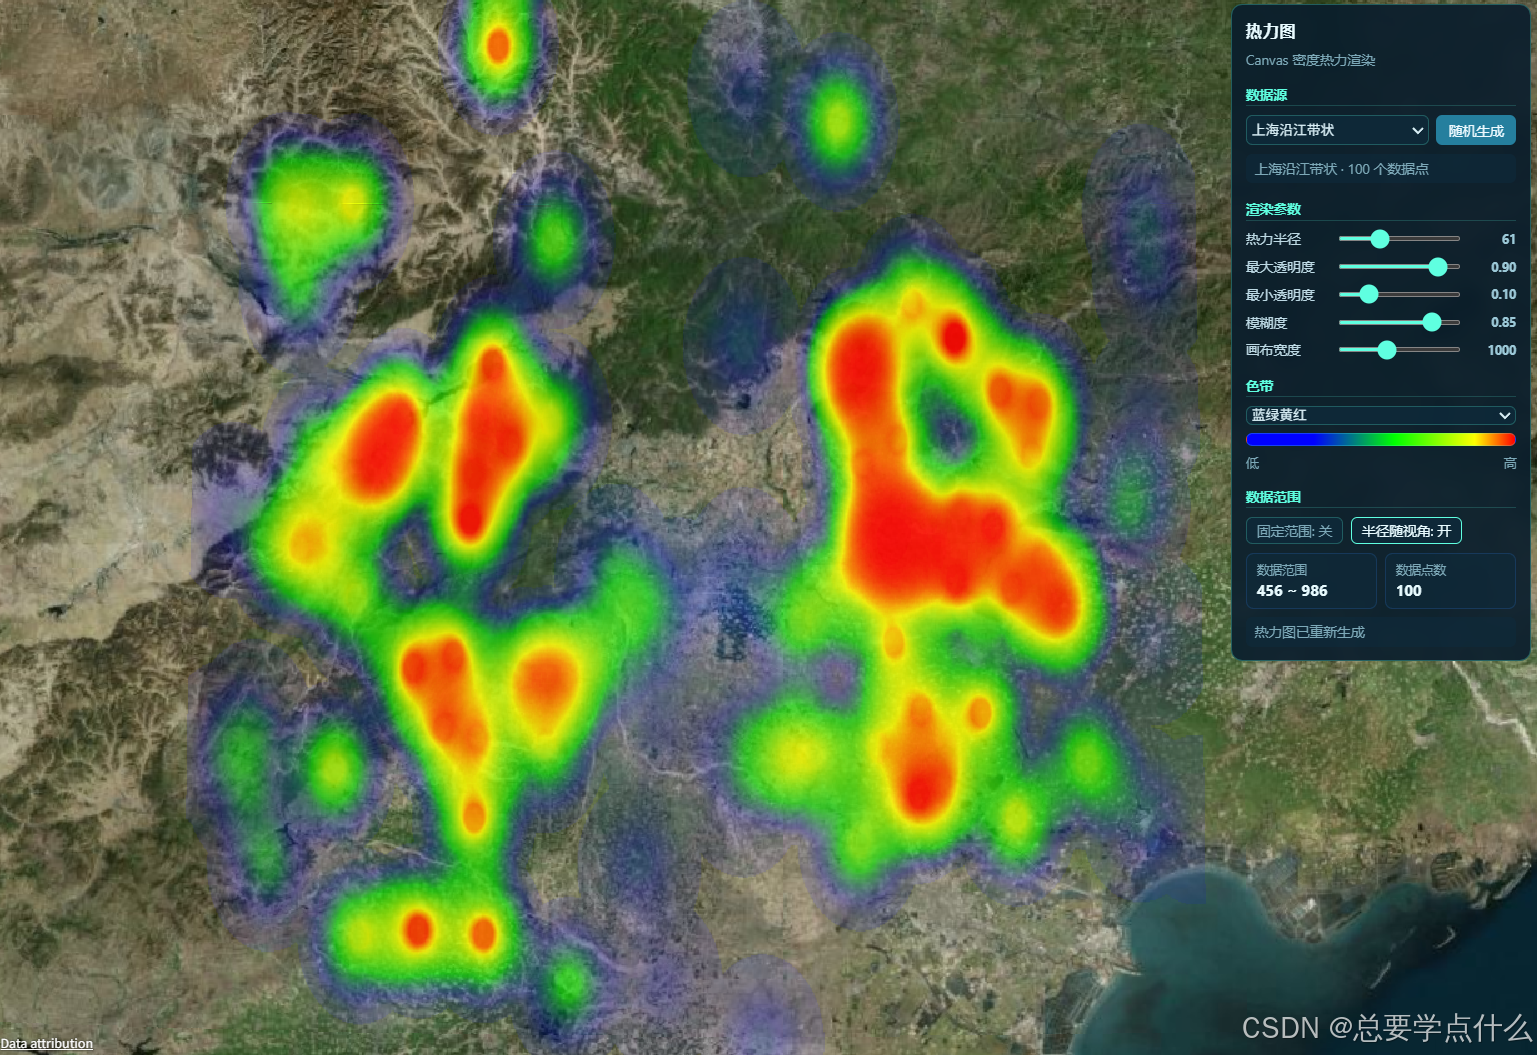
4.1 五个滑块的档位与形状
| 滑块 | 范围 / 步长 | 档位 | 它真正改的是什么 |
|---|---|---|---|
| 热力半径 | 15 ~ 160 / 5 | 30 | 笔刷的像素半径(物理尺寸随画布宽度与纬度漂) |
| 最大透明度 | 0.2 ~ 1 / 0.05 | 17 | 最终 alpha 的上限(乘 255 后夹取) |
| 最小透明度 | 0 ~ 0.5 / 0.05 | 11 | 低密度区的平台值,制造硬边 |
| 模糊度 | 0.2 ~ 1 / 0.05 | 17 | 内圈实心核占比的倒数,1.00 处反向跳变 |
| 画布宽度 | 400 ~ 2000 / 100 | 17 | 整张图的分辨率,同时改变笔刷的物理尺寸 |
4.2 性能:分段耗时与两份白拷贝
先自嘲一下测试条件:本猿用的是无头浏览器 + 软件渲染(--disable-gpu),绝对值比真机慢不少,但各段之间的比例是可以信的。每组跑 9 次、去掉前 2 次热身取中位数。
北京场景 120 个点,radius = 70:
| 画布宽 | 画布尺寸 | 模板 | 落笔 | getImageData | 染色循环 | putImageData | getImageData² | 小计 | toDataURL | 合计 | dataURL |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 400 | 400×387 | 0.0 | 0.2 | 5.9 | 0.4 | 0.2 | 0.1 | 6.8 | 1.7 | 8.5 ms | 130 KB |
| 1000 | 1000×968 | 0.0 | 0.7 | 6.8 | 1.5 | 0.7 | 0.8 | 10.6 | 7.3 | 17.8 ms | 569 KB |
| 2000 | 2000×1935 | 0.1 | 1.8 | 9.2 | 6.7 | 2.8 | 2.5 | 22.9 | 19.7 | 43.0 ms | 1408 KB |
🔑 几个能从表里读出来的结论:
- 最大单项不是画点,是把像素读回来。
getImageData在 1000 px 时占 6.8 ms,比"落笔"(0.7 ms)贵近十倍。它要读回 968000 个像素 × 4 通道。这就是 canvas 路线的本质成本:GPU 画得快,但数据得过一次 PCIe 到主内存。 toDataURL从 1.7 ms 涨到 19.7 ms,超线性。 PNG 是压缩算法,像素越多压得越久,2000 px 时它单独就吃掉 19.7 ms。- 首次(冷启动)远比稳定态慢。 同样是 1000 px,第一次跑
createHeatmapCanvas要 121 ms 、toDataURL要 100 ms(JIT 还没热、大画布还没分配)------稳定后降到 10.6 + 7.3 ms。这也是为什么用户"第一次打开页面"感觉卡一下,之后拖滑块就顺了。 - 有两份拷贝是纯白做的 :函数里
const shadowData = new Uint8ClampedArray(imageData)复制了一份全画布像素,末尾const colorData = context.getImageData(0, 0, width, height).data又读了一份。Canvas 版演示一个都不用 (它们只对"需要拿到像素去做空间查询"的调用方有意义)。1000×968 时是 3.87 MB × 2 = 7.74 MB ;2000×1935 时是 15.48 MB × 2 = 30.96 MB------每次拖滑块,白分配三十兆。 - 每一次改动都是全量重画。 五个滑块加起来 92 档,没有任何一档走的是"只改外观"的捷径。改颜色?重画。改最大透明度?重画。改模糊度?重画(而且这次真的必须重画,因为笔刷模板变了)。
4.3 相机自适应半径:一个会自己往上爬的滑块
面板上有个开关叫「半径随视角」,本意是"相机拉远时把笔刷调大一点,保持视觉密度"。
ts
const maxRadius = 120
const minHeight = 6375000        // 约 4 km 高度
const maxHeight = 10000000      // 约 3629 km 高度
cameraMoveEndListener = () => {
  const height = viewer.camera.getMagnitude()               // 🔑 到地心的距离
  if (Math.abs(height - lastCameraHeight) < 1500) return    // 1.5 km 死区
  lastCameraHeight = height
  const base = initRadiusValue
  const nextRadius = Math.round(base + ((maxRadius - base) * (height - minHeight)) / (maxHeight - minHeight))
  if (nextRadius >= 20 && nextRadius <= 200 && nextRadius !== radius.value) {
    radius.value = nextRadius
    updateHeatmap()
  }
}
🔑 这里有个很隐蔽的自反馈:
maxRadius是个常数 120 ,所以这条式子做的事其实是:把当前半径往 120 插值 。相机在最低处(height = minHeight)不动它,在最高处(height = maxHeight)直接拉到 120。- 每次触发都是
radius.value = nextRadius→updateHeatmap(),而updateHeatmap()的最后一行 是initRadiusValue = radius.value。 - 也就是说,下一轮的
base已经被改成了上一轮的输出 。这不是自适应,这是棘轮。
实测:北京场景在同一个相机高度(16:9 初始视角,|pos| = 7087.0 km,对应高度约 717.6 km),反复触发 moveEnd:
70 → 80 → 88 → 94 → 99 → 103 → 106 → 109 → 111 → 113 → 114 → 115 → 116 → 117 → 118 → 118十六次之后钉在 118 ,一路逼近 120 的常数上限。你什么都没动,只是把地图来回平移了几次,"热力半径"就从 70 爬到了 118。
- 各场景 16:9 初始视角的第一次跳变:北京 70 → 80 、上海 → 76、广州 → 75、成都 → 75。注意这意味着页面刚打开、还没碰过任何东西,面板上的 70 就已经不是真的在用的值了------实际生效的是 80。
- 视口比例也会影响它:北京 16:9 → 80、4:3 → 77、1:1 → 75(因为
setView给的是一个矩形,不同比例下算出来的相机高度不一样)。 - 更麻烦的是它改不回去 。棘轮只会往上(当
base < 120时),想回到用户最初设的 70,只能手动关掉开关再拖滑块。而这时initRadiusValue已经是 118 了------开关再打开,"自适应"的基准就成了 118。
4.4 核心优势
- 🚀 零依赖纯前端:整张热力图在浏览器里凭空生成,没有接口、没有瓦片、没有服务端成本
- 🎨 可复现:同一份 seed 永远出同一张图,调试的时候不用"凭感觉重现现场"
- 🧩 贴图路线轻 :走
Rectangle+ImageMaterialProperty,不碰几何重建,改图不改网格 - ⚙️ 参数即时反馈:稳定态下一次全量重画只要 8.5 ~ 43 ms,交互体感是"跟手"的
五、小贴士:避坑指南
🎯 关于归一化与「最小值」
常识是:热力图的强弱靠相对值,最小值自然最淡。但这份实现里,最小值不是"最淡",是"不存在" ------normalized <= 0 直接 continue。
⚠️ 重要提示 :这个 <= 0 的影响面比看上去大得多,因为它同时是两个问题的入口:
- 自动范围时必然触发 :
min取的就是数据最小值,所以永远有一个点(或一批并列最小的点)被跳过 - 固定范围时被放大 :下界一拉高,
normalized为负的点全部消失。实测广州场景下界拉到 800,71.3% 的点直接没了
建议的正确做法(按代价从低到高):
- 把
continue换成normalized = Math.max(normalized, 0.0001)------让它画出最淡的一笔,而不是不画 - 归一化时把
min稍微下探一点(min - (max - min) * 0.02),给最小值留一条"可见"的缝 - 面板上加一栏"实际落笔点数",让"消失"这件事在 UI 上可见------现在是面板写 80、图上有 23
🎨 关于色带
⚠️ 重要提示 :createLinearGradient 会把首尾色标之外的范围自动延伸填补,而不是留空或报错。
- 写色带时务必把第一个色标放在 0、最后一个放在 1。默认色带因为首标在 0.25,白白浪费了 25% 的色域,实测有 21.4% 的非透明像素挤在那一段死蓝里
- 想保留"低密度就是纯蓝"这种设计意图,就显式写
{ 0: 'rgb(0,0,255)', 0.25: 'rgb(0,0,255)', ... }------让意图写在代码里,而不是藏在 canvas 的默认行为里 - 四个色带里
thermal/hot/viridis都是规范写法,可以直接拿来对照
⚡ 关于性能
getImageData是这条路线的天花板。 它是唯一一个"必须把 GPU 画的东西读回主内存"的步骤。如果你的画布要开到 2000 px 以上,先量一下这一步- 删掉那两份白拷贝。
shadowData和colorData在 Canvas 版演示里一个都没用到,每次却要分配 30 MB(2000 px 时) toDataURL是超线性的,2000 px 时 19.7 ms 里有很大一块是 PNG 压缩。数据不变时可以缓存 dataURL,只在参数真的变了才重编- 别在高频事件里调它。
camera.moveEnd是安全的(一帧一次),但如果你哪天想挂到camera.changed上做实时跟随,17.8 ms 一帧会把交互拖到 50 fps 以下
🧭 关于「像素」和「米」
- 面板上的「热力半径」没有单位,它的单位是像素。 想让它有意义,就得在面板上把它换算出来显示:
半径 × 每像素米数。这个换算需要知道bounds和中心纬度,两样数据都在手边 - 半径随视角那个棘轮,本质是把
initRadiusValue当成了"上一次的输出"。 正确做法是单独存一个userRadius,自适应只改一个"显示半径",永远不改用户设的基准值 - 如果业务上真的需要"固定 20 公里的热力斑",那正确做法是反过来算:先定物理半径,再按当前画布宽度和纬度反推像素半径
📦 关于当前局限
目前这个案例最明显的几处局限,本猿也一并列出来:
- 密度是对数式饱和的 (
1 - (1 - n)^k),点数一多就分不出高下;真要表达"绝对数量",得引入一个基准归一化 - 每次参数变化都是全量重画,包括"最大透明度"这种只影响最终夹取的参数------它完全可以做成后处理
- 面板的「数据范围」和引擎实际用的范围可能不是一回事 :
metricRange显示的是data.valueMin ~ data.valueMax(数据自身的值域),而引擎在开了固定范围后用的是fixedMin ~ fixedMax。固定 800~1000 时面板会写"388 ~ 1000",但图上画的是 800~1000 - 画布宽高比按"度"算 ,所以笔刷落地永远是椭圆;要正圆就得在高度里补一个
cos(中心纬度)
这些优化点,都可以在实际应用中按需调整------本文的目标是把账算清,不是把它做完美。
六、写在最后
这是第 51 篇,也是数据分析这条线的第一站。回头看,这一篇量的东西其实和前面几篇不太一样:前几篇量的是"某个特效算错了什么",这一篇量的是**"一个参数根本没有单位"**。
70 这个数字,在面板上叫"热力半径",在代码里叫 radius,在画布上叫"70 个像素",在地面上叫"18.557 公里的椭圆"。四个名字,没有一个写在界面上。
而这一篇最让本猿意外的不是那个 blur >= 1 的短路分支,也不是那个 25% 的死蓝,而是------
那个会自己爬的滑块。
它是全场唯一一个"你什么都没做、它自己变了"的地方。没有动画、没有定时器,只有一行 initRadiusValue = radius.value 和一行 radius.value = nextRadius,安安静静地互相喂了一轮又一轮。你把地图平移十六次,它就爬到 118。
热力图是最"不讲理"的一种表达:它不画边界,不给数值,只给你一团颜色。
可越是这样的图,越需要有人去问一句------
那团颜色,到底是几个像素?
那几个像素,又是几公里?
数据分析线第一篇。这条线往下还有热力图的三维版、聚合、轨迹、流向等等------它们大概率会再遇到同一批问题:归一化的边界、色带的死区、像素与米之间的那层换算。参数名换一换,账还是那笔账。
🎉 热力图量完了------模糊度滑到最右反而最硬,半径 70 落地是个 18.557 km 的椭圆,那个滑块还会自己往上爬。
如果你有更好的想法,或者在实际使用中遇到问题,欢迎来 GitHub 提 Issue!这个系列还会继续往下挖,下一站大概是热力图的三维版------换一套坐标系,看同样的账会不会又变个算法。
开源地址:https://github.com/jianlei-wang/CESIUM-TREASURE-BOX
🌟 项目已开源,欢迎 Star!(你的 Star ⭐ 就是对我最大的支持!)
仓库公开,直接到 GitHub 取即可。本篇涉及的目录:
src/cases/heatmap-canvas/------ 演示面板与场景装配(HeatmapCanvasDemo.vue,298 行)+index.ts(id: heatmap-canvas/category: data/tag: 数据可视化/updatedAt: 2026-08-27)src/cases/heatmap-lib/heatmap-engine.ts------buildPalette+createPointTemplate+createHeatmapCanvas(共 172 行)src/cases/heatmap-lib/heatmap-data.ts------seededRandom+gaussian+ 四个场景 +generateSceneData(共 141 行)
Cesium酱の百宝箱 · 第 51 篇
莫数色斑几许宽,且将像素问归米
2026 年深秋,愿我们拖动每一个滑块之前,都先问清楚「它改的是像素还是米」