大数据之HIVE,一次HIVESQL执行的过程(四)

在hive中执行如下sql

INSERT OVERWRITE TABLE XXX

SELECT * from XXX

数据最终是怎么存储到hdfs上的过程

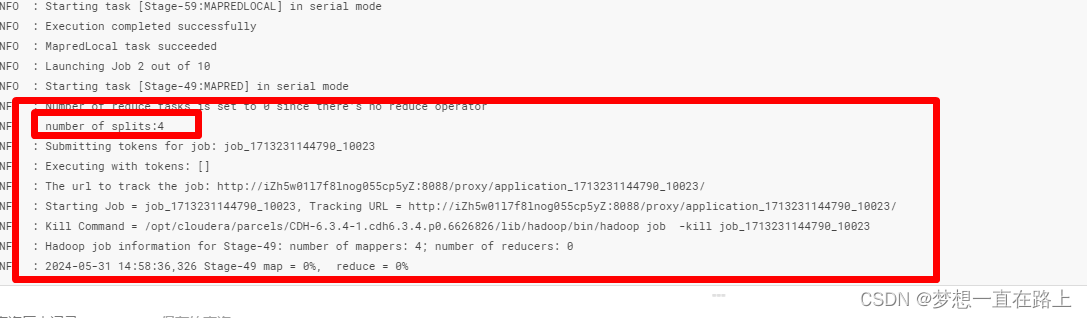
执行的过程当中,打印出如下的日志过程,本质上是一个在MapReduce中进行Shuffle的过程

所以下面就Shuffle的过程进行分析

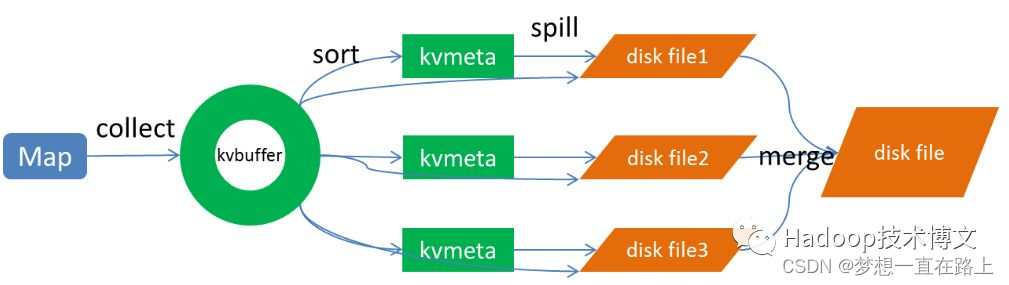
Shuffle 描述的是数据从 Map 端到 Reduce 端的过程,大致分为排序(sort)、溢写(spill)、合并(merge)、拉取拷贝(Copy)、合并排序(merge sort)这几个过程,大体流程如下:
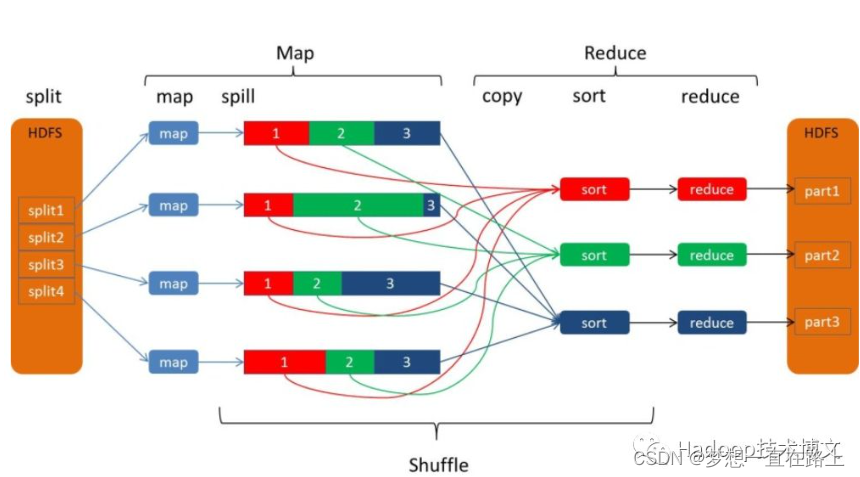
上图的 Map 的输出的文件被分片为红绿蓝三个分片,这个分片的就是根据 Key 为条件来分片的,分片算法可以自己实现,例如 Hash、Range 等,最终 Reduce 任务只拉取对应颜色的数据来进行处理,就实现把相同的 Key 拉取到相同的 Reduce 节点处理的功能。下面分开来说 Shuffle 的的各个过程。
注意:

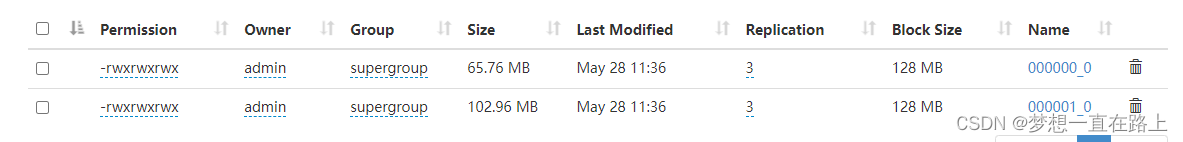
sqoop import实际上是把数据存放到hdfs对应路径上了,而不是"直接导入表里",

查询时,hive会从hdfs的路径上提取数据,再根据hive表的结构和定义,来向我们展示出类似表格的形式。
相关推荐
isNotNullX3 小时前
仓储管理最全框架:6大流程、8项指标、10个管理动作、12个常见问题
大数据·人工智能
国科安芯5 小时前
把接口变成观测量:CANFD收发器状态可观测性驱动的星上故障检测隔离与恢复方法
大数据·人工智能·物联网·卫星·抗辐射·通信芯片·载荷
玩美数据6 小时前
海外市场数据服务常用术语与名词解释权威指南
大数据·人工智能
武子康9 小时前
Qwen-Drive 的 91.4 分,究竟选中了什么?
大数据·人工智能·agent
演艺大赏9 小时前
NiFi 集群长期运维:并发线程、content 仓库、日志与漏洞面
大数据
freejackman13 小时前
【工程化】从“单兵作战”到“多引擎架构”:基于门面模式的重构实战
大数据·数据库·hive·sql·测试工具·设计模式·架构
字节跳动数据平台15 小时前
火山引擎知识引擎VeKnow进化之路(上):从“人有数可用”到“AI有智可循”
大数据
Flynn Liang17 小时前
Apache Superset 重要特性详解(三):语义层 / 权限 / 缓存 / 嵌入的实战最佳实践(2026 版)
大数据·clickhouse·数据可视化·架构设计·superset·数据分析平台
小田学Python1 天前
工具调用:让 Agent 从“说”到“做”
大数据·大模型·agent·ai工具·deepseek