(一)Hadoop的组成
对普通用户来说, Hadoop就是一个东西,一个整体,它能给我们提供无限的磁盘用来保存文件,可以使用提供强大的计算能力。
在Hadoop3.X中,hadoop一共有三个组成部分:MapReduce,Yarn,HDFS。它们的作用如下:
MapReduce: 用来提供计算。
HDFS: 用来提供文件存储功能。
Yarn: 用来协调调度。
(二)HDFS
Hadoop Distributed File System, 简称HDFS,是一个分布式文件系统。在hadoop体系中,它用来存储文件。
例如,当我们把一个文件(例如500M),保存到hadoop中时,它的背后要实现两个效果:
如果文件较大(>128M)把大文件拆小,并分别传输。
存储3份在不同的主机上。
在它的内部,有三个角色,分别如下:
(1)NameNode(nn):存储文件的元数据,如文件名,文件目录结构,文件属性(生成时间,副本数,文件权限),以及每个文件的块列表和块所在的DataNode等。
(2)DataNode(dn):在本地文件系统存储文件块数据,以及块数据的校验和。
(3)Secondary NameNode(2nn): 每隔一段时间对NameNode元数据备份。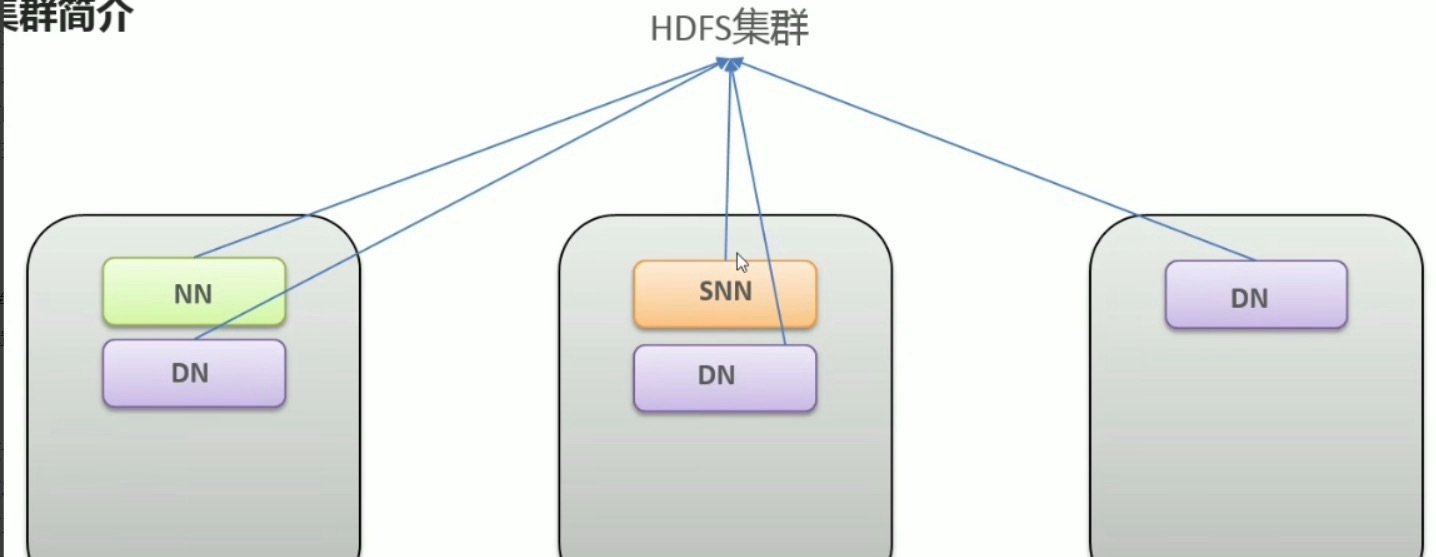
HDFS集群:一主加三从,额外再配一个小秘书
(三)YARN
Yet Another Resource Negotiator,简称YARN,另一种资源协调者,是Hadoop的资源管理器。
(1)ResourceManager(RM):整个集群资源(内存,CPU等)的管理者
(2)NodeManager(NM): 单个节点服务器资源的管理者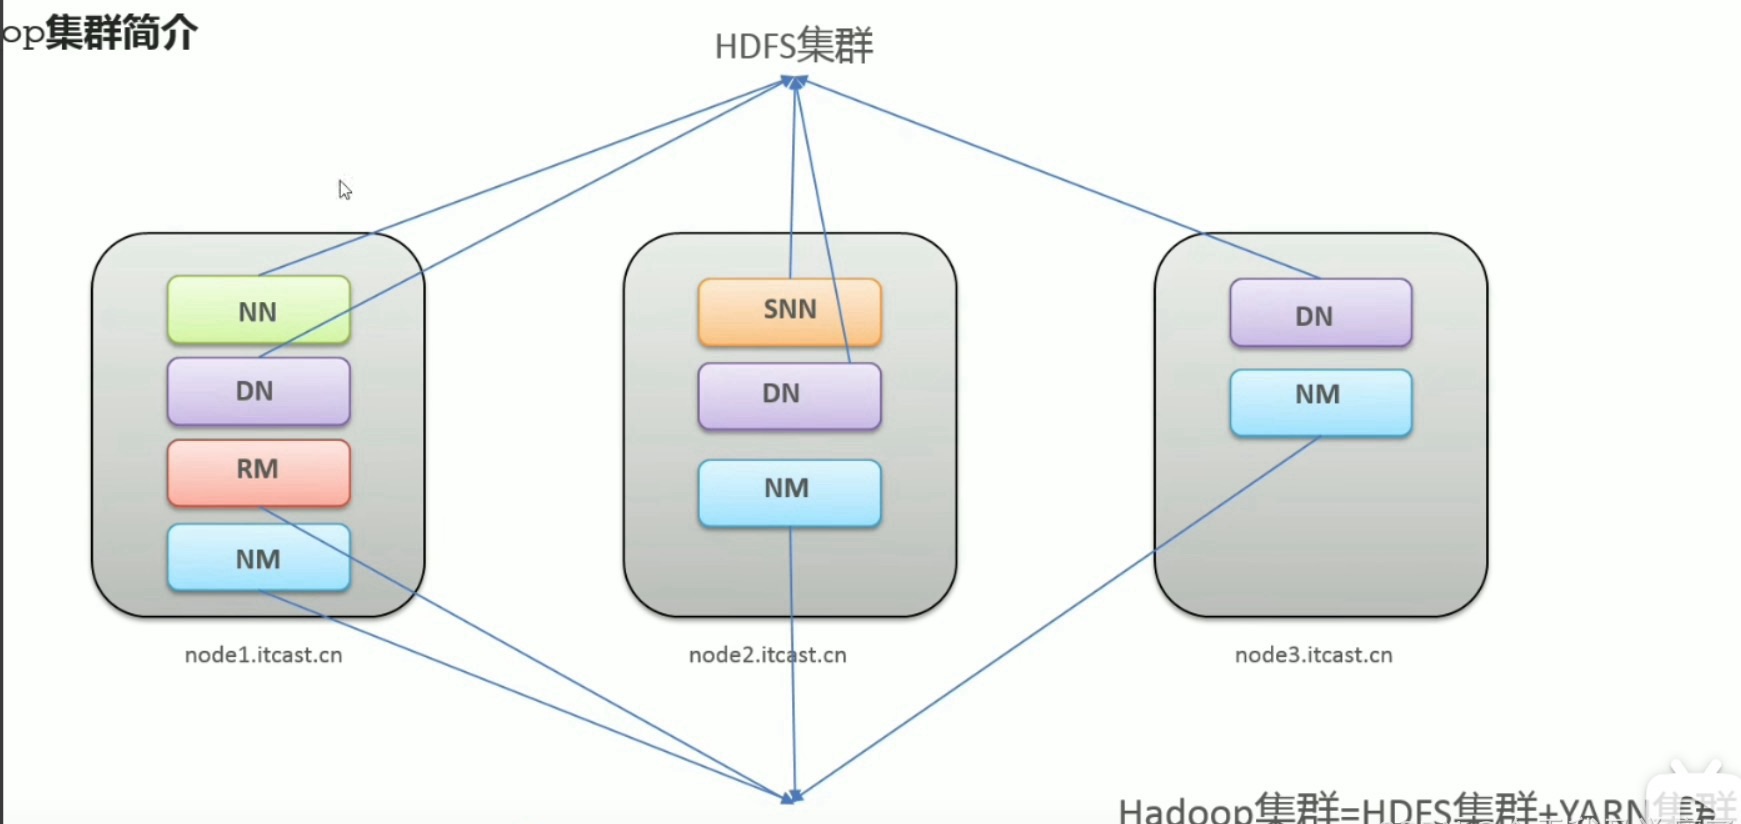
Yarn和HDFS的关系说明:逻辑上分离,物理上在一起。
逻辑上分离:不是说非要启动HDFS集群才能启动YARN集群,不是先有哪个再有哪个?每个框都是一个进程,可能都运行在一台主机上,但是,属于不同的集群。
物理上在一起:每一台机器上都有NN, NM。
(四)MapReduce
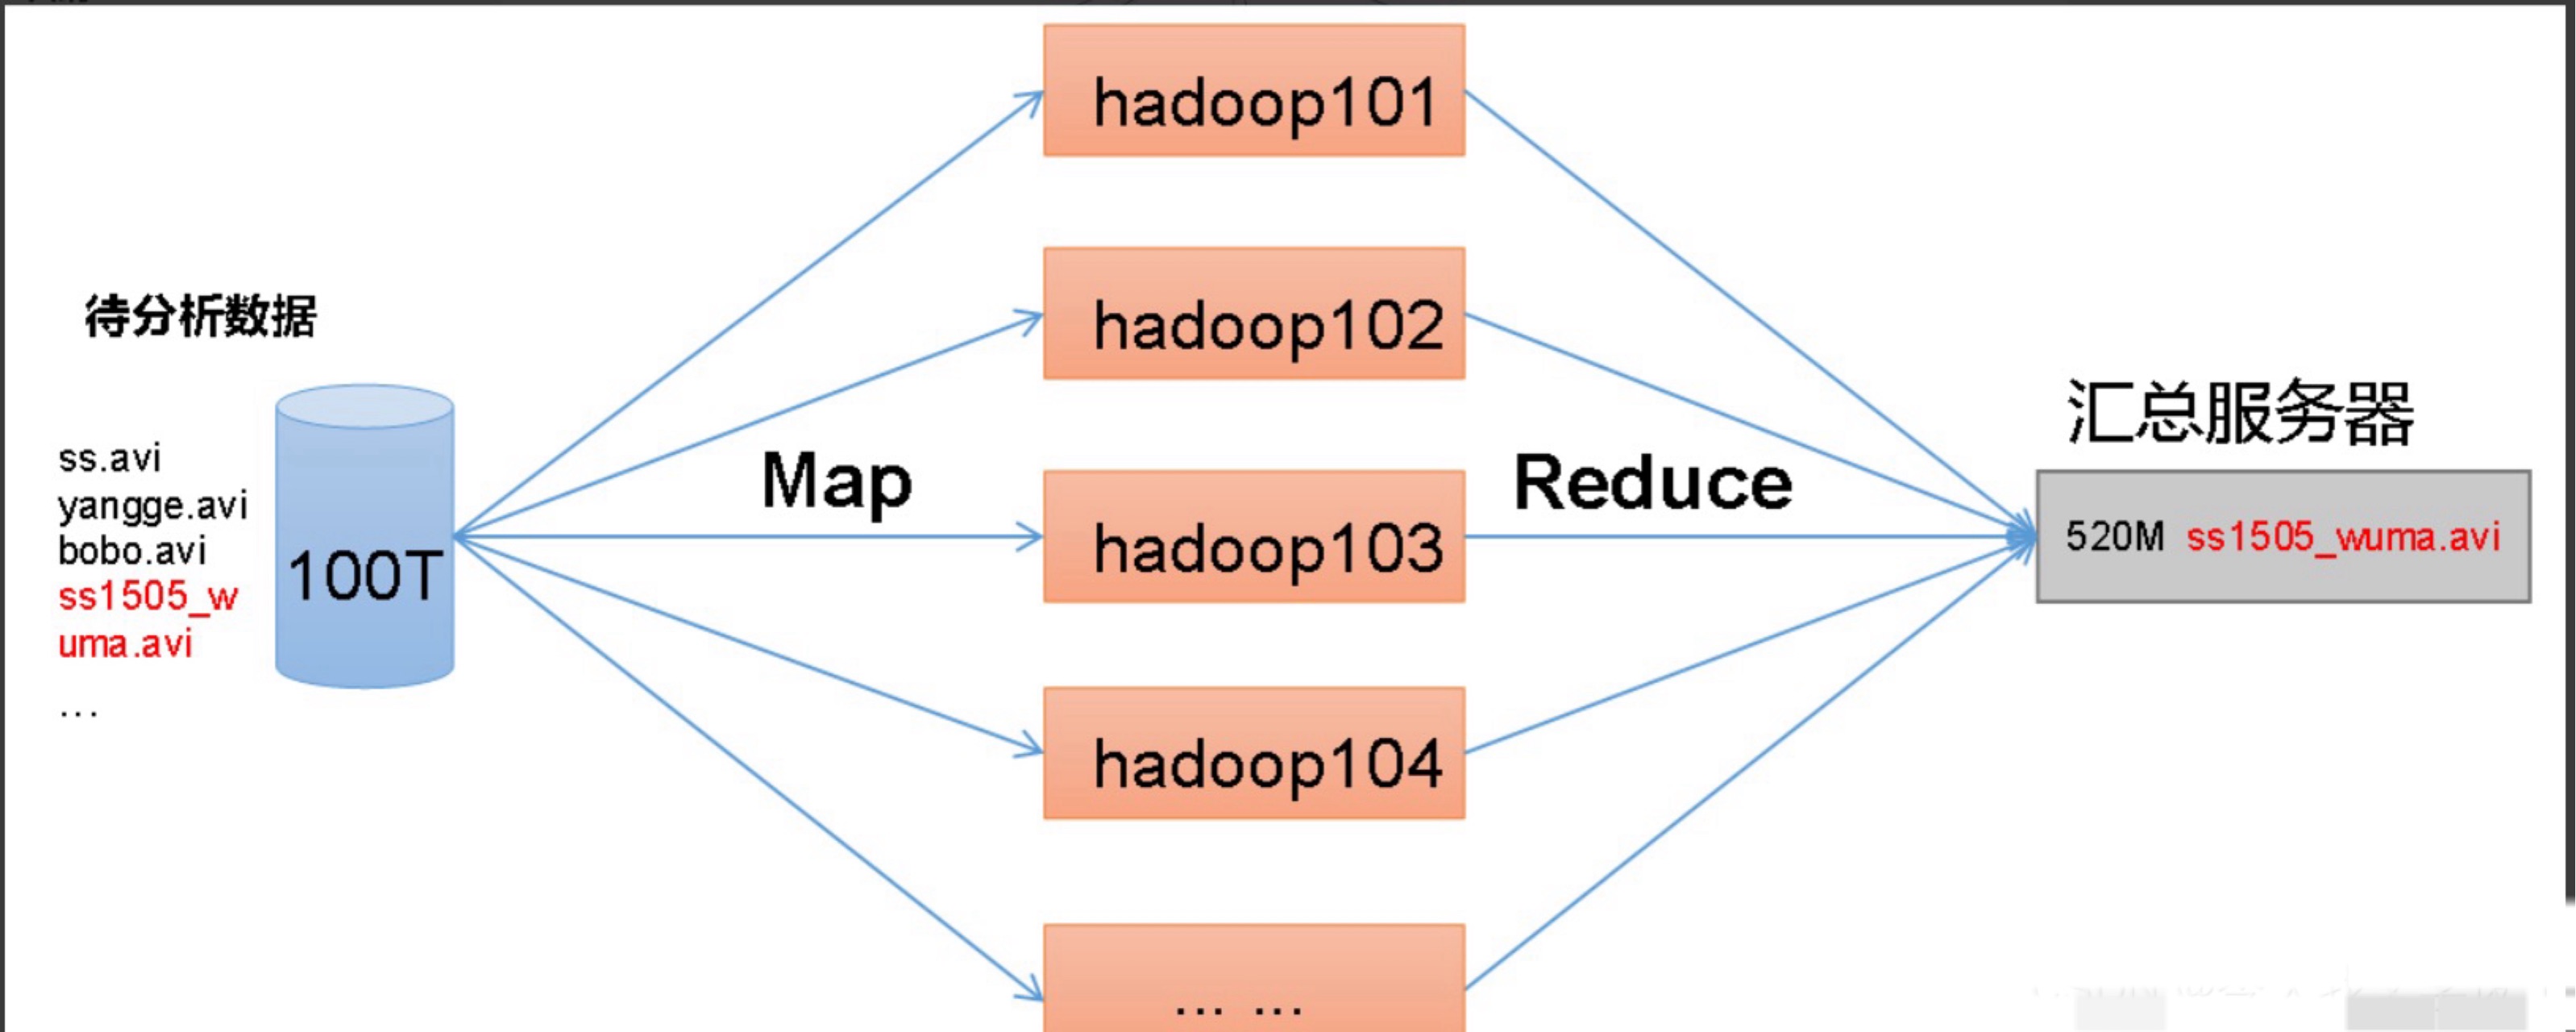
MapReduce用来提供计算的能力。它将计算过程分为两个阶段:Map和Reduce。
(1)Map阶段并行处理输入数据
(2)Reduce阶段对Map结果进行汇总