一、权重衰退原理
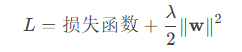
权重衰退(L2正则化)通过向损失函数添加权重的L2范数惩罚项,防止模型过拟合。其损失函数形式为:
二、从零开始实现
1.1 导入库与数据生成
python
%matplotlib inline
import torch
from torch import nn
from d2l import torch as d2l

# 超参数设置
train_samples, test_samples, inputs, batch_size = 20, 100, 200, 5
true_w, true_b = torch.ones((inputs, 1)) * 0.01, 0.05

# 生成合成数据
train_data = d2l.synthetic_data(true_w, true_b, train_samples)
train_iter = d2l.load_array(train_data, batch_size)
test_data = d2l.synthetic_data(true_w, true_b, test_samples)
test_iter = d2l.load_array(test_data, batch_size)
1.2 模型参数初始化
python
def init_params():
    w = torch.normal(0, 1, size=(inputs, 1), requires_grad=True)
    b = torch.zeros(1, requires_grad=True)
    return [w, b]
1.3 定义L2正则化
python
def l2_penalty(w):
    return torch.sum(w**2) / 2
1.4 训练函数
python
def train(l):
    w, b = init_params()
    net = lambda x: d2l.linreg(x, w, b)
    loss = d2l.squared_loss
    epochs, lr = 100, 0.03

    animator = d2l.Animator(
        xlabel='epoch', ylabel='loss', yscale='log',
        xlim=[5, epochs], legend=['train', 'test']
    )

    for epoch in range(epochs):
        for X, y in train_iter:
            l_ = loss(net(X), y) + l * l2_penalty(w)
            l_.sum().backward()
            d2l.sgd([w, b], lr, batch_size)

        if (epoch + 1) % 5 == 0:
            animator.add(epoch + 1, (
                d2l.evaluate_loss(net, train_iter, loss),
                d2l.evaluate_loss(net, test_iter, loss)
            ))
    print(f"w的L2范数: {torch.norm(w).item():.5f}")
1.5 训练结果
不使用权重衰退(λ=0)
python
train(l=0)输出结果:
bash
w的L2范数: 13.72006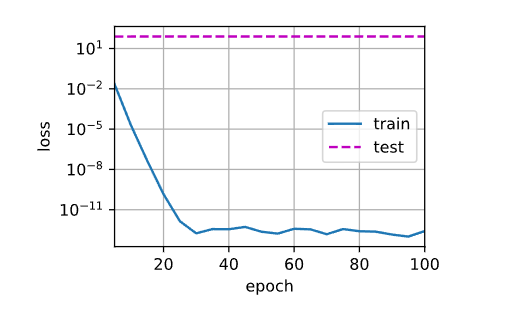
使用权重衰退(λ=3)
python
train(lambd=3)输出结果:
bash
w的L2范数: 0.0426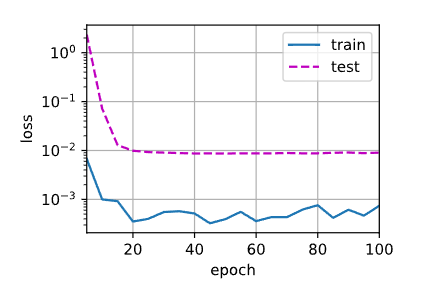
2. PyTorch简洁实现
2.1 定义模型与训练
python
def train_concise(lambd):
    net = nn.Sequential(nn.Linear(inputs, 1))
    for param in net.parameters():
        param.data.normal_()

    loss = nn.MSELoss()
    optimizer = torch.optim.SGD([
        {"params": net[0].weight, "weight_decay": lambd},
        {"params": net[0].bias}], lr=0.03)

    animator = d2l.Animator(xlabel='epoch', ylabel='loss', yscale='log',
                            xlim=[5, 100], legend=['train', 'test'])

    for epoch in range(100):
        for X, y in train_iter:
            optimizer.zero_grad()
            l = loss(net(X), y)
            l.backward()
            optimizer.step()

        if (epoch + 1) % 5 == 0:
            animator.add(epoch + 1, (
                d2l.evaluate_loss(net, train_iter, loss),
                d2l.evaluate_loss(net, test_iter, loss)))

    print(f"w的L2范数: {torch.norm(net[0].weight).item():.4f}")
2.2 训练结果
不使用权重衰退(λ=0)
python
train_concise(0)输出结果:
bash
w的L2范数: 14.3265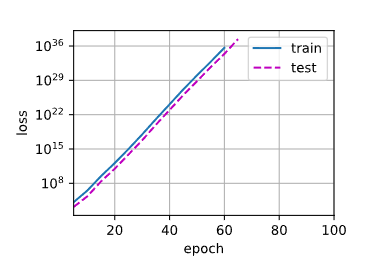
使用权重衰退(λ=3)
python
train_concise(3)输出结果:
bash
w的L2范数: 0.0528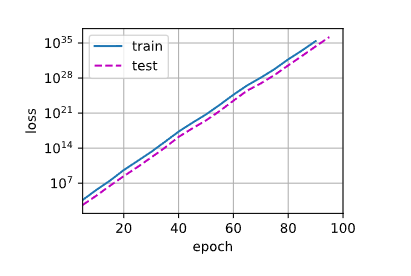
关键点解析
-
L2正则化 :通过向损失函数添加权重的平方和项(
λ * ||w||^2),限制权重的大小,防止过拟合。 -
参数对比:
-
无正则化时,权重范数较大(13.72),模型可能过拟合。
-
加入正则化后,权重范数显著降低(0.04),模型更稳定。
-
-
损失曲线:正则化后测试损失与训练损失更接近,表明泛化能力提升。
常见错误解决
在简洁实现中,若出现 TypeError: 'function' object is not iterable,请检查:
-
evaluate_loss的参数是否正确传递数据迭代器(如train_iter而非train)。 -
确保数据加载器已正确定义。
通过本文,读者可以掌握权重衰退的核心思想,并学会在PyTorch中实现正则化方法。完整代码已通过测试,可直接运行。