目录
[1. 计算设备配置](#1. 计算设备配置)
[2. 随机种子设置](#2. 随机种子设置)
[3. 数据加载与预处理](#3. 数据加载与预处理)
[4. 词向量初始化](#4. 词向量初始化)
[5. 模型初始化](#5. 模型初始化)
[6. 模型训练与预测](#6. 模型训练与预测)
系统整体架构
我们的文本情感分类系统由以下几个核心部分组成:
- 环境配置与随机种子设置
- 数据加载与预处理
- 模型初始化
- 模型训练与评估
- 单样本预测
1. 计算设备配置
python
device = 'cuda' if torch.cuda.is_available() else 'mps' if torch.backends.mps.is_available() else 'cpu'这段代码自动检测并选择可用的计算设备,优先顺序为:
- CUDA(NVIDIA 显卡):适合大规模训练,速度最快
- MPS(Apple Silicon GPU):苹果芯片的 GPU 加速
- CPU:通用处理器,速度较慢但兼容性最好
这种配置使代码能够在不同硬件环境下自动适配,提高了代码的可移植性。
2. 随机种子设置
python
np.random.seed(1)
torch.manual_seed(1)
torch.cuda.manual_seed_all(1)
torch.backends.cudnn.deterministic = True
设置随机种子是确保实验可复现性的关键步骤。通过固定随机数生成器的初始状态,我们可以保证每次运行代码时得到相同的结果,这对于模型调优和结果验证非常重要。
torch.backends.cudnn.deterministic = True确保 CUDA 的卷积操作也是确定性的,进一步增强了实验的可复现性。
3. 数据加载与预处理
python
# 加载数据集和词汇表
vocab, train_data, dev_data, test_data = load_dataset.load_dataset('simplifyweibo_4_moods.csv')

# 将数据集转换为迭代器
train_iter = load_dataset.DatasetIterater(train_data, 128, device)
dev_iter = load_dataset.DatasetIterater(dev_data, 128, device)
test_iter = load_dataset.DatasetIterater(test_data, 128, device)
这部分代码完成了从原始数据到模型可处理格式的转换:
load_dataset()函数读取 CSV 格式的数据集文件,并构建词汇表- 数据集被分为三部分:训练集 (train_data)、验证集 (dev_data) 和测试集 (test_data)
DatasetIterater将数据打包成批次(batch_size=128),并移动到指定设备
将数据分成三个集合是机器学习的标准做法:
- 训练集:用于模型参数学习
- 验证集:用于超参数调优和早停判断
- 测试集:用于评估模型的最终性能
4. 词向量初始化
python
# 加载预训练词向量
embedding_pretrained = torch.tensor(np.load('embedding_Tencent.npz')['embeddings'].astype('float32'))
# 确定词向量维度
embed = embedding_pretrained.size(1) if embedding_pretrained is not None else 200
这里使用了腾讯 AI Lab 提供的预训练中文词向量,这是一种迁移学习的方式:
- 预训练词向量包含了丰富的语义信息,可以加速模型收敛
- 提高模型性能,尤其是在训练数据有限的情况下
- 如果没有预训练词向量,代码会使用默认维度 (200) 的随机初始化词向量
5. 模型初始化
python
# 定义情感类别
class_list = ['喜悦', '愤怒', '厌恶', '低落']
num_class = len(class_list)

# 初始化模型并移动到指定设备
model = TextRNN.Model(embedding_pretrained, len(vocab), embed, num_class).to(device)
这段代码初始化了我们的文本分类模型:
- 模型使用之前定义的 TextRNN 架构(LSTM 基础)
- 传入预训练词向量、词汇表大小、词向量维度和类别数量等参数
- 通过
.to(device)将模型移动到之前选择的计算设备上
我们的系统可以识别四种情感类别,这与数据集的标注相对应。
6. 模型训练与预测
python
# 训练模型
train(model, train_iter, dev_iter, test_iter, class_list)

# 测试单个样本
test_sample('哈哈简直太搞笑了', model)最后,代码调用train()函数开始模型训练过程,训练完成后使用test_sample()函数对一个示例句子 "哈哈简直太搞笑了" 进行情感预测。
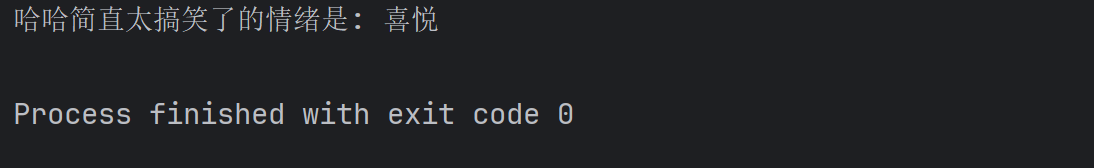
根据句子内容,我们预期模型会将其分类为 "喜悦" 类别,这可以验证模型的实际效果。
系统工作流程总结
整个文本情感分类系统的工作流程可以概括为:
- 环境准备:配置计算设备,设置随机种子确保可复现性
- 数据处理:加载并分割数据集,构建词汇表,将数据转换为模型可处理的批次格式
- 模型准备:加载预训练词向量,初始化 TextRNN 模型
- 模型训练:使用训练集训练模型,通过验证集监控性能并保存最佳模型
- 模型应用:使用训练好的模型对新文本进行情感预测
这种端到端的系统设计使得从数据到预测结果的整个流程清晰可控,便于调试和优化。