大模型-详解 Vision Transformer (ViT) (2

大模型-详解 Vision Transformer (ViT) (2)

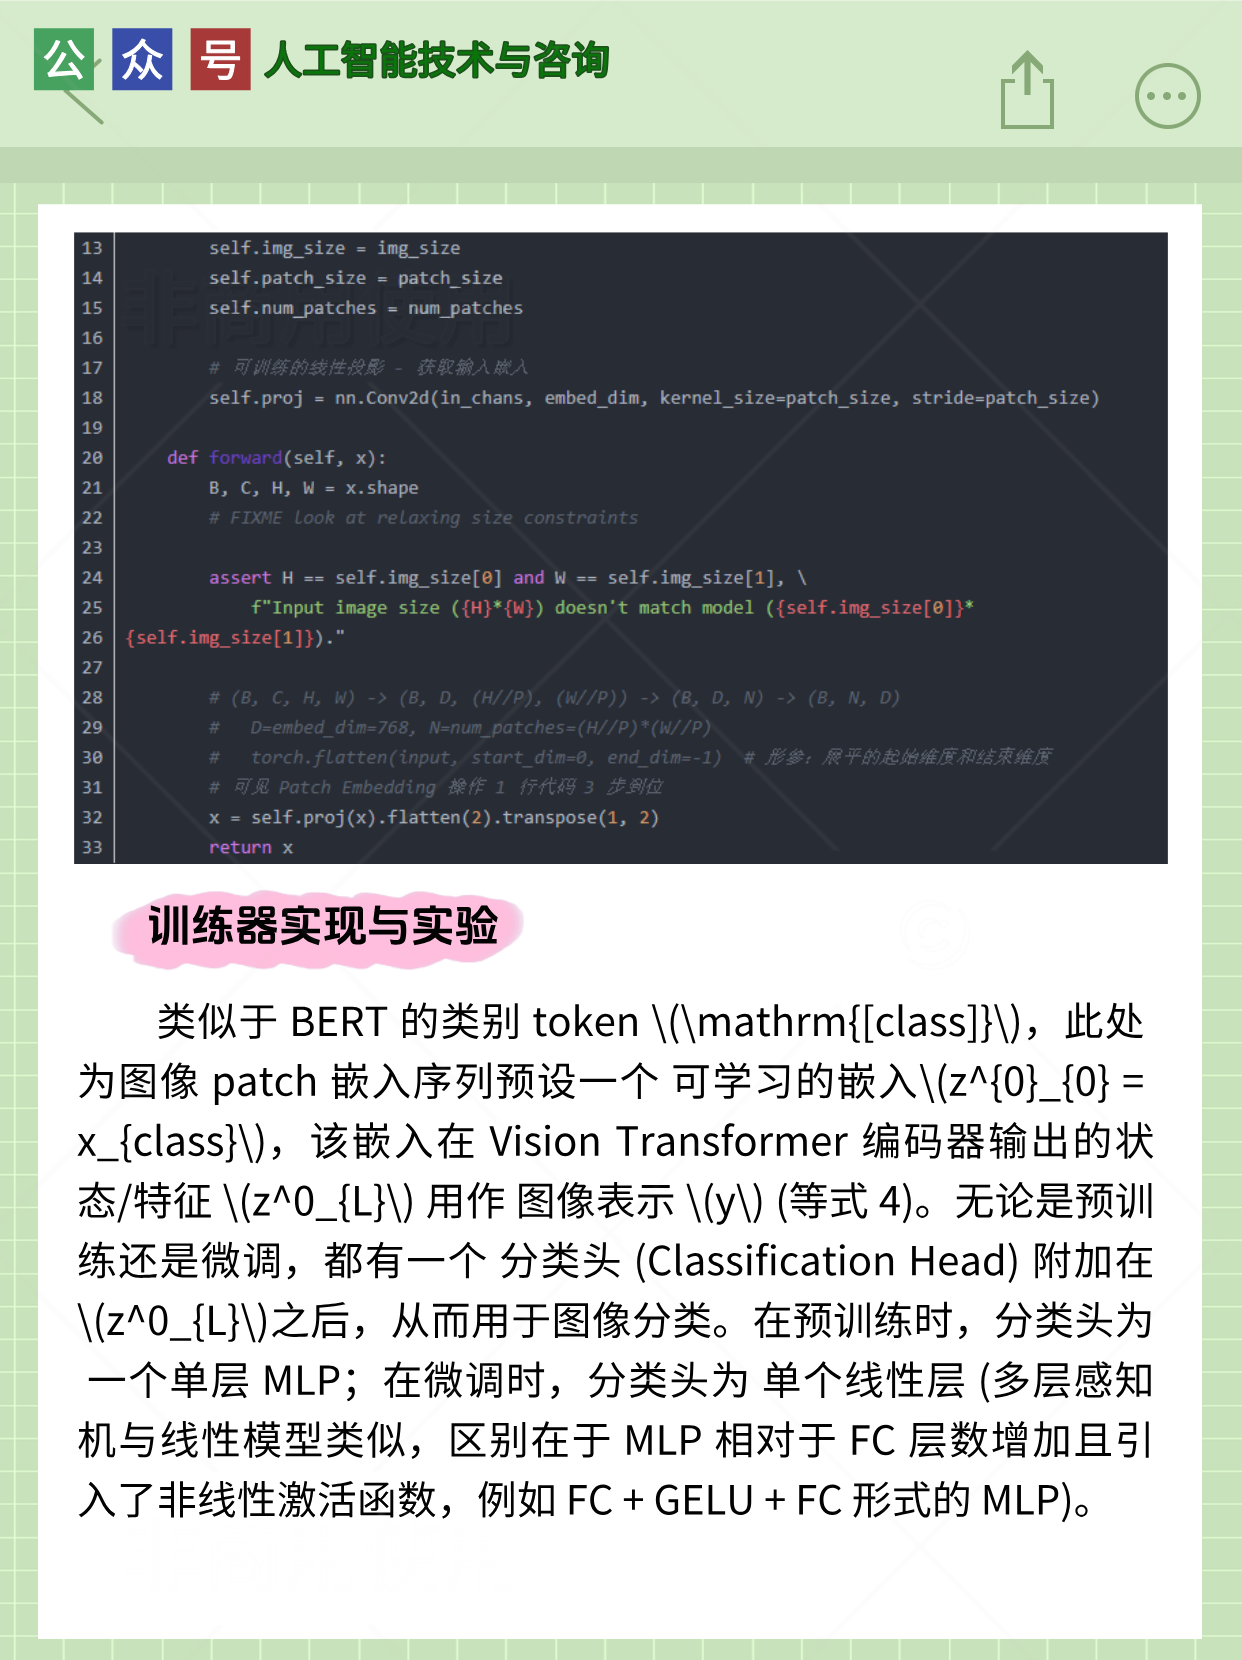
1.可学习的嵌入 (Learnable Embedding)

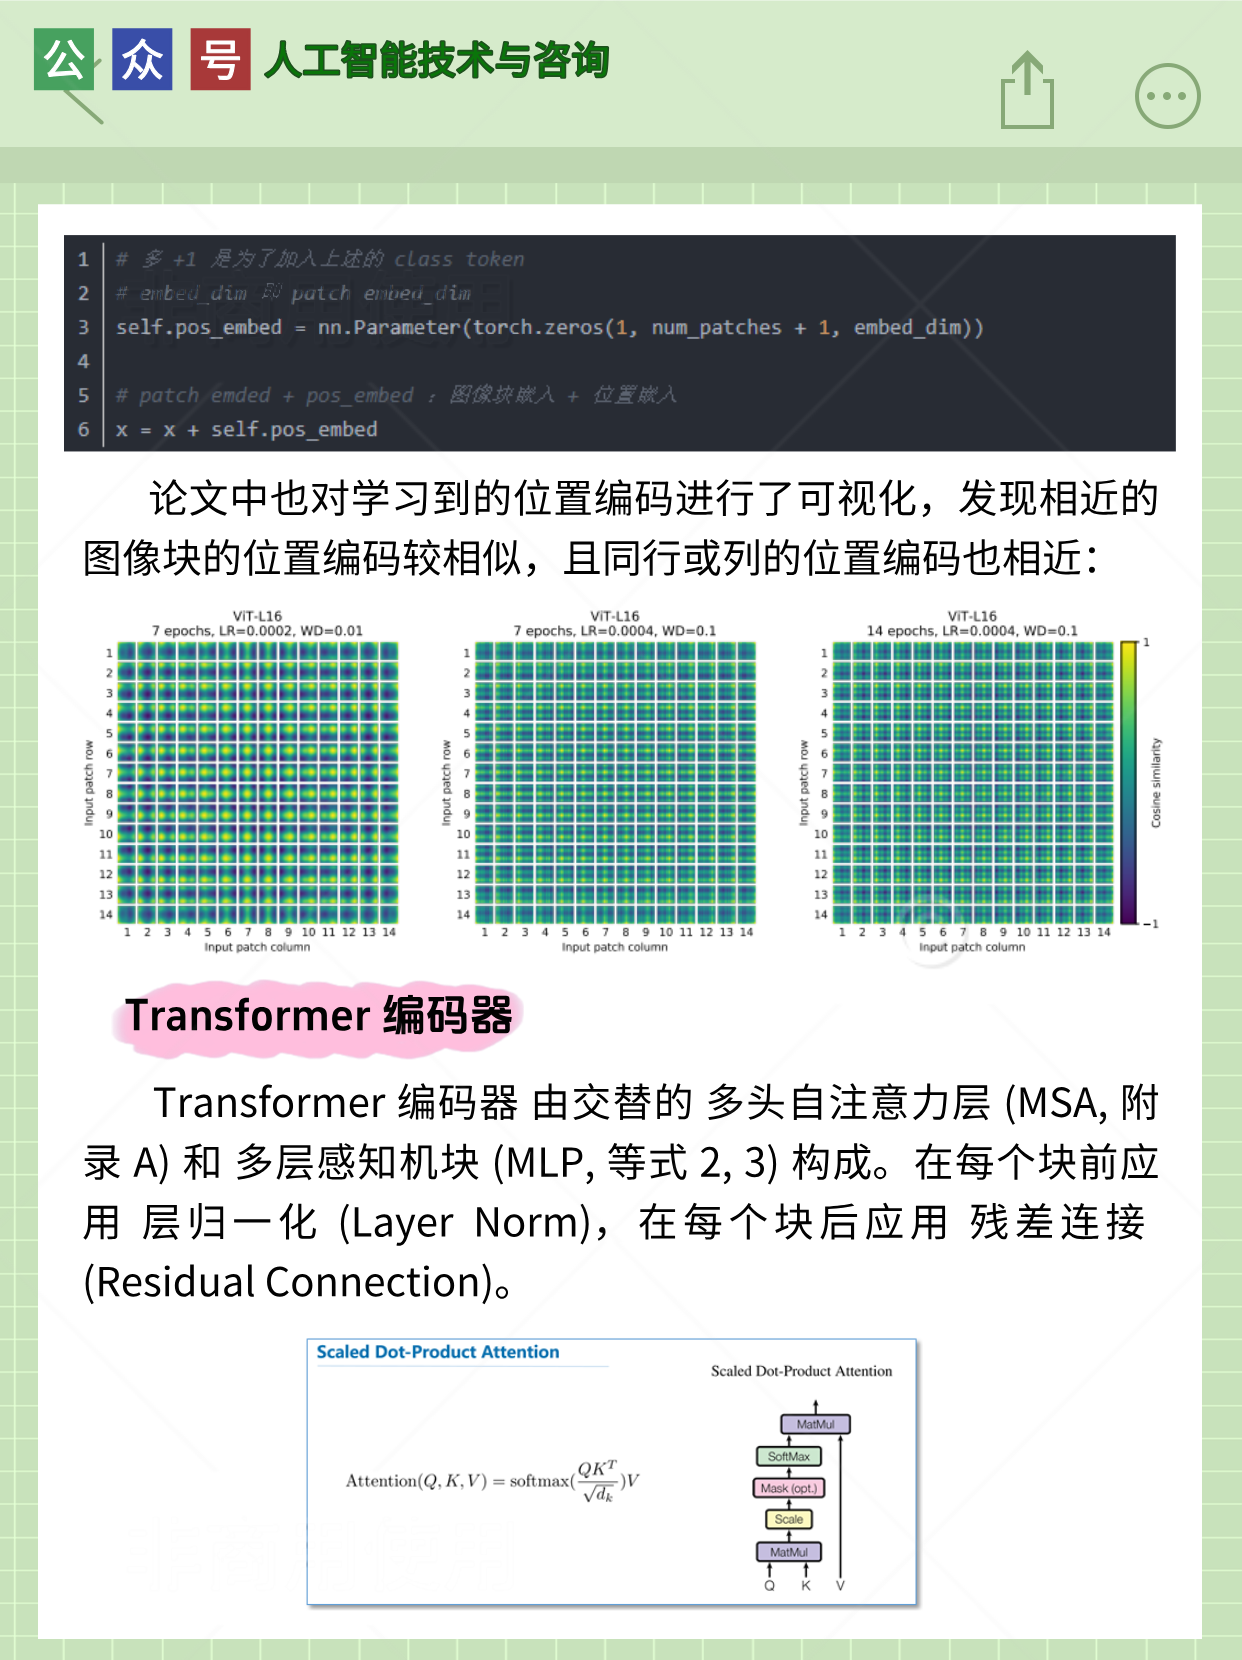
2.位置嵌入 (Position Embeddings)

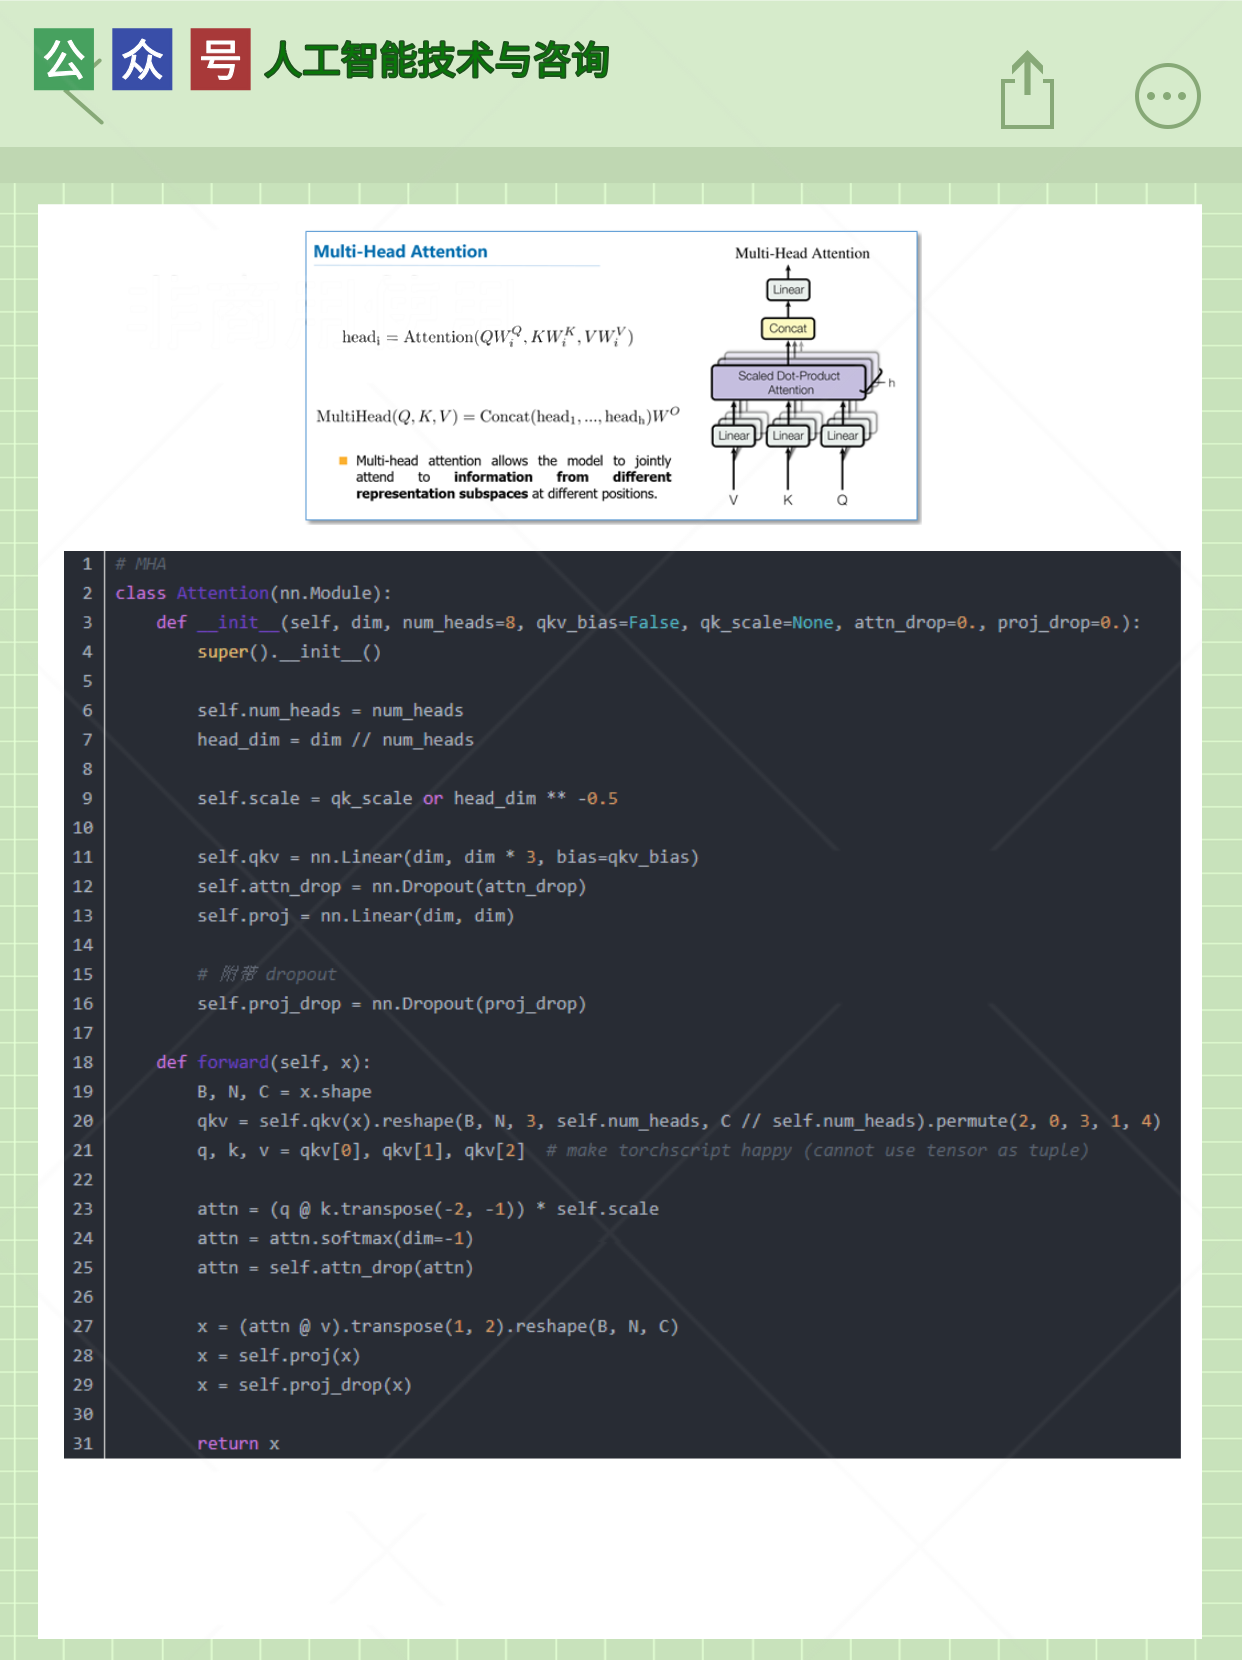
3.Transformer 编码器
相关推荐
HPtiger10 小时前
数据结构——选择排序
数据结构·算法·排序算法
for_ever_love__10 小时前
知识图谱构建流水线实战:实体关系抽取的提示词、质量抽检与增量维护
知识图谱·实体·文档·构建·rag·关系·抽取
康实训10 小时前
老年评估仿真实训平台架构设计与老年人能力评估实训室教学落地实践
大数据·人工智能·算法·实训室·实训室建设
小程故事多_8010 小时前
从 Tokenizer 到 Next Token,穿透数据流,完整理解 Transformer 底层逻辑
android·深度学习·transformer
DongQiShanRen10 小时前
六根硬件映射(四):归属澄清、两处不一致与卷十一总表
开发语言·人工智能·算法·rust·哈希算法·集成学习
CCblandy10 小时前
雪花 ID 四个边界实测:时钟回拨重号 500 个,前端 JSON.parse 直接丢精度
后端·python·算法·性能优化·架构
丑梨数据10 小时前
信创环境里跑文档工具:格式兼容与本地合规的几个坑
数据结构·人工智能·算法·决策树·排序算法
Rocky Ding*11 小时前
FLUX 3 Image Klein 技术解析:5.6B 生成器、Flow Map 蒸馏与 ComfyUI 可控编辑
论文阅读·人工智能·深度学习·机器学习·aigc·flux·ai-native
Fang_YuanAI11 小时前
AIGC胶片质感指南:影调、颗粒、halation、暗角如何一起成立
aigc·ai视频·ai生图·ai时代·ai短剧·aigc创作·胶片
erzong23112 小时前
Linux操作系统:线程概念与控制
linux·算法