一、导读
近年来,视觉-语言-动作模型(Vision-Language-Action,VLA)在机器人控制中展现出融合多模态理解与动作执行的能力。
然而,现有模型在感知图像时视觉注意力(visual attention)往往分散,难以聚焦于需要操作的目标物体,导致执行动作不准确。
为此,本文提出了一种重构式视觉-语言-动作模型 ReconVLA ,通过引入一个隐式 grounding 机制,让模型在训练过程中学习重建图像中与任务相关的"凝视区域(gaze region)",从而引导其更准确地关注目标物体。
该方法在模拟和真实机器人任务中均表现出更精准的操作能力和良好的泛化性能。
二、论文基本信息
-
论文标题:ReconVLA: Reconstructive Vision-Language-Action Model as Effective Robot Perceiver
-
作者与单位:Wenxuan Song 等,来自香港科技大学(广州)、西湖大学、浙江大学、莫纳什大学等机构
-
来源:AAAI 2026
三、主要贡献与创新
-
提出 ReconVLA ,一种基于隐式视觉 grounding 的 VLA 模型,通过重建凝视区域提升视觉注意力精度。
-
构建大规模机器人预训练数据集,包含 100k 轨迹、200 万样本,增强模型泛化能力。
-
设计视觉重构模块,使用扩散变换器(diffusion transformer)从噪声中重建目标区域。
-
在模拟与真实任务中验证了模型在长时序任务 和未见目标上的优越性能。
四、研究方法与原理
ReconVLA 的核心思路是:通过让模型重建任务相关的图像区域,引导其自动聚焦于关键目标,从而提升动作执行的精确性。
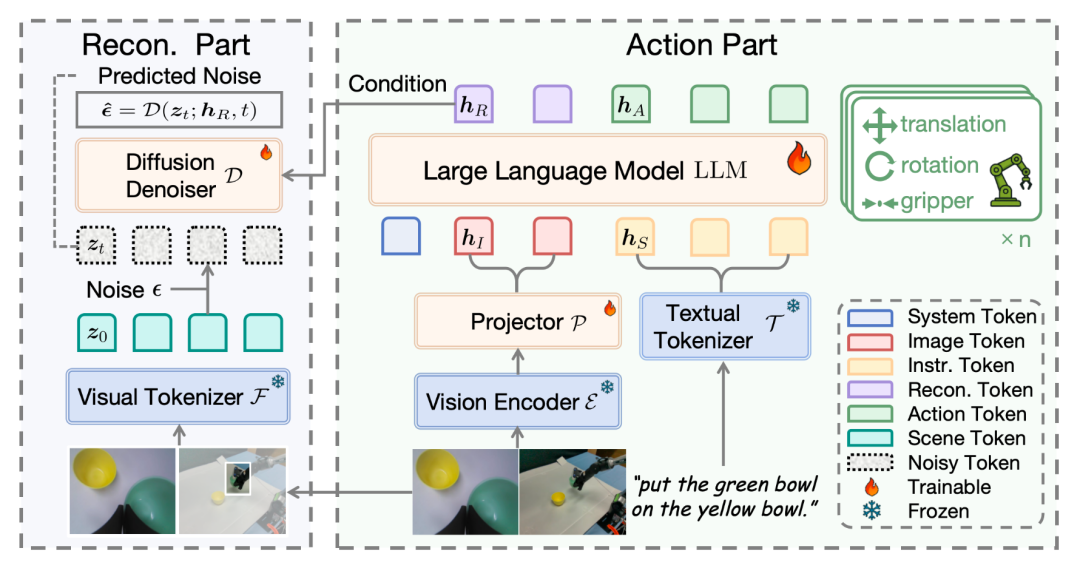
模型包含动作生成 与视觉重构 两个部分。输入为多视角图像和语言指令。视觉编码器提取图像特征,与大语言模型(LLM)交互后,一方面输出动作指令,另一方面输出重构 token(reconstructive tokens) ,用于引导一个扩散去噪过程(denoising process),重建目标区域的图像 token。
具体地,重构目标为**凝视区域 **,其 token 表示为 ,其中 是视觉 tokenizer(采用 VAE)。扩散过程从带噪声的 token 出发,在重构 token 的条件下,通过去噪器 预测噪声并恢复 。重构损失函数为:
整体训练目标为动作预测损失与视觉重构损失的加权和:
其中 是由大语言模型基于视觉 tokens 生成的重构 tokens, 是扩散时间步, 是加入的噪声。这一设计迫使模型在生成动作的同时,必须学习对目标区域的精细视觉表征,从而实现隐式的视觉注意力聚焦。
五、实验设计与结果分析
模拟环境与数据集
实验使用 CALVIN 基准 ,包含 34 个任务和 4 种环境,评估模型在长时序任务 中的表现。指标为子任务成功率 与平均完成长度。
范式对比实验
比较三种视觉 grounding 范式:
-
显式 grounding(EG):使用 YOLOv11 检测并裁剪目标区域作为额外输入。
-
链式思维 grounding(CG):模型依次输出边界框坐标与动作。
-
隐式 grounding(IG,即 ReconVLA):不显式输出坐标,而是通过重建目标区域隐式学习注意力。
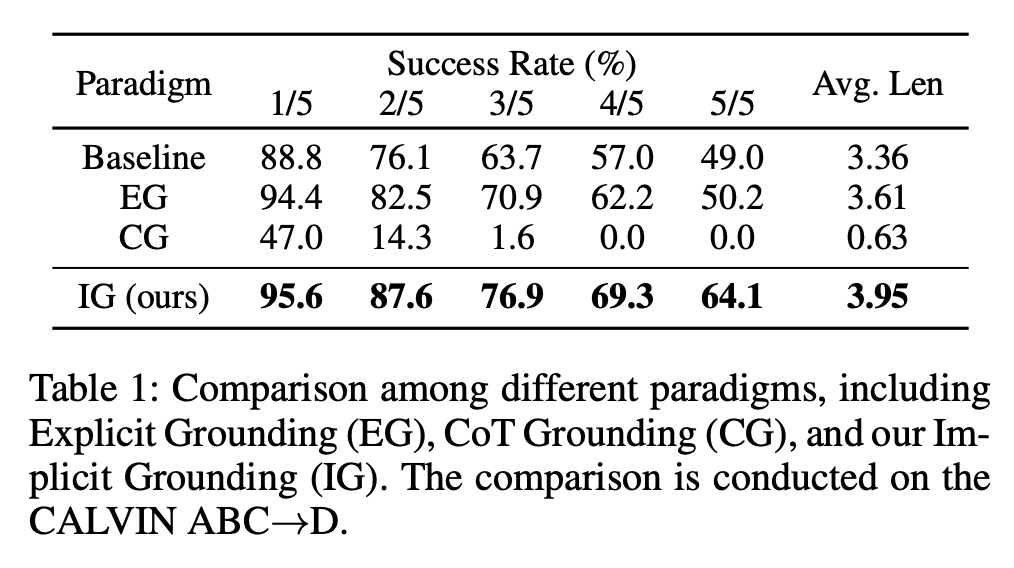
结果显示,IG 在各项任务中均取得最高成功率,尤其在 5/5 任务中达到 **64.1%**,显著优于 EG(50.2%)和 CG(0%)。
注意力可视化分析
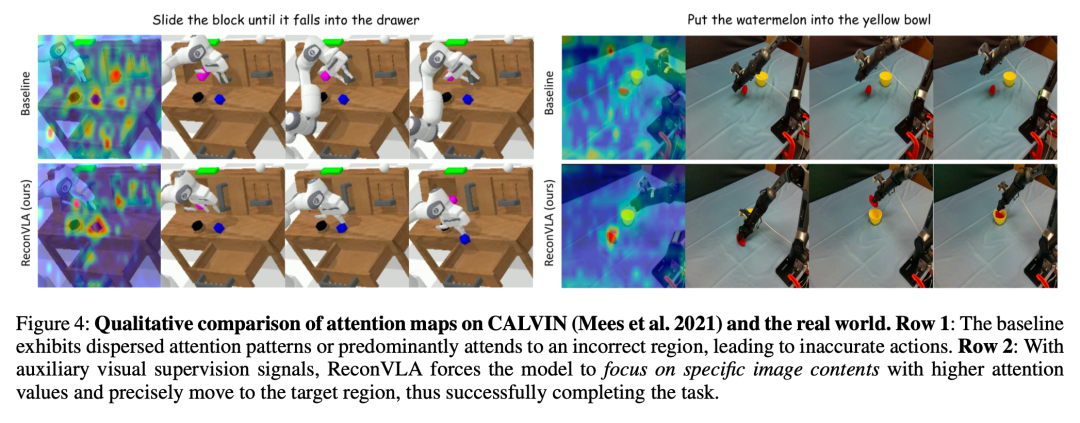
可视化显示,基线模型的注意力分散,而 ReconVLA 能精准聚焦于目标物体,如"将西瓜放入黄碗"任务中,注意力集中在西瓜上。
消融实验
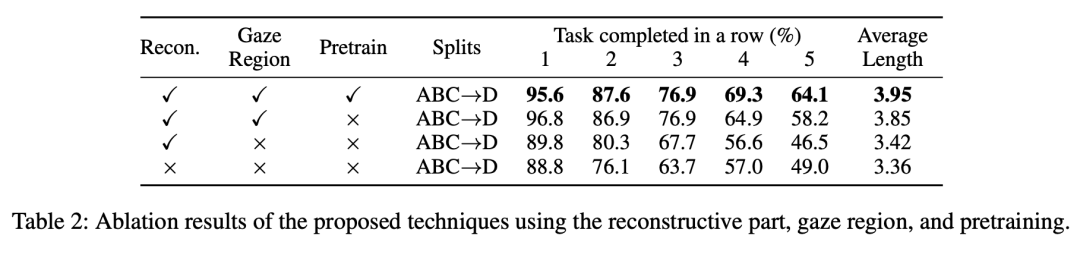
消融实验验证了以下设计:
-
预训练:显著提升模型在未见环境中的泛化能力。
-
重建凝视区域:比重建整图更有效,引导模型关注目标。
-
重构模块本身:即使重建整图也能提升性能,但不如凝视区域精准。
与先进方法对比
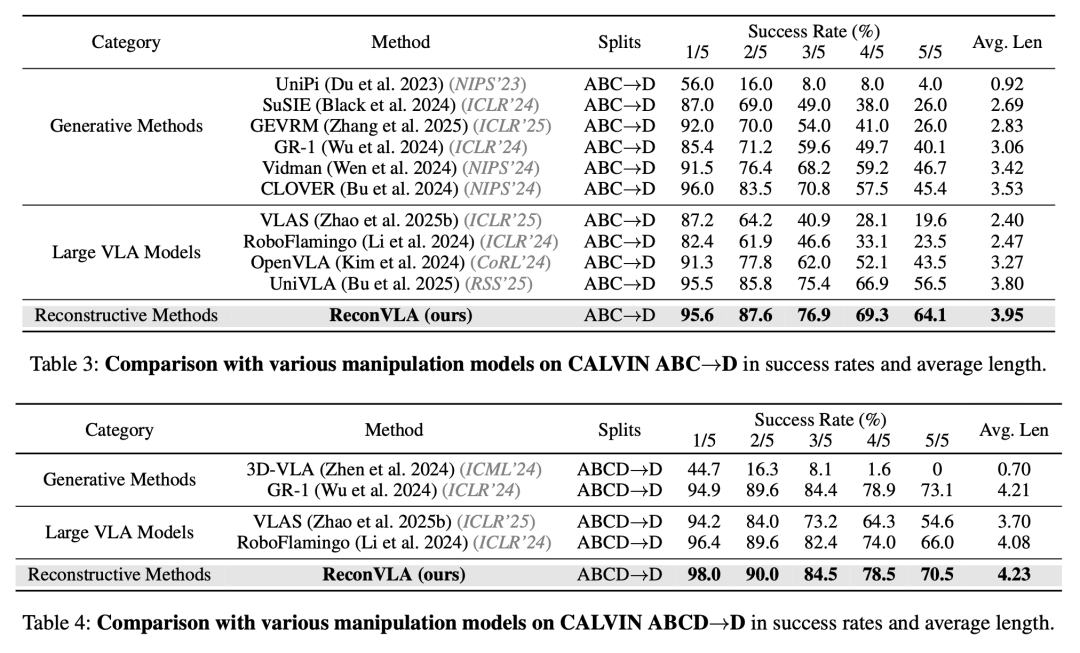
在 ABC→D 和 ABCD→D 任务中,ReconVLA 在多项指标上超越生成式方法(如 GR-1、3D-VLA)和大规模 VLA 模型(如 OpenVLA、UniVLA),尤其在长时序任务中表现突出。
真实世界实验
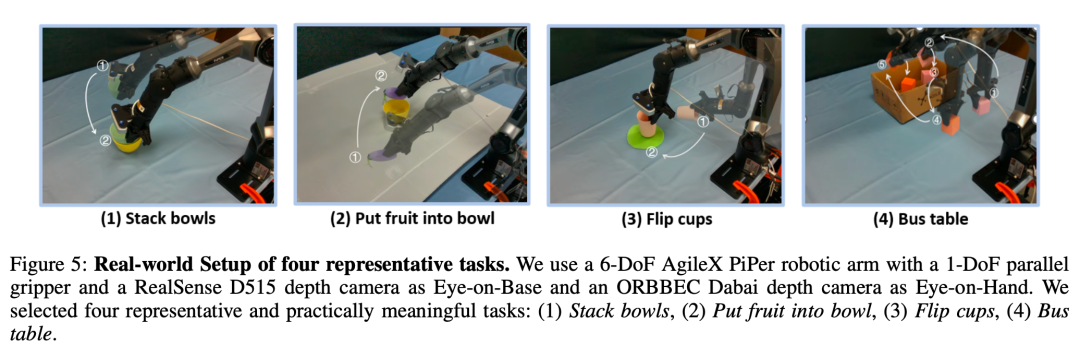
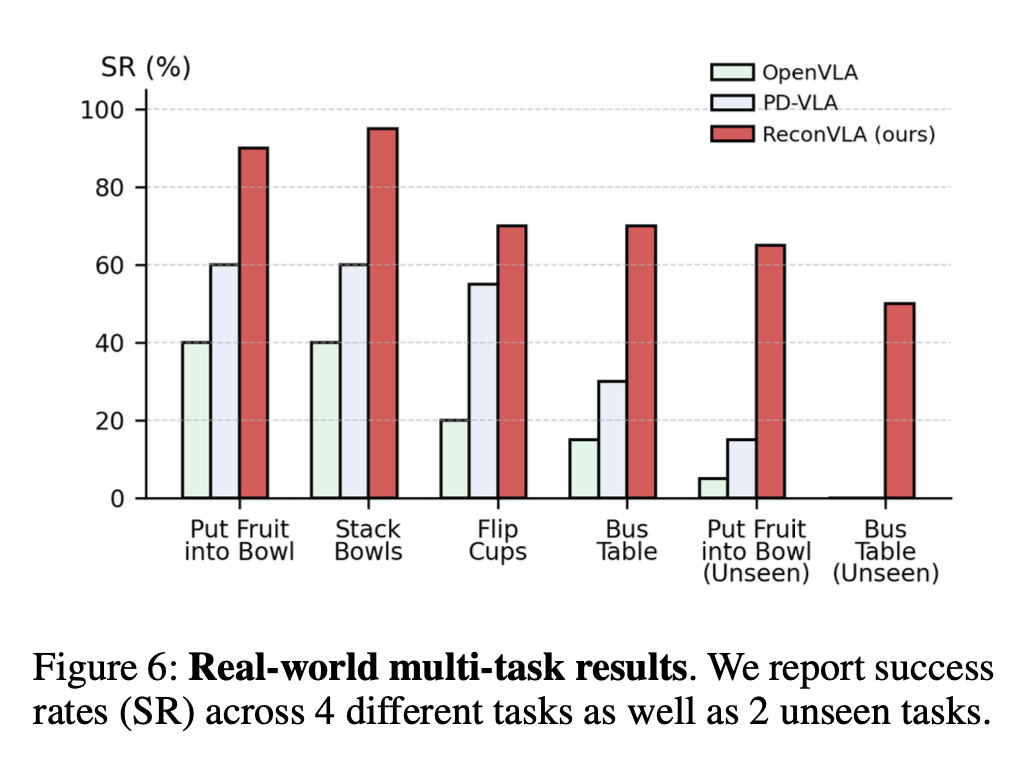
在四个真实任务(如叠碗、翻杯等)中,ReconVLA 在未见目标上仍保持高成功率,显著优于 OpenVLA 和 PD-VLA。
六、论文结论与评价
总结
ReconVLA 通过隐式视觉 grounding 机制,成功引导模型聚焦于任务关键区域,提升了机器人操作的精确性与泛化能力。在模拟与真实任务中均表现出色,尤其在长时序和未见目标任务中优势明显。
评价
该方法无需依赖外部检测模型 ,简化了系统结构,且通过视觉重构任务 增强了模型对细节的感知能力。然而,该方法依赖于高质量凝视区域标注 ,且扩散去噪过程计算开销较大,可能限制其在实时系统中的部署。未来可探索更轻量的重构机制,或结合自监督方式减少对标注数据的依赖。