基于锚点(聚类)的LLM微调

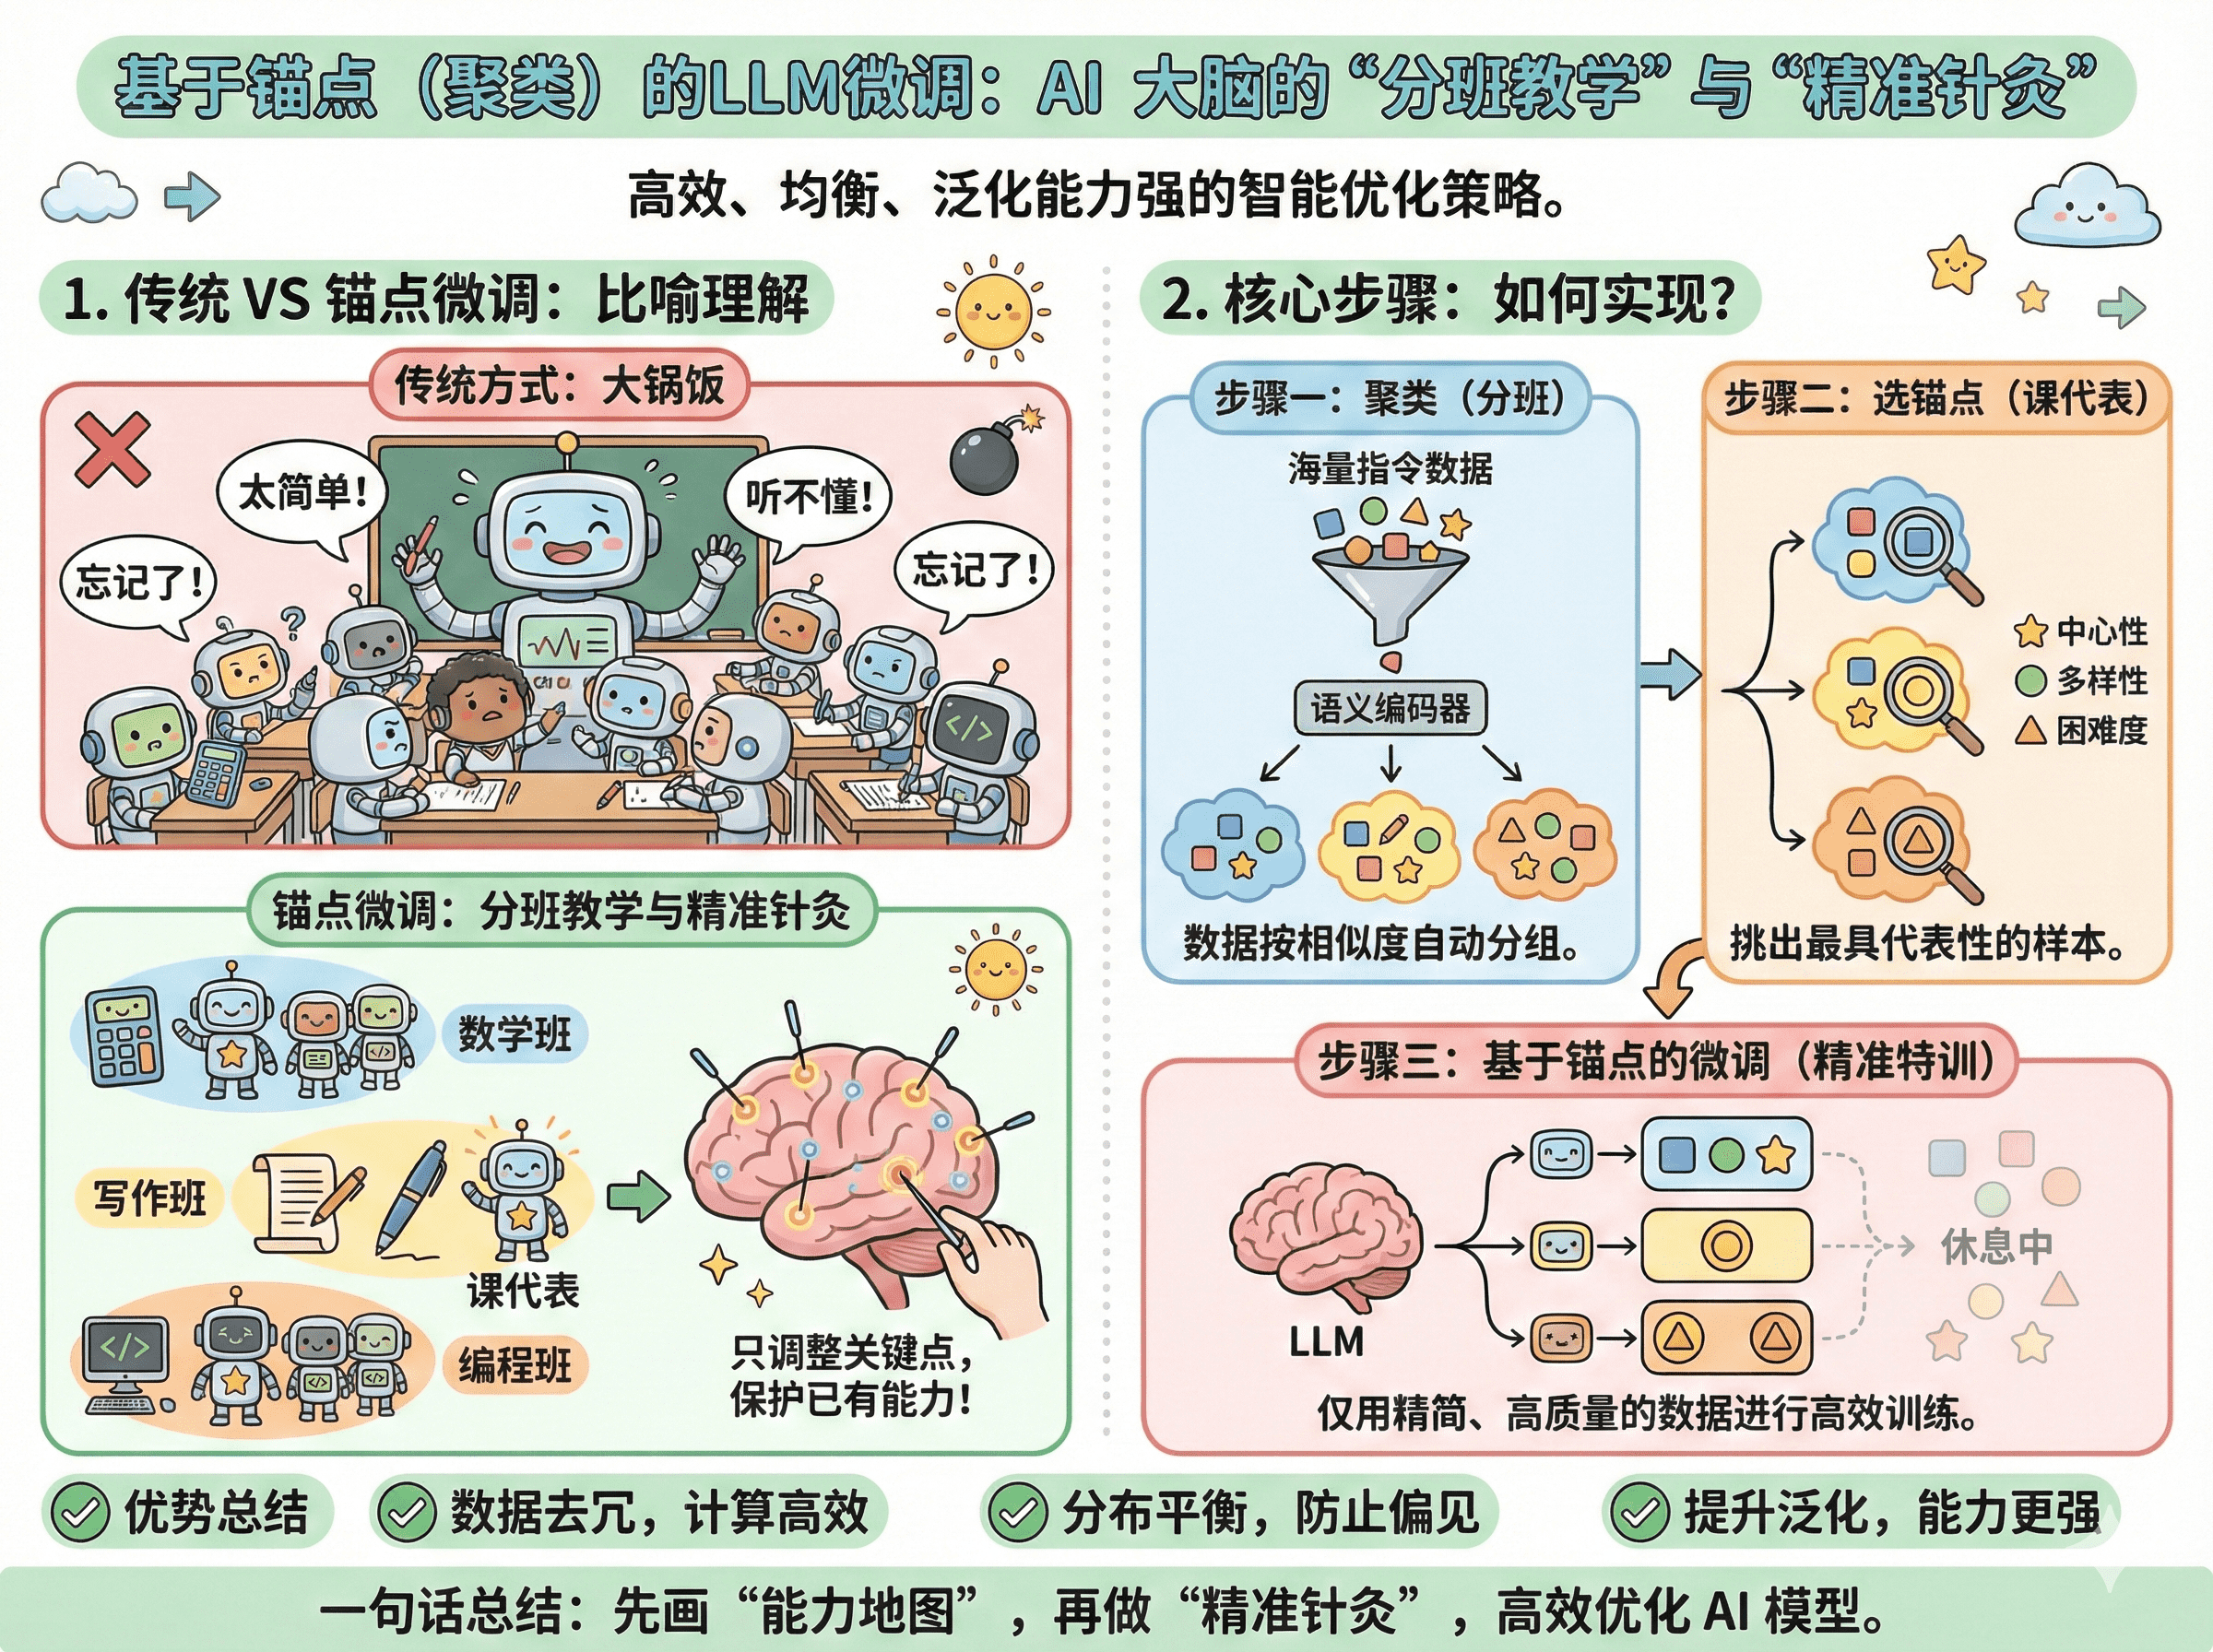
这是一种在大规模指令数据集上进行高效、高质量微调的策略。其核心思想是先对海量、多样的指令数据进行结构化分组,再选取最具代表性的样本进行微调,以避免数据冗余、平衡数据分布,并提升模型泛化能力。

比喻理解:

想象你要学习"世界美食"(微调模型),传统方法是给你一本包含十万道菜谱的厚书(全量数据),里面有很多重复或相似的菜。

基于锚点的方法则是:先让一位美食家(聚类算法)将这十万道菜按菜系(中、法、意、日等)和烹饪方式(烘焙、烧烤、蒸煮等)自动分成几百个类别(簇)。然后从每个类别中精心挑选出1-2道最经典、最能体现该类特色的招牌菜(锚点)。最后,你只需要学习这精选出来的几百道招牌菜,就能高效、系统地掌握世界美食的核心技艺与精髓,并能举一反三,创作出新菜品。
相关推荐
sbjdhjd2 小时前
从黑板事实到长链路剪枝:AI 渗透测试 Agent 的实验、失效与改造
人工智能·网络安全·数据挖掘·php·agent·剪枝·1024程序员节
Young Doro10 小时前
独立性检测学习任务
人工智能·学习·数据挖掘
Kari1111 小时前
AI 手写 OCR 在教育场景的工程化:为什么准确率从 82% 做到 99% 这么难
人工智能·深度学习·机器学习
数聚天成DeepSData11 小时前
两批标注数据合并前要核对什么
人工智能·深度学习·机器学习·数据集·deepsdata
forest_0912 小时前
Agent 系列 21|部署、发布与运维:把 Agent 变成一个能上线、能放量、能撤回的服务
人工智能·机器学习·架构·prompt·agi
Yula993313 小时前
从“撰写耗时”到“认知卸载”:企业邮件AI的效率边界与工程化路径
人工智能·神经网络·机器学习·数据挖掘·系统安全·信息与通信
方方洛13 小时前
ray教程-11-可观测性与调试
人工智能·分布式·机器学习
ComputerInBook13 小时前
泛函分析概观
人工智能·算法·机器学习·泛函分析
一一哥Sun14 小时前
IVF倒排索引:先看目录,再翻书
人工智能·深度学习·机器学习