请你设计并实现一个满足 LRU (最近最少使用) 缓存 约束的数据结构。
实现 LRUCache 类:
LRUCache(int capacity)以 正整数 作为容量capacity初始化 LRU 缓存int get(int key)如果关键字key存在于缓存中,则返回关键字的值,否则返回-1。void put(int key, int value)如果关键字key已经存在,则变更其数据值value;如果不存在,则向缓存中插入该组key-value。如果插入操作导致关键字数量超过capacity,则应该 逐出 最久未使用的关键字。
函数 get 和 put 必须以 O(1) 的平均时间复杂度运行。
示例:
输入
["LRUCache", "put", "put", "get", "put", "get", "put", "get", "get", "get"]
[[2], [1, 1], [2, 2], [1], [3, 3], [2], [4, 4], [1], [3], [4]]
输出
[null, null, null, 1, null, -1, null, -1, 3, 4]

解释
LRUCache lRUCache = new LRUCache(2);
lRUCache.put(1, 1); // 缓存是 {1=1}
lRUCache.put(2, 2); // 缓存是 {1=1, 2=2}
lRUCache.get(1);    // 返回 1
lRUCache.put(3, 3); // 该操作会使得关键字 2 作废,缓存是 {1=1, 3=3}
lRUCache.get(2);    // 返回 -1 (未找到)
lRUCache.put(4, 4); // 该操作会使得关键字 1 作废,缓存是 {4=4, 3=3}
lRUCache.get(1);    // 返回 -1 (未找到)
lRUCache.get(3);    // 返回 3
lRUCache.get(4);    // 返回 4
提示:
1 <= capacity <= 30000 <= key <= 100000 <= value <=- 最多调用
2 * 105次get和put
解题思路
- 数据结构选择 :
OrderedDict既保留了哈希表的 O (1) 查找特性,又维护了元素的插入顺序,通过move_to_end和popitem可以在 O (1) 时间内完成「标记最近使用」和「淘汰最久未使用」的操作。 get操作 :- 若 key 不存在,直接返回
-1。 - 若 key 存在,将其移动到字典末尾(标记为「最近使用」),再返回对应值。
- 若 key 不存在,直接返回
put操作 :- 若 key 已存在,更新值并移动到末尾(标记为「最近使用」)。
- 若 key 不存在,直接添加到末尾。
- 若添加后超出容量,删除字典头部的元素(最久未使用的键)。
复杂度分析
- 时间复杂度 :
get和put操作均为 O(1) ,因为OrderedDict的move_to_end、popitem和哈希表的增删改查都是 O (1) 时间。 - 空间复杂度 :O(capacity) ,最多存储
capacity个键值对。
Python代码
python
from collections import OrderedDict

class LRUCache:

    def __init__(self, capacity: int):
        self.cache = OrderedDict()
        self.capacity = capacity

    def get(self, key: int) -> int:
        if key not in self.cache:
            return -1
        # 将访问的键移到末尾,表示最近使用
        self.cache.move_to_end(key)
        return self.cache[key]

    def put(self, key: int, value: int) -> None:
        if key in self.cache:
            # 键已存在,更新值并移到末尾
            self.cache.move_to_end(key)
        self.cache[key] = value
        # 检查容量,超出则删除最久未使用的键(头部元素)
        if len(self.cache) > self.capacity:
            self.cache.popitem(last=False)

# ------------------------------ 测试驱动代码 ------------------------------
def run_operations(ops, params):
    """
    执行操作序列,返回每个操作的结果
    :param ops: 操作类型列表(如["LRUCache", "put", "get"])
    :param params: 对应每个操作的参数列表
    :return: 操作结果列表,与题目输出格式一致
    """
    obj = None
    result = []
    for op, param in zip(ops, params):
        if op == "LRUCache":
            obj = LRUCache(*param)
            result.append(None)
        elif op == "get":
            res = obj.get(*param)
            result.append(res)
        elif op == "put":
            obj.put(*param)
            result.append(None)
    return result

# 题目示例输入
if __name__ == "__main__":
    ops = ["LRUCache","put","put","get","put","get","put","get","get","get"]
    params = [[2],[1,1],[2,2],[1],[3,3],[2],[4,4],[1],[3],[4]]
    # 执行并打印结果
    output = run_operations(ops, params)
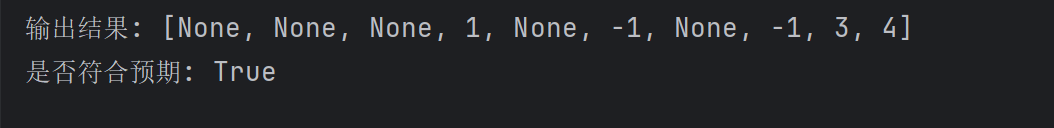
    print("输出结果:", output)
    # 验证是否与题目输出一致
    expected = [None, None, None, 1, None, -1, None, -1, 3, 4]
    print("是否符合预期:", output == expected)
LeetCode提交代码
python
class LRUCache:

    def __init__(self, capacity: int):
        self.cache = OrderedDict()
        self.capacity = capacity

    def get(self, key: int) -> int:
        if key not in self.cache:
            return -1
        # 将访问的键移到末尾,表示最近使用
        self.cache.move_to_end(key)
        return self.cache[key]

    def put(self, key: int, value: int) -> None:
        if key in self.cache:
            # 键已存在,更新值并移到末尾
            self.cache.move_to_end(key)
        self.cache[key] = value
        # 检查容量,超出则删除最久未使用的键(头部元素)
        if len(self.cache) > self.capacity:
            self.cache.popitem(last=False)


# Your LRUCache object will be instantiated and called as such:
# obj = LRUCache(capacity)
# param_1 = obj.get(key)
# obj.put(key,value)
程序运行截图展示
总结
本文介绍了LRU缓存机制的实现方法。通过使用Python的OrderedDict数据结构,既保证了O(1)时间复杂度的查找操作,又维护了元素的访问顺序。当缓存容量超出时,自动淘汰最久未使用的元素。该实现满足题目要求的get和put操作均为O(1)时间复杂度,并通过测试用例验证了正确性。关键点在于利用OrderedDict的move_to_end和popitem方法高效处理最近访问标记和元素淘汰。