文章目录
一、数据准备与预处理
首先我们需要从文本文件中读取数据并进行预处理。在这个示例中,我们使用了一篇关于AI发展的英文报道作为训练数据。
python
with open("AI报道.txt", "r", encoding="utf-8") as f:
raw_text = f.read().split()这段代码打开名为"AI报道.txt"的文件,读取全部内容后使用split()方法按空格分割成单词列表。这样的处理方式简单直接,适合英文文本。
超参数设置
python
CONTEXT_SIZE = 4CONTEXT_SIZE定义了N-Gram模型中的N值,这里设置为4,意味着模型将使用前4个单词来预测下一个单词。这个参数的选择需要在模型复杂度和训练效果之间取得平衡:较大的上下文能捕捉更长的依赖关系,但也会增加模型复杂度和计算成本。
词汇表构建
python
vocab = set(raw_text)
vocab_size = len(vocab)

word_to_idx = {word: i for i, word in enumerate(vocab)}
idx_to_word = {i: word for i, word in enumerate(vocab)}
这里使用集合(set)去重来构建词汇表,然后创建了两个重要的映射字典:
word_to_idx:将单词映射到唯一的整数索引idx_to_word:将整数索引映射回原始单词
这两个字典在模型的输入输出转换中起着关键作用。
训练数据构建
python
data = []
for i in range(CONTEXT_SIZE, len(raw_text) - 1):
    context = raw_text[i - CONTEXT_SIZE:i]
    target = raw_text[i]
    data.append((context, target))
这段代码创建了训练数据集。对于文本中的每个位置(从第5个单词开始到倒数第二个单词),提取前4个单词作为上下文,当前单词作为预测目标。例如,对于文本"AI is transforming industries",当i=5时,context="AI", "is", "transforming", "industries",target="and"。
上下文向量化函数
python
def make_context_vector(context, word_to_ix):
    idxs = [word_to_ix[w] for w in context]
    return torch.tensor(idxs, dtype=torch.long)
这个辅助函数将文本形式的上下文转换为模型可以处理的张量格式。它接收单词列表和单词到索引的映射字典,返回包含对应索引的PyTorch张量。
二、模型架构设计
N-Gram模型类定义
python
class NGramModel(nn.Module):
    def __init__(self, vocab_size, embedding_dim):
        super(NGramModel, self).__init__()
        self.embeddings = nn.Embedding(vocab_size, embedding_dim)
        self.proj = nn.Linear(embedding_dim * CONTEXT_SIZE, 128)
        self.output = nn.Linear(128, vocab_size)

    def forward(self, inputs):
        embeds = self.embeddings(inputs).view(1, -1)
        out = F.relu(self.proj(embeds))
        out = self.output(out)
        log_prob = F.log_softmax(out, dim=-1)
        return log_prob
这是一个经典的神经网络语言模型,包含以下关键组件:
1. 嵌入层(Embedding Layer)
python
self.embeddings = nn.Embedding(vocab_size, embedding_dim)嵌入层的作用是将离散的单词索引转换为连续的向量表示。每个单词都会被映射到一个20维的向量空间中(这里embedding_dim=20)。这种表示能够捕捉单词之间的语义关系,相似的单词在向量空间中距离更近。
2. 投影层(Projection Layer)
python
self.proj = nn.Linear(embedding_dim * CONTEXT_SIZE, 128)由于上下文包含4个单词,每个单词用20维向量表示,所以拼接后的上下文向量长度为80。这个线性层将这80维的特征映射到128维的隐藏表示,帮助模型学习更复杂的特征组合。
3. 输出层(Output Layer)
python
self.output = nn.Linear(128, vocab_size)最后的线性层将128维的隐藏表示映射回词汇表大小(vocab_size)的向量,每个维度对应一个单词的得分(logits)。
前向传播过程
前向传播方法forward定义了数据在模型中的流动路径:
- 通过嵌入层将单词索引转换为向量
- 将4个单词向量展平拼接成一个长向量
- 通过ReLU激活函数的线性变换提取特征
- 通过输出层得到每个单词的得分
- 使用log_softmax转换为概率的对数形式
三、模型训练配置
设备选择
python
device = "cuda" if torch.cuda.is_available() else "cpu"
print(f"Using device: {device}")
自动检测是否有可用的GPU,优先使用GPU加速训练,否则使用CPU。
模型初始化
python
model = NGramModel(vocab_size, embedding_dim=20).to(device)创建N-Gram模型实例并将其移动到相应的设备上。这里嵌入维度设置为20,这是一个中等大小的维度,能够在表达能力和计算效率之间取得平衡。
优化器与损失函数
python
optimizer = optim.Adam(model.parameters(), lr=0.001)
loss_function = nn.NLLLoss()- 优化器:使用Adam优化器,学习率设为0.001。Adam结合了动量法和自适应学习率的优点,在实践中通常表现良好。
- 损失函数:使用负对数似然损失(NLLLoss),这与log_softmax输出相匹配。
四、训练过程
训练循环
python
model.train()
losses = []  # 恢复被注释的代码
for epoch in tqdm(range(200)):
    total_loss = 0
    for context, target in data:
        context_vector = make_context_vector(context, word_to_idx).to(device)
        target_tensor = torch.tensor([word_to_idx[target]]).to(device)

        predict = model(context_vector)
        loss = loss_function(predict, target_tensor)

        optimizer.zero_grad()
        loss.backward()
        optimizer.step()

        total_loss += loss.item()
    losses.append(total_loss)  # 恢复被注释的代码
    print(losses)  # 恢复被注释的代码
训练过程详解:
-
模式设置 :
model.train()将模型设置为训练模式,这会启用dropout和batch normalization等训练特定操作。 -
批次训练 :使用
tqdm包装训练循环,提供进度条显示。总共训练200个epoch。 -
数据准备:对于每个训练样本,将上下文转换为向量并移动到相应设备,同时将目标单词也转换为张量格式。
-
前向传播:模型根据上下文向量计算预测结果,得到每个单词的概率分布。
-
损失计算:使用负对数似然损失函数计算预测结果与真实目标之间的差异。
-
反向传播:
optimizer.zero_grad():清除之前累积的梯度loss.backward():计算当前损失的梯度optimizer.step():根据梯度更新模型参数
-
损失记录:记录每个epoch的总损失,用于监控训练过程。
五、模型评估与预测
评估模式设置
python
model.eval()model.eval()将模型切换到评估模式,这会禁用dropout和batch normalization的训练行为,确保预测的一致性。
单词预测
python
input_str = "the rise of AI"
words = input_str.strip().split()

context_vector = make_context_vector(words, word_to_idx).to(device)
predict = model(context_vector)
max_idx = predict.argmax(1).item()
predicted_word = idx_to_word[max_idx]
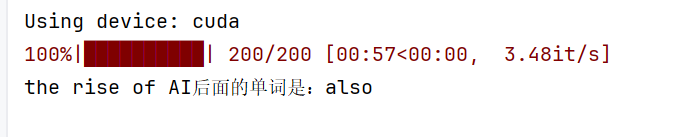
print(f"{input_str}后面的单词是:{predicted_word}")