摘要
本文解读 arXiv 2026 论文《Video Generation Models are General-Purpose Vision Learners》。该论文提出 GenCeption ,把大规模文生视频扩散模型改造为单步前馈 的通用视觉感知模型,通过统一 RGB 表示 、可学习 token 与统一 L_2 损失 ,让 8 类稠密/稀疏任务共用一个骨干与解码器,其特别之处在于仅用纯合成视频数据训练,即全面超越各任务专用 SOTA。实验表明法向 Hi4D mAE 10.99、深度 Goliath AbsRel 0.008、指代分割 MeViS J&F 70.0,且数据效率达 7\\times-500\\times,为计算机视觉的生成式预训练范式提供了系统性证据。
视频讲解 :点击观看 B 站视频
- 摘要
- 论文基本信息
- 背景与动机
- 研究主线:从问题到结论
- 基准/方法设计
- 分类全景
- 方法细节
- 实验设计与结果
- 结果对比总结
- 关键发现
- 局限性
- 常见问题(FAQ)
- [GenCeption 和 Vision Banana 有什么区别?](#GenCeption 和 Vision Banana 有什么区别?)
- [为什么视频生成预训练比 CLIP、MAE 更好?](#为什么视频生成预训练比 CLIP、MAE 更好?)
- [相机位姿怎么编码进 RGB 图像?](#相机位姿怎么编码进 RGB 图像?)
- [GenCeption 训练数据量有多大?](#GenCeption 训练数据量有多大?)
- [为什么联合训练会损害 3D 关键点?](#为什么联合训练会损害 3D 关键点?)
- [GenCeption 开源吗?](#GenCeption 开源吗?)
- 参考链接
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Video Generation Models are General-Purpose Vision Learners |
| 标题(中文) | 视频生成模型是通用视觉学习者 |
| 作者 | Letian Wang, Chuhan Zhang, Rishabh Kabra, Jasper Uijlings, Steven Waslander, Andrew Zisserman, Joao Carreira, Kaiming He, Misha Andriluka, Eduard Gabriel Bazavan, Andrei Zanfir, Cristian Sminchisescu |
| 机构 | Google DeepMind · U. Toronto · UCL · Oxford · MIT · Lund |
| 会议 | arXiv 2026 |
| arXiv | https://arxiv.org/abs/2607.09024 |
| 项目网站 | https://genception.github.io |
背景与动机
NLP 靠 next-token prediction 从任务专用模型收敛为通用基础模型;计算机视觉却仍停留在"专用模型"阶段------SAM 系列 管分割、Depth Anything 系列 管深度,每个任务都要定制架构。作者提出,通用视觉预训练需满足三条准则:时空演化 (内化 4D 因果与物理)、视觉-语言对齐 (原生继承指令跟随)、可规模化(数据与算力可扩展)。
现有工作各有短板:MAE/VideoMAE、DINO 等自监督表征缺少显式多模态对齐;CLIP/SigLIP 对齐了图文却难做视频级表征且规模受限;扩散复用路线(Marigold 、GenPercept 、Diception )多为单图单任务且依赖多步采样;视频侧 DepthCrafter/NormalCrafter 聚焦单一稠密任务;同期工作 Vision Banana 只覆盖二维图像空间。GenCeption 的关键差异是:原生视频域 + 单步前馈 + 稠密/稀疏任务统一,在标准 benchmark 上全面超越专用 SOTA。
研究主线:从问题到结论
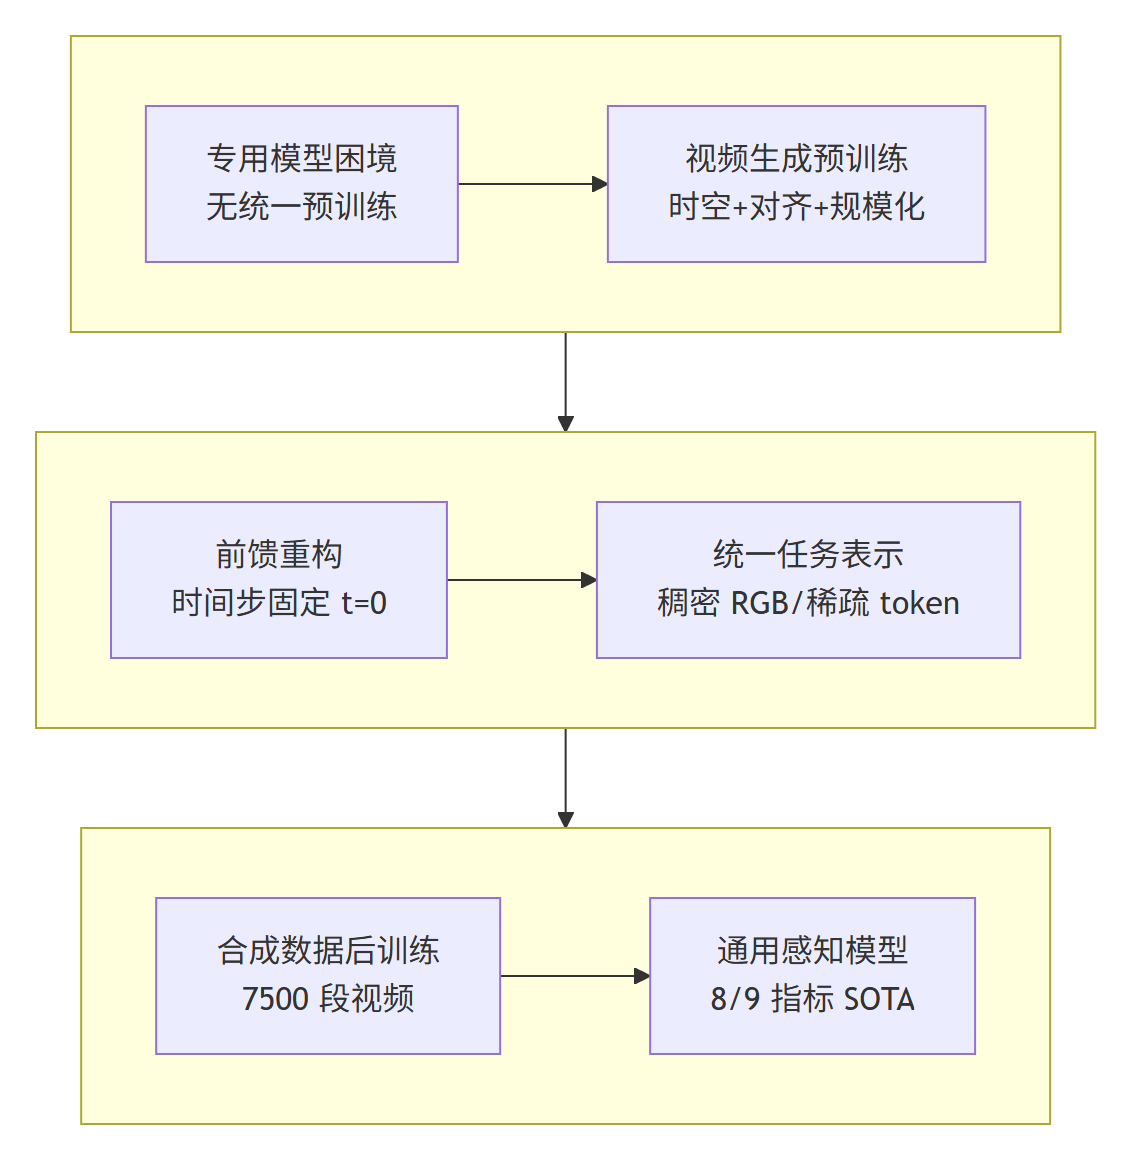
图 12:GenCeption 研究主线------从"视频生成"到"通用感知"(Mermaid 流程图)
基准/方法设计
GenCeption 的方法论由三条原则驱动:
- 多模态生成预训练即表征学习------文生视频扩散模型作通用骨干,生成高保真视频强制内化时空先验、3D 几何与物理规律,同时原生对齐视觉语言概念;为保留先验,最大化兼容原预训练范式、最小化改动。
- 任务无关的统一后训练------把感知任务视为统一的序列到序列映射,稠密任务输出编码进标准 RGB 空间(\[0,1\]),文本提示切换任务,单骨干单解码器单损失。
- 前馈重构------把多步迭代采样改造成单步确定性预测,兼顾精度与效率。
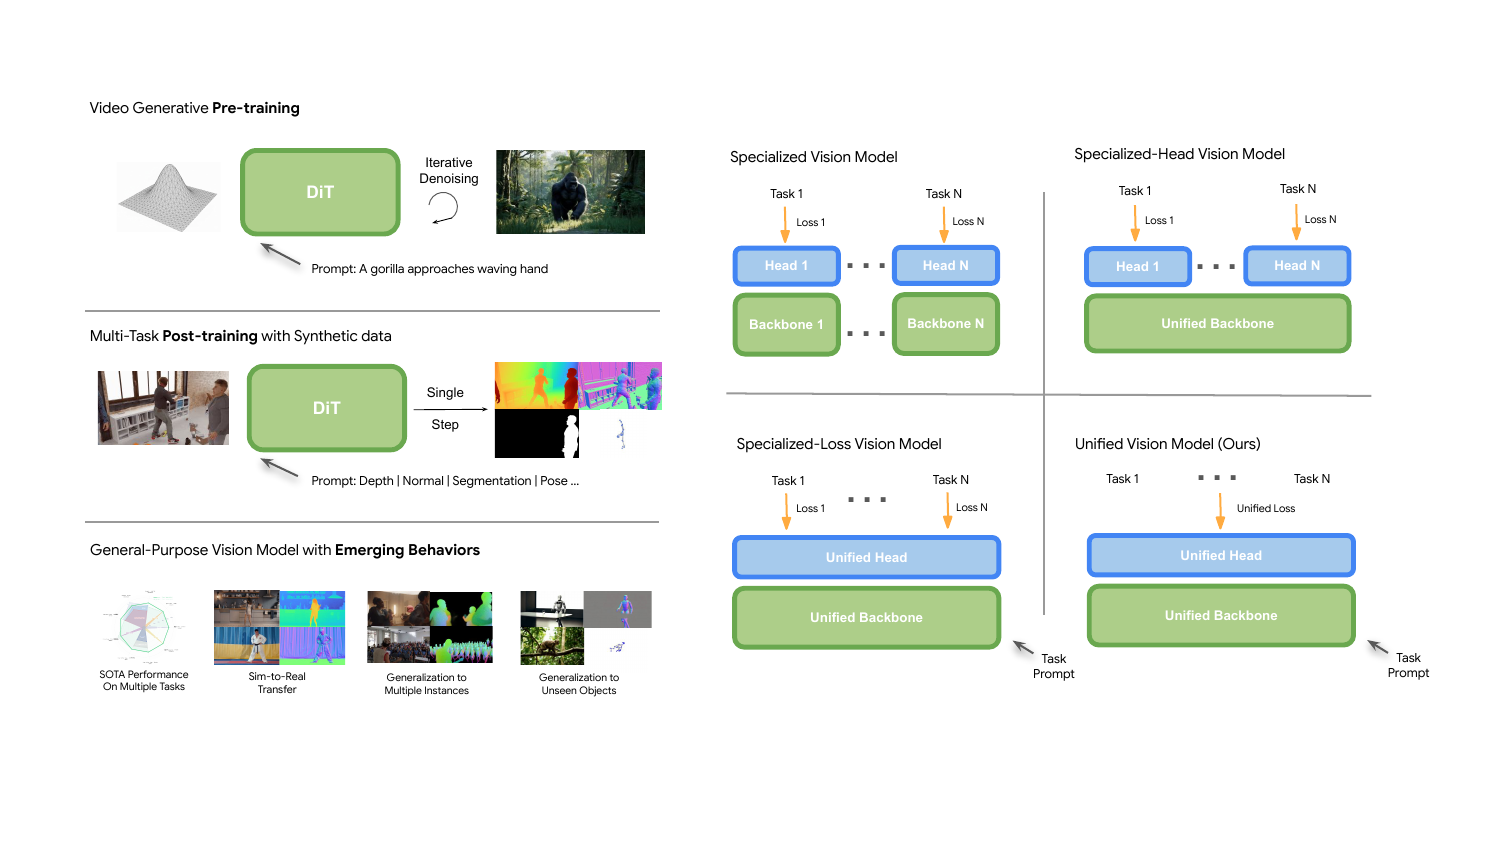
图 1:方法总览------视频生成模型作预训练基座(左),多任务后训练为前馈感知模型;右图为从专用模型到通用模型的范式转移
分类全景
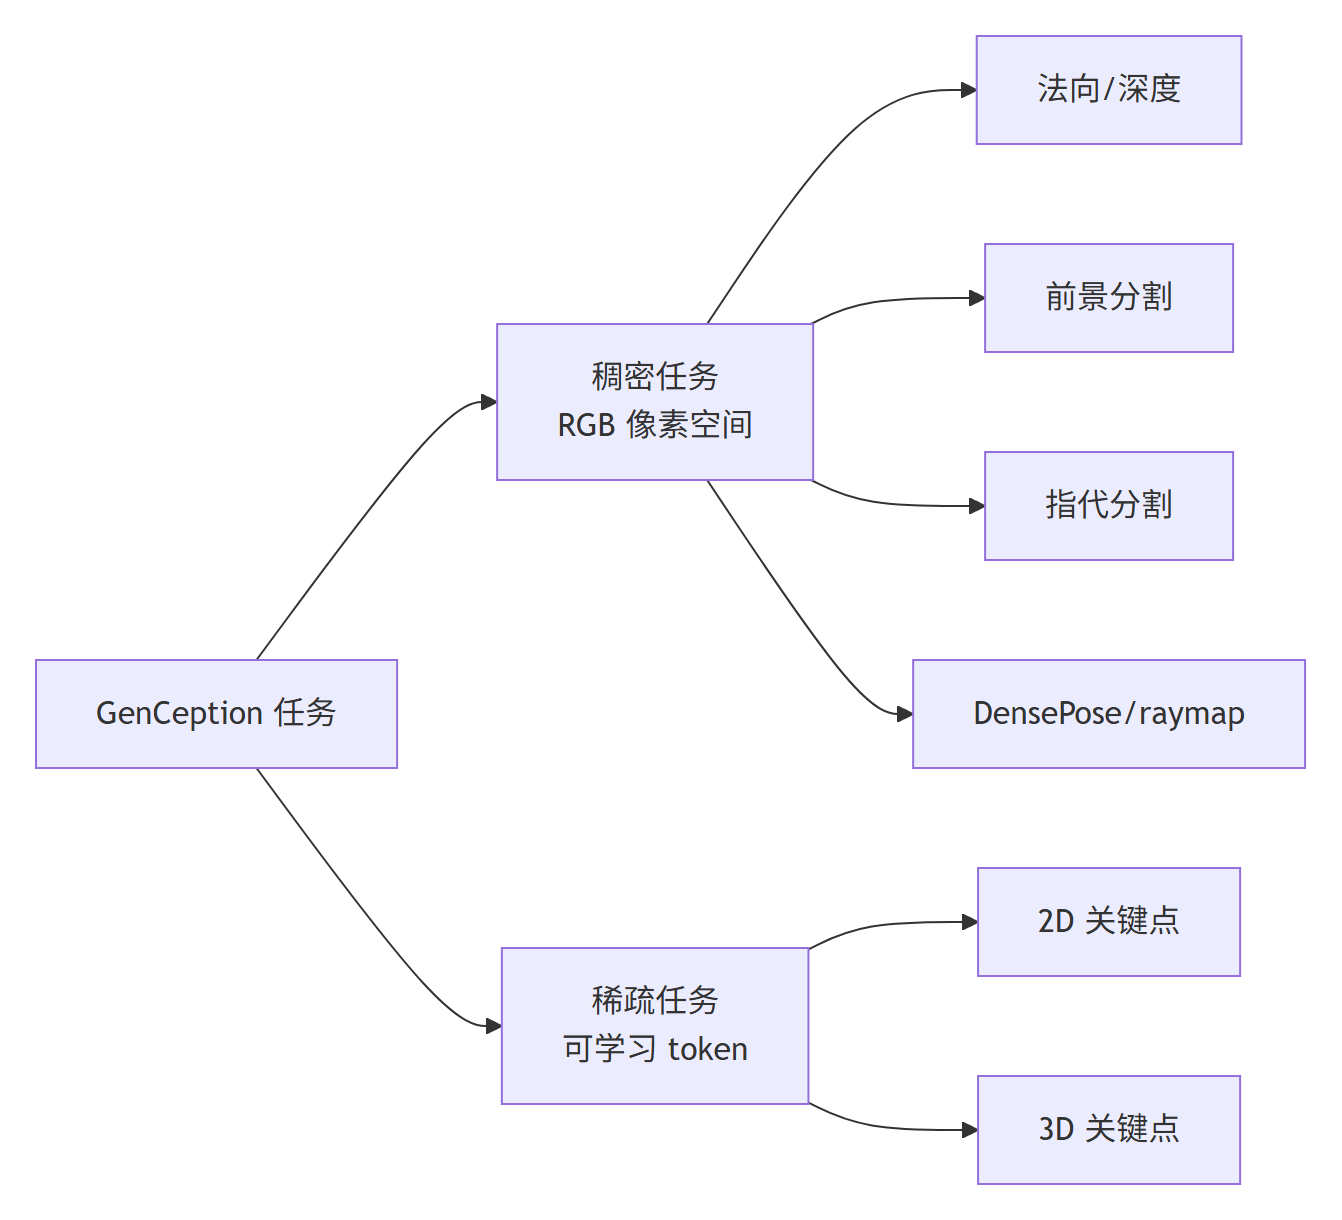
图 13:GenCeption 任务分类------稠密任务统一进 RGB 空间,稀疏任务由可学习 token 承载(Mermaid 流程图)
方法细节
前馈重构:干净视频潜在 x_0 直接输入 DiT,时间步固定 t=0(Rectified Flow 终止点);DiT 输出速度 v = \\epsilon - x_0,取负后 -v = x_0 - \\epsilon 更接近目标潜在,加速收敛。本质是把 DiT 重铸为特征提取器,特征直接取自最后一层,与解码器原生对齐。
稠密任务统一到 RGB:深度/分割单通道复制为三通道,法向/DensePose 天然三维;相机位姿以像素级 raymap 表示(6 通道),通过空间分区------中心放射线原点、四周放射线方向------压缩进 3 通道,保持单解码器框架。
稀疏任务用可学习 token:每帧追加一个可学习 query token,经 MLP 解码为 K 维坐标;沿用原生 3D RoPE(空间位置可学习),时间位置用插值压缩到预训练所见范围,优于额外注意力层方案。
数据级消歧:深度按场景中值归一化,再用非线性映射 d' = \\mathrm{clip}(\\alpha \\log(d+1), 0, 1) 压到 RGB 范围,彻底免去 scale-invariant 等专用损失------任务差异化全部下沉到数据表示。
合成数据管线:800 个 RenderPeople 模型 × 200 段 CMU 动作,Blender 多渲染通道生成 7,500 段视频,同时产出法向、深度、分割、2D/3D 关键点真值;离线预计算视频/文本潜在加速训练。训练补充 TartanAir、Virtual KITTI、MVS Synth(深度),指代分割用 MeViS/Ref-COCO/YouTube-VOS 真实数据。
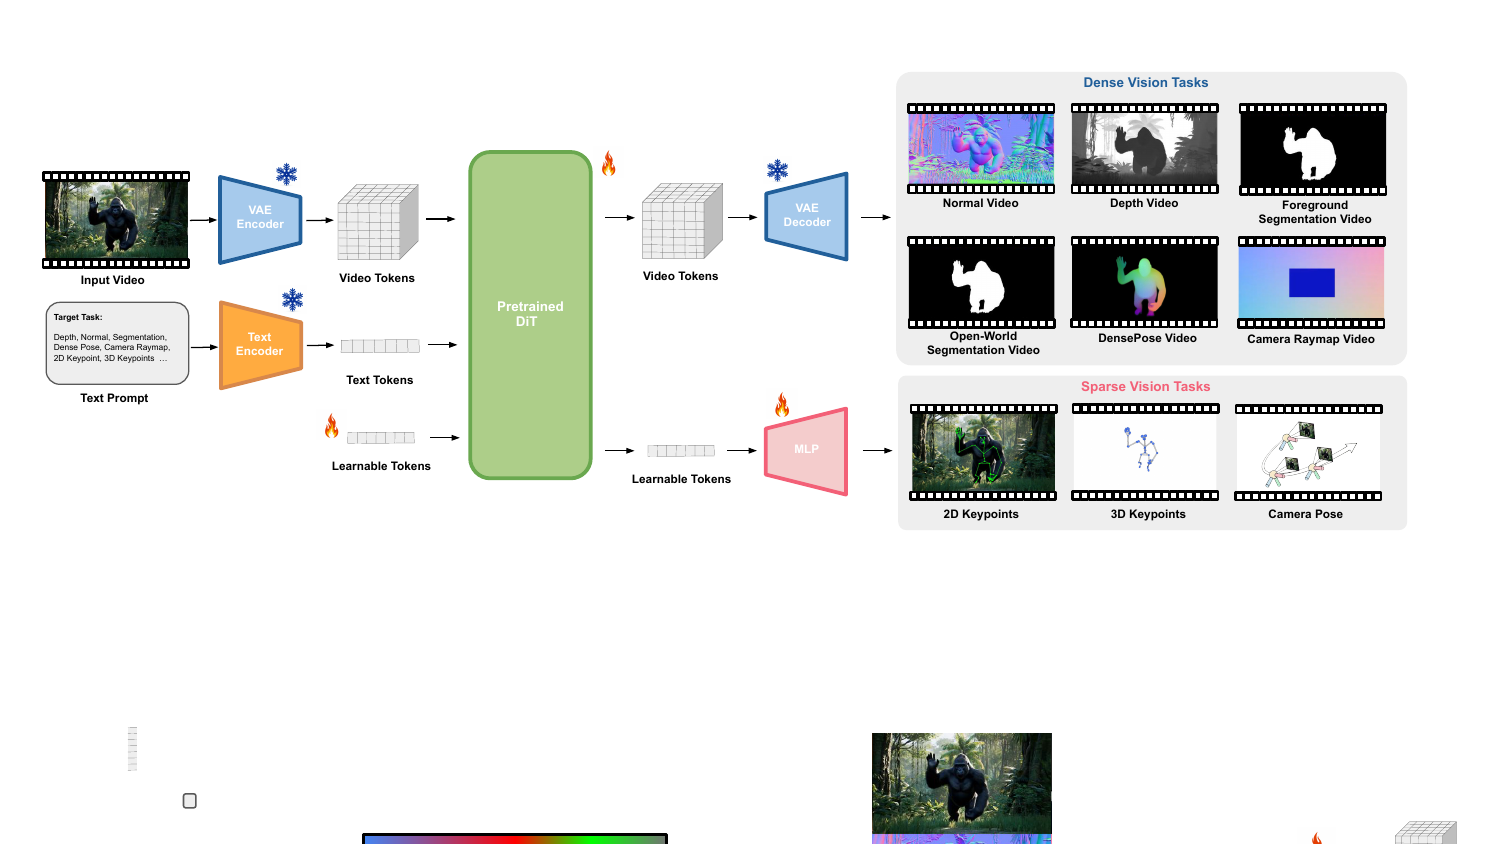
图 2:架构总览------输入视频 + 文本提示,一次前向输出目标模态;稠密任务在 RGB 潜在空间监督,稀疏任务由可学习 token 承载
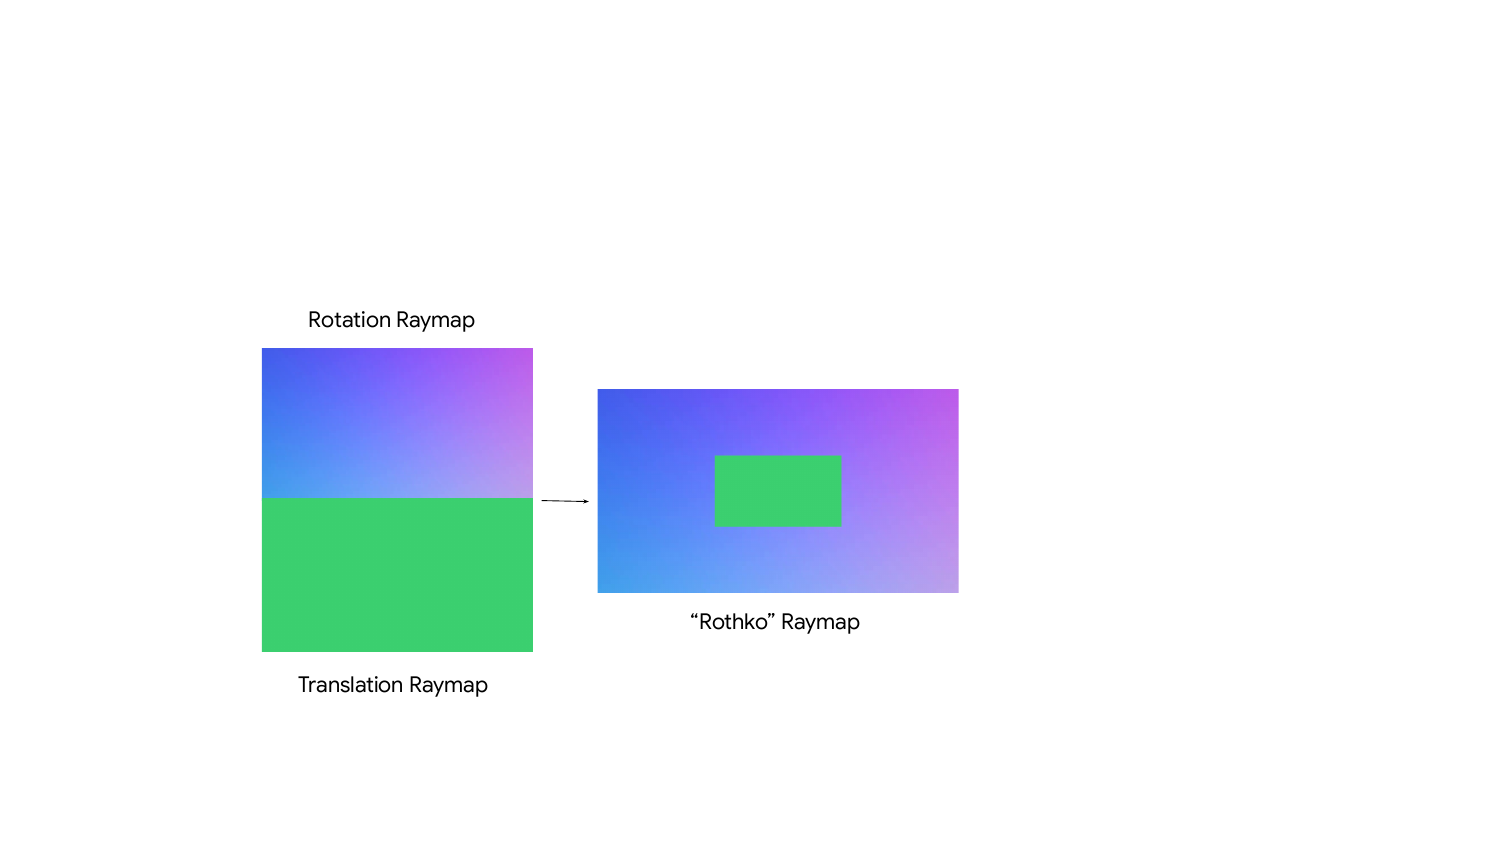
图 3:"Rothko" Raymap------把相机位姿的六通道射线数据压缩进标准 3 通道 RGB
训练配置:WAN 2.1 基座(1.3B/14B),480×832 分辨率、81 帧 @24fps;batch 64 × 256 v6e TPU,Adam lr 5e\^{-5},15,000 步,250 步 warmup;gradient clipping + gradient dropping 保证稳定。
实验设计与结果
评测协议:法向用 Hi4D(Sapiens/DAVID 协议,1,195 帧)与 SINTEL;深度用 KITTI/SINTEL/ETH3D/Goliath(DAVID 子集 2.2k 帧);相机位姿用 SINTEL(ATE/RPE-T/RPE-R);前景分割用 VideoMatte/PhotoMatte 85/PPM-100(MSE);指代分割用 RefVOS-DAVIS 与 MeViS(J&F);3D 关键点用 EMDB(MPJPE)。除指代分割外全部纯合成数据训练,未使用任何评测集训练数据。
与专用 SOTA 对比主表:
| 任务(指标↓) | 最强专用 | GenCeption L | 胜出幅度 |
|---|---|---|---|
| 法向 Hi4D (mAE) | Sapiens 12.14 | 10.99 | -1.15 |
| 法向 SINTEL (mAE) | Lotus-2 30.3 | 29.3 | -1.0 |
| 深度 SINTEL (AbsRel) | D4RT 0.148 | 0.130 | -12% |
| 深度 Goliath (AbsRel) | DepthAnything 3 0.012 | 0.008 | -33% |
| 相机位姿 SINTEL (ATE) | VGGT-Ω 0.057 | 0.050 | -12% |
| 指代分割 MeViS (J&F) | ReferEverything 60.3 | 70.0 | +16% |
| 3D 关键点 EMDB (MPJPE) | Genmo 73.0 | 71.8 | -1.2 |
| 前景分割 VideoMatte (MSE) | RVM 0.0010 | 0.0010(Generalist) | 持平 |
预训练范式与缩放(深度平均 AbsRel):
| 方法 | 规模 | 训练帧数 | Avg AbsRel↓ |
|---|---|---|---|
| V-JEPA - H | 0.6B | 0.9M | 0.281 |
| VideoMAE V2 - G | 1B | 0.9M | 0.154 |
| Ours - WAN 2.1 - S | 1.3B | 0.9M | 0.122 |
| Ours - WAN 2.1 - L | 14B | 0.9M | 0.093 |
| DepthAnything 3 - G | 1.15B | ~200M | 0.096 |
| D4RT | 1B | ~86M | 0.082 |
| VGGT-Ω | 1B | ~600M | 0.067 |
| Ours - WAN 2.1 - L (4 数据集) | 14B | 1.23M | 0.071 |
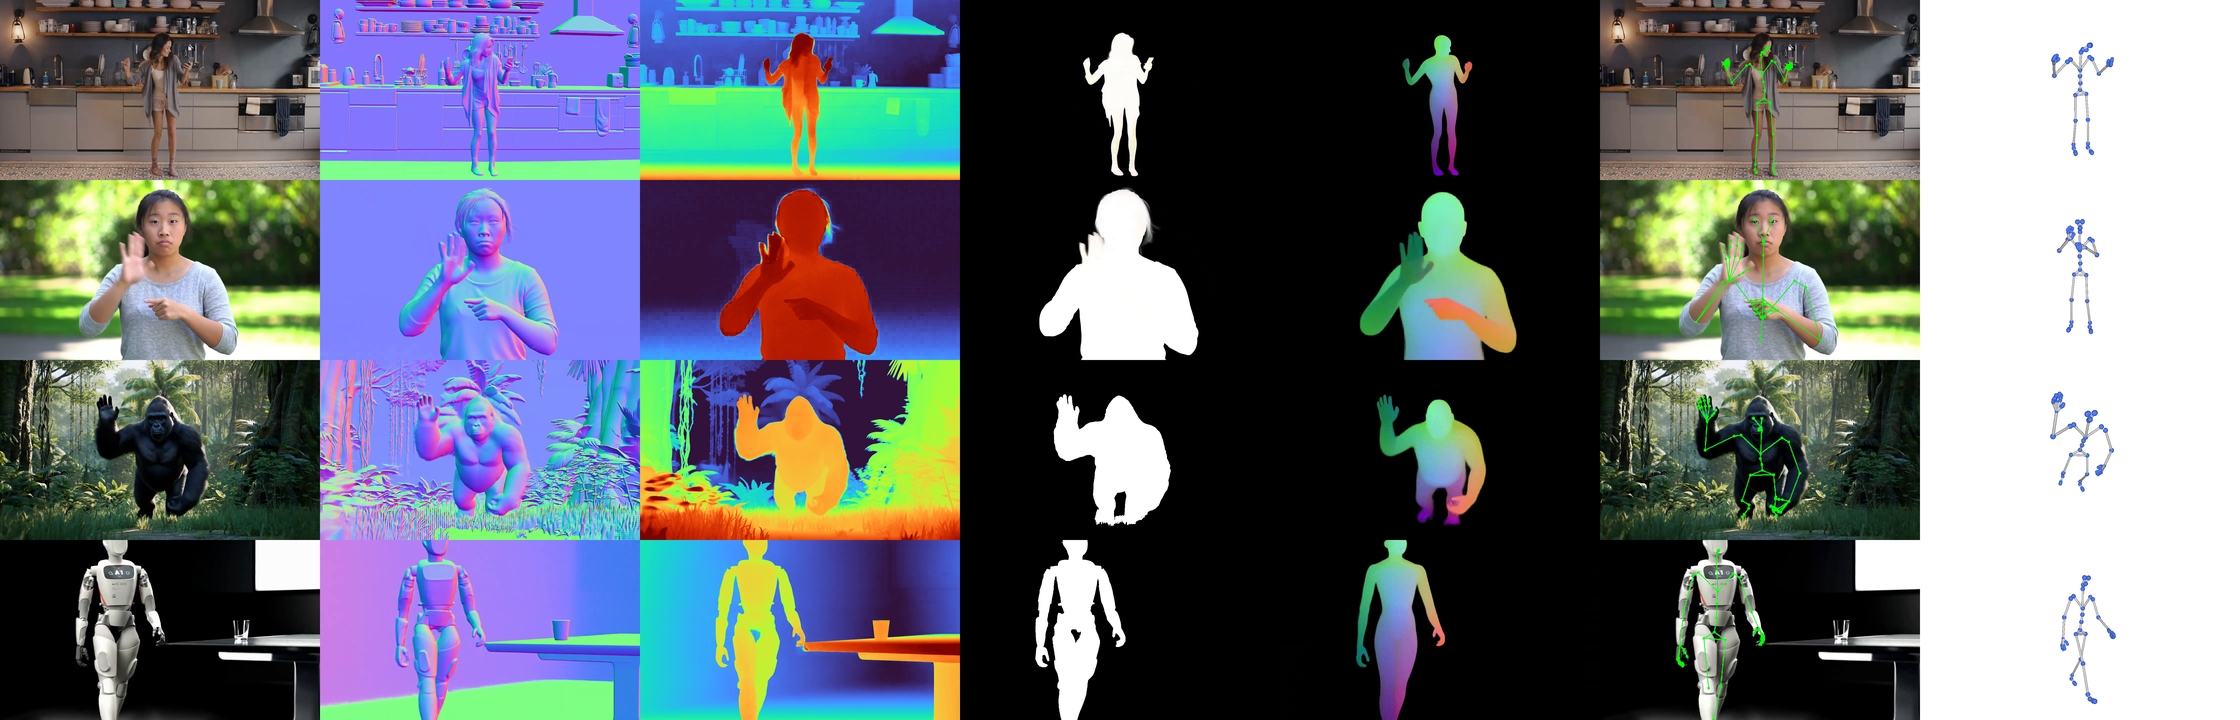
图 4:能力总览------法向、深度、前景分割、指代分割、稠密人体语义、2D/3D 关键点、相机位姿,仅训练于合成人体视频却泛化到动物与卡通角色
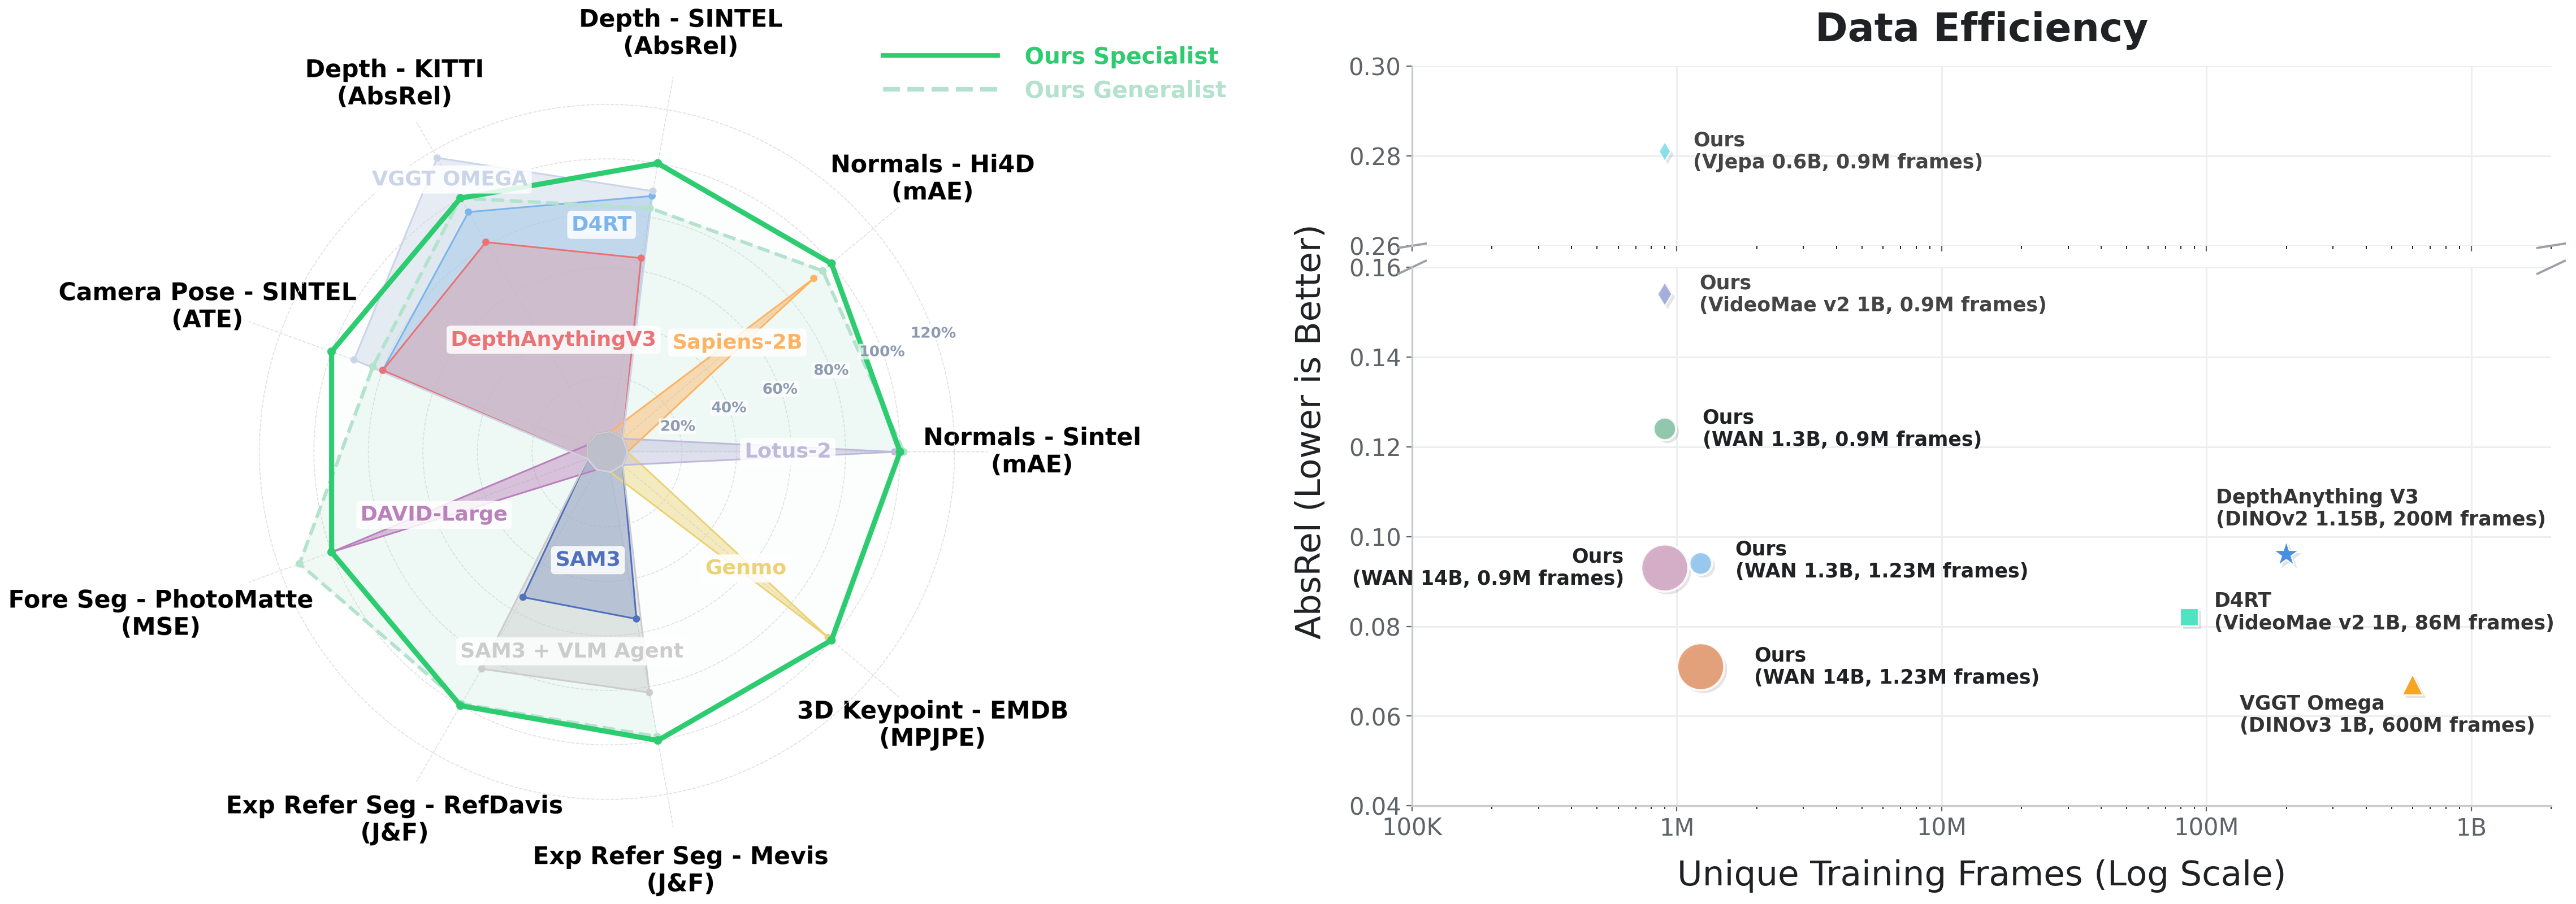
图 5:左:通用能力雷达图------匹配或超越各任务专用模型;右:深度估计数据效率------7\\times-500\\times 更少训练数据达到同等性能
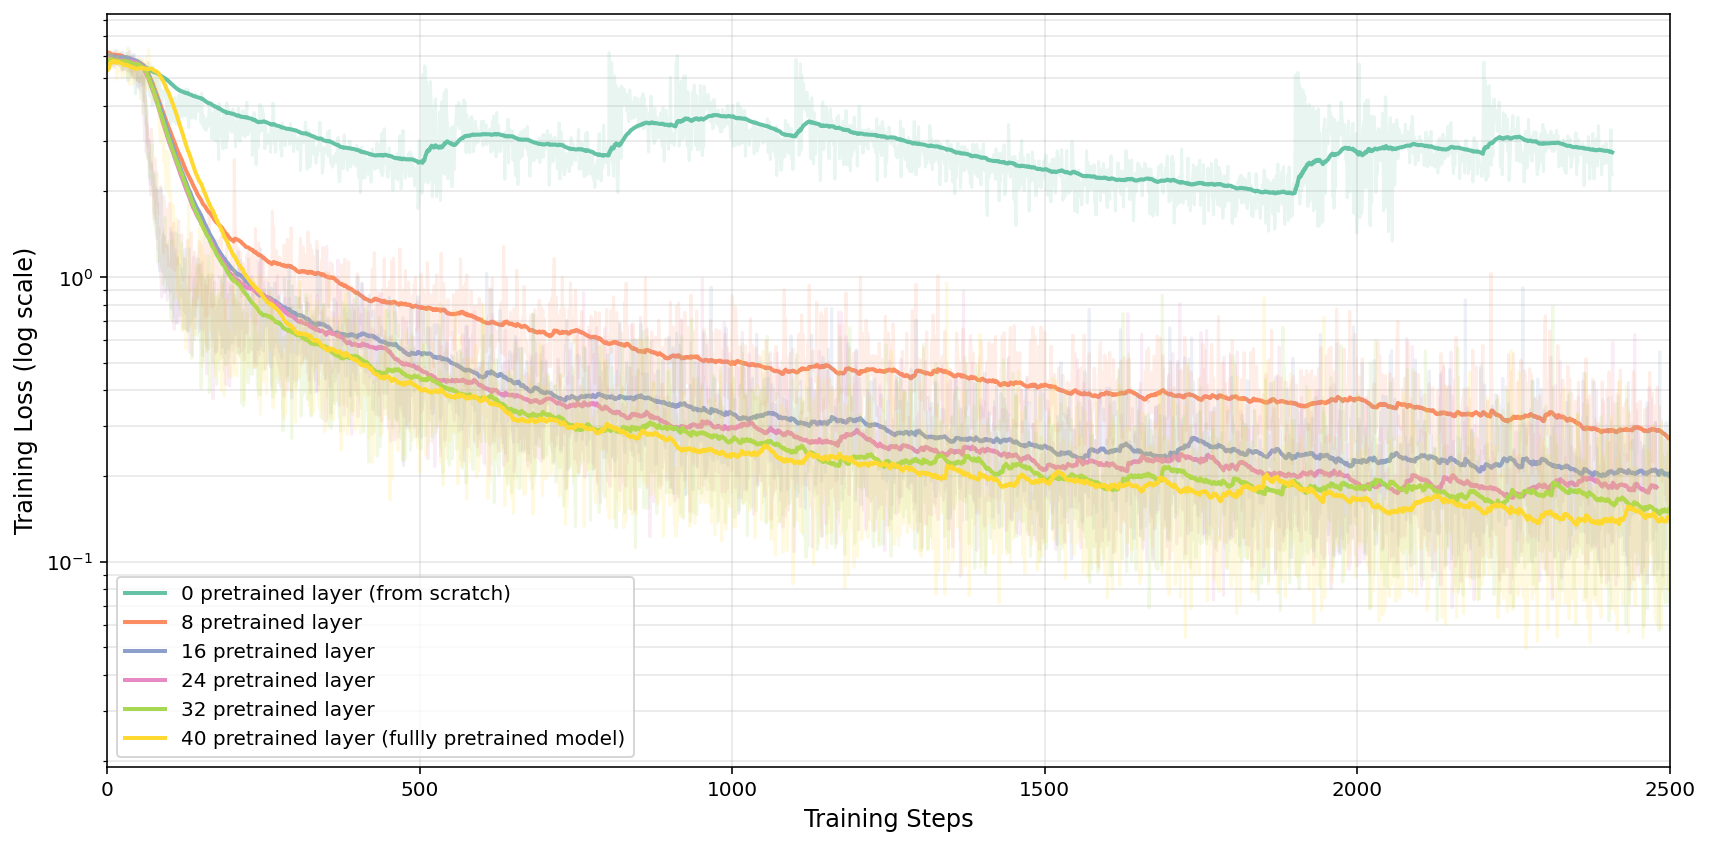
图 6:预训练迁移消融------迁移预训练层数越多性能越高,随机初始化 DiT 学习曲线近乎平坦
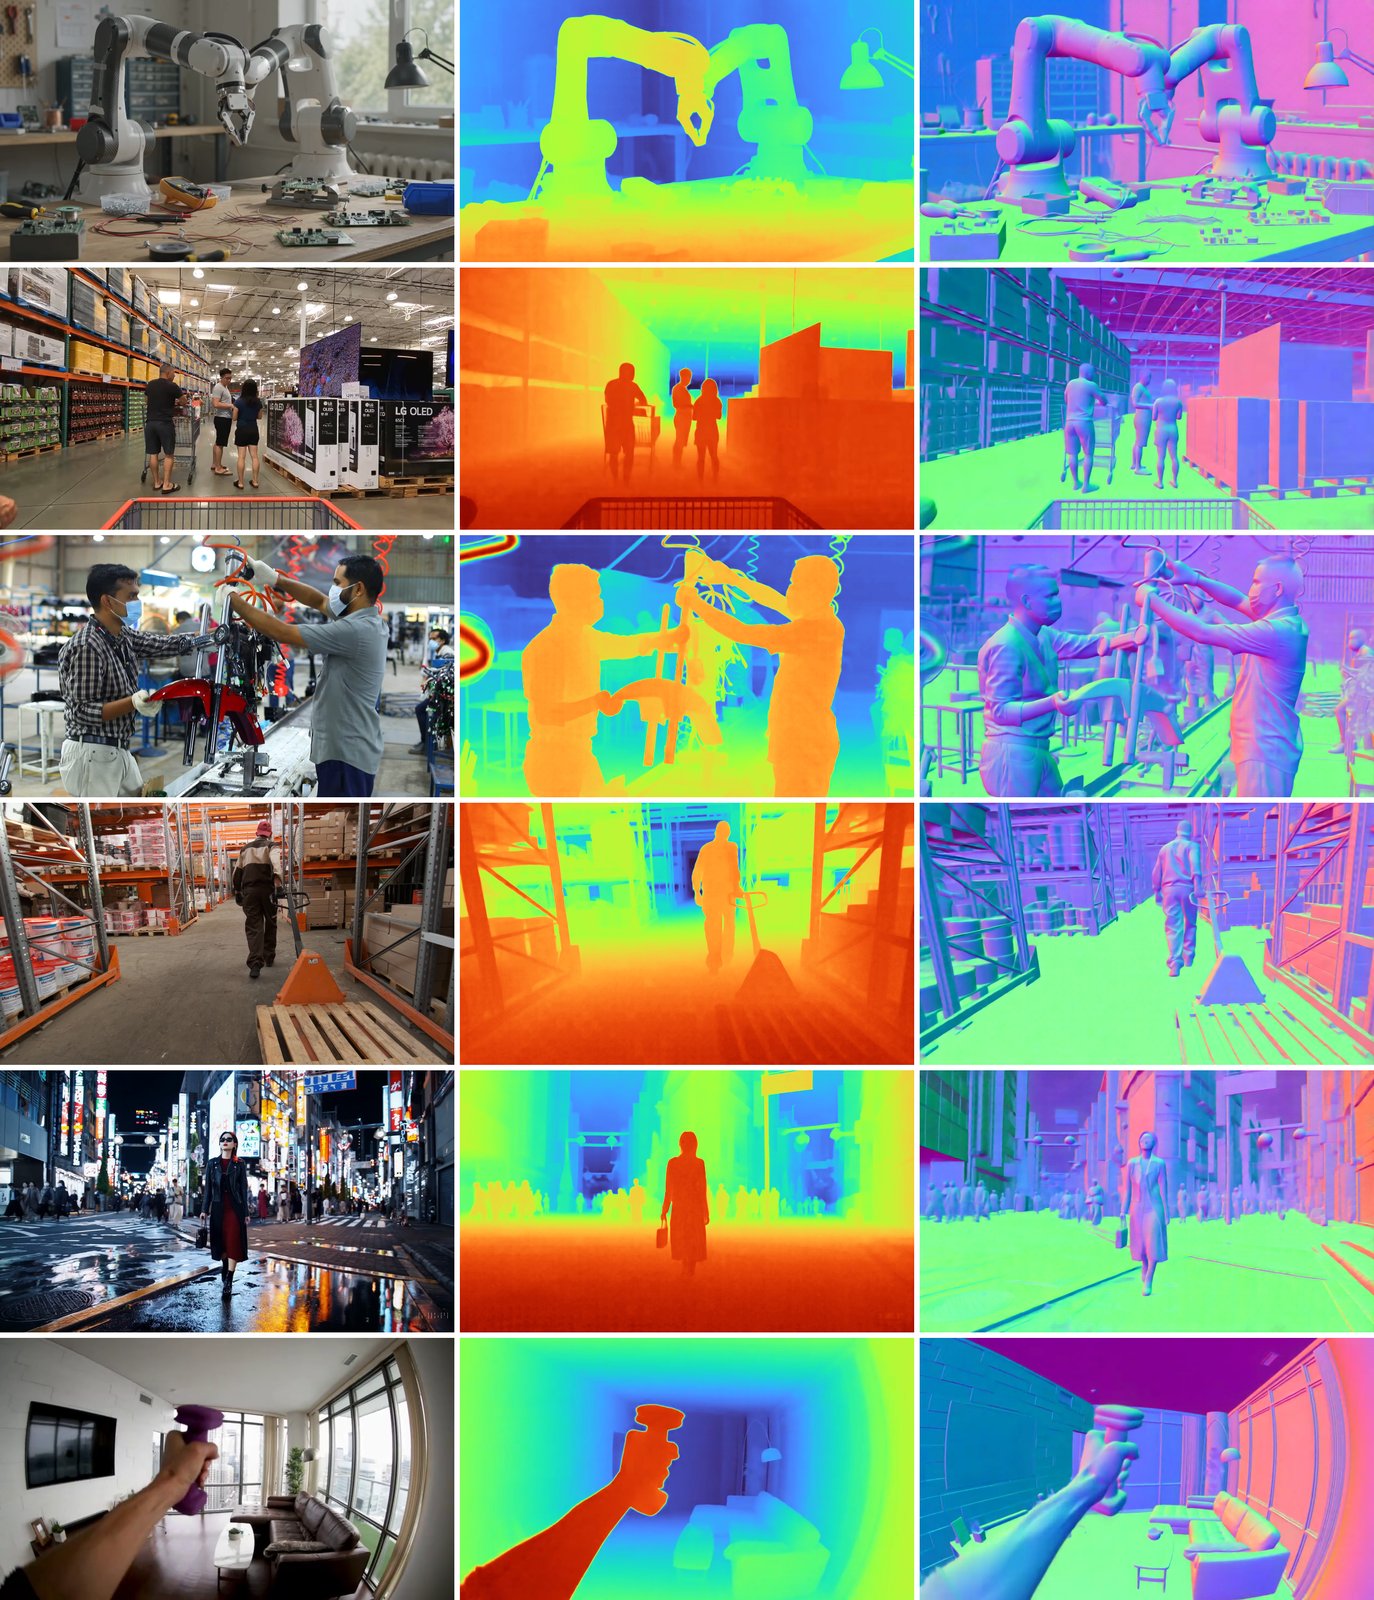
图 7:深度与表面法向估计定性结果(首帧)
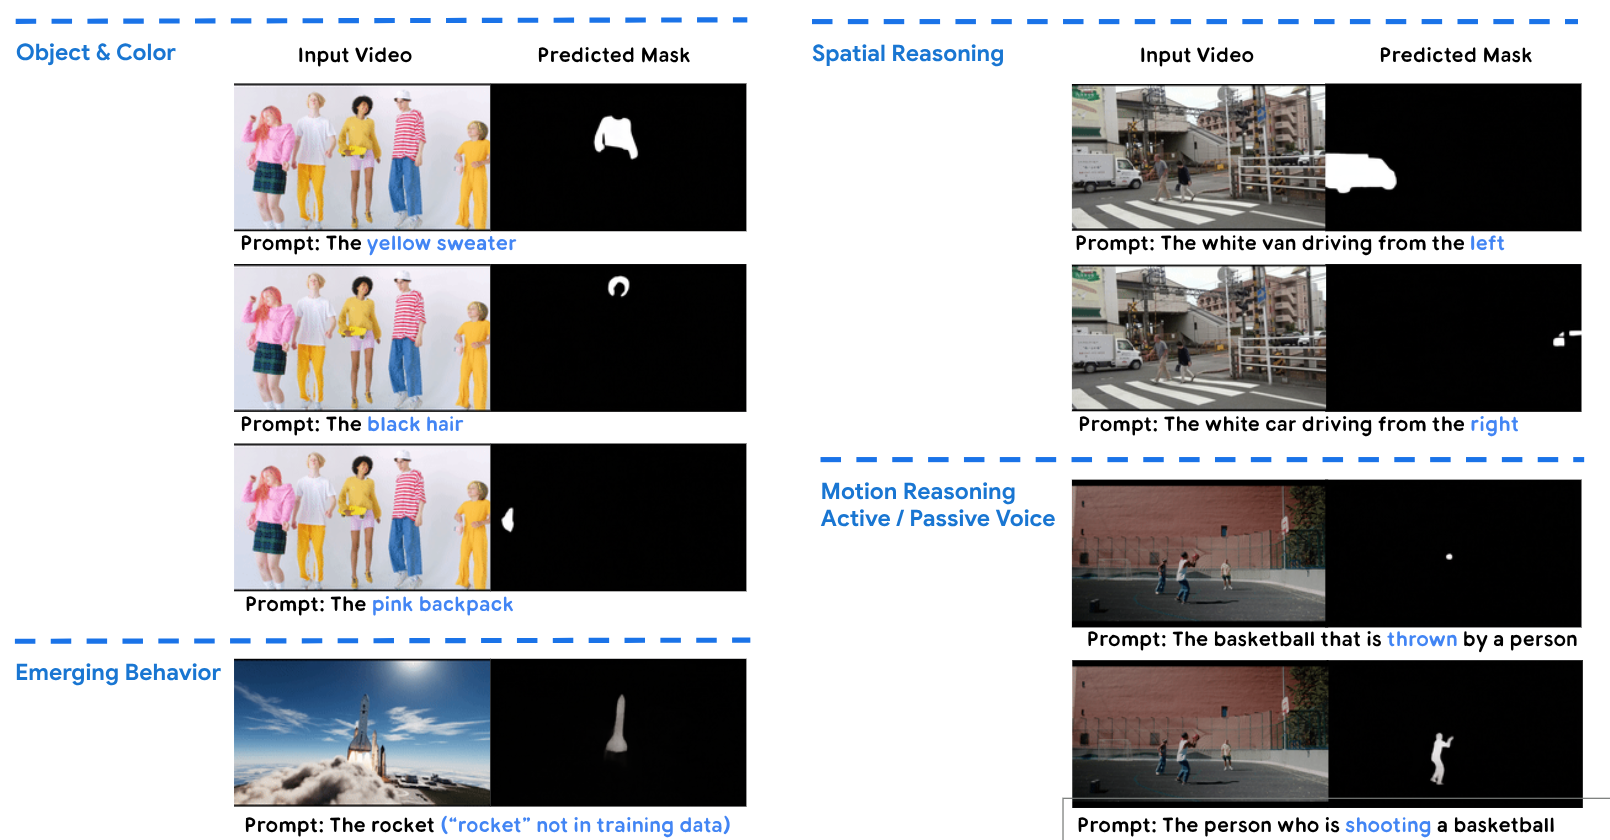
图 8:指代分割定性结果------识别物体、颜色、空间关系与运动,并分割未见类别
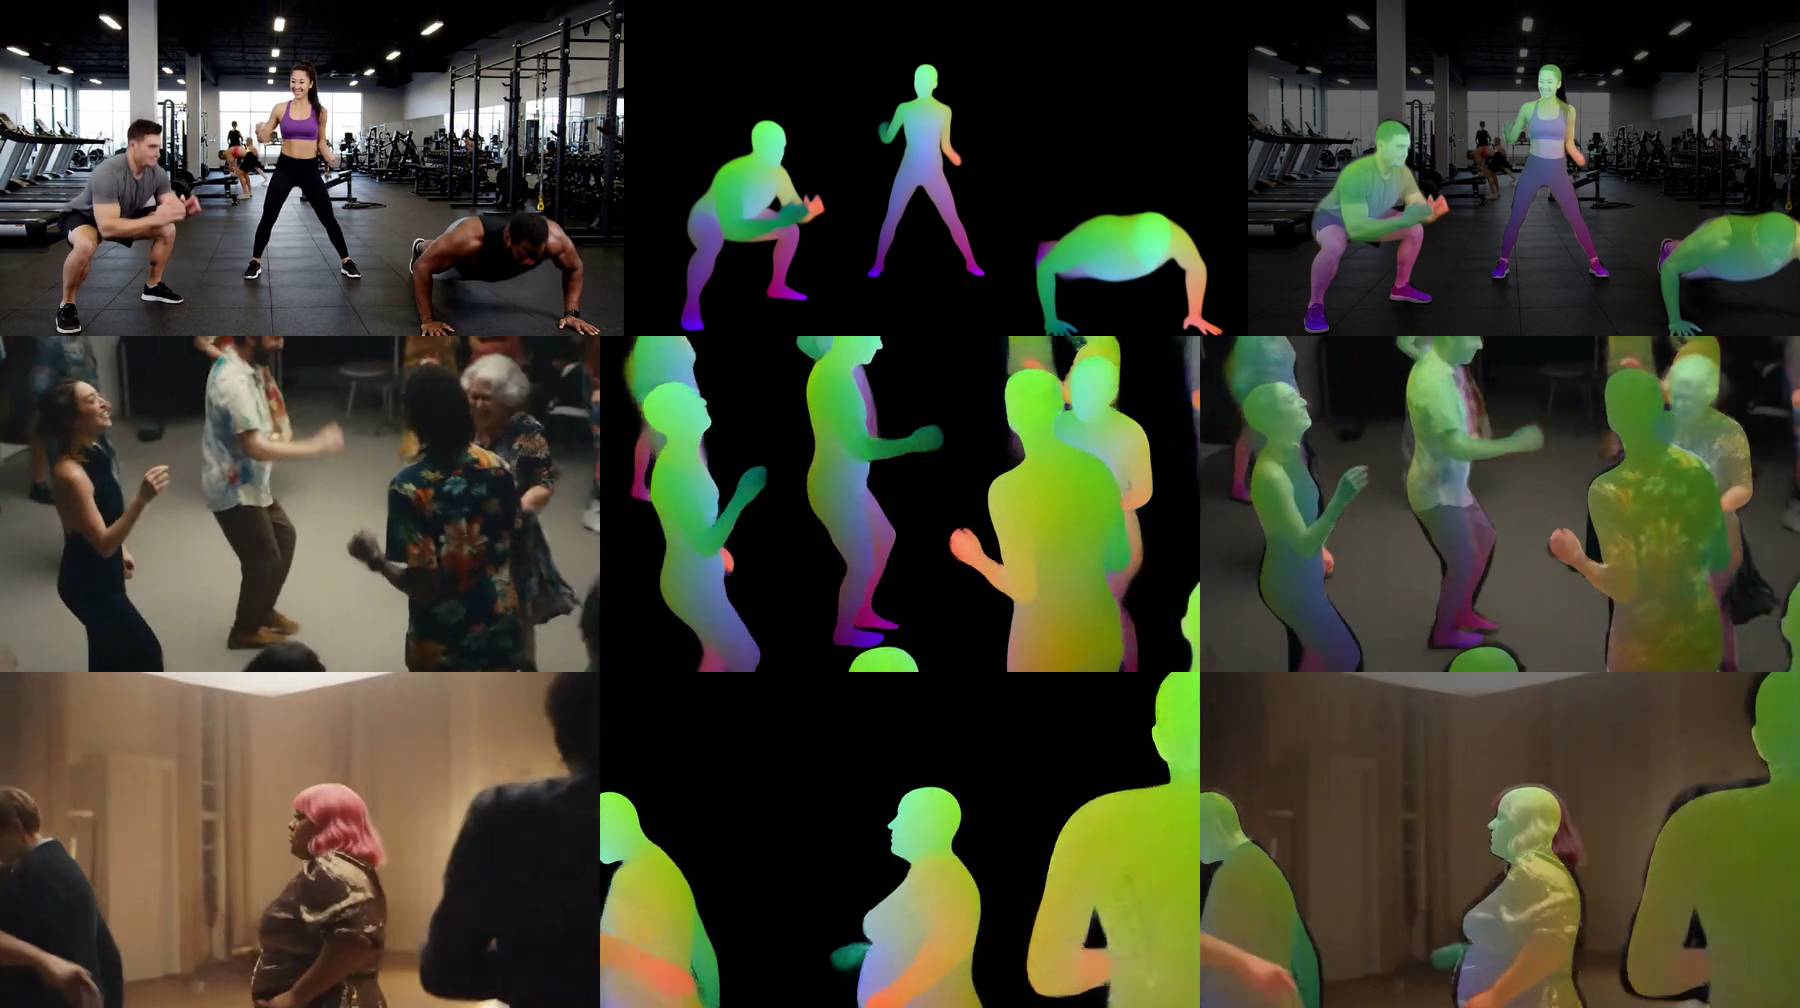
图 9:涌现泛化(a)------训练数据单物体,零样本迁移到真实多人场景
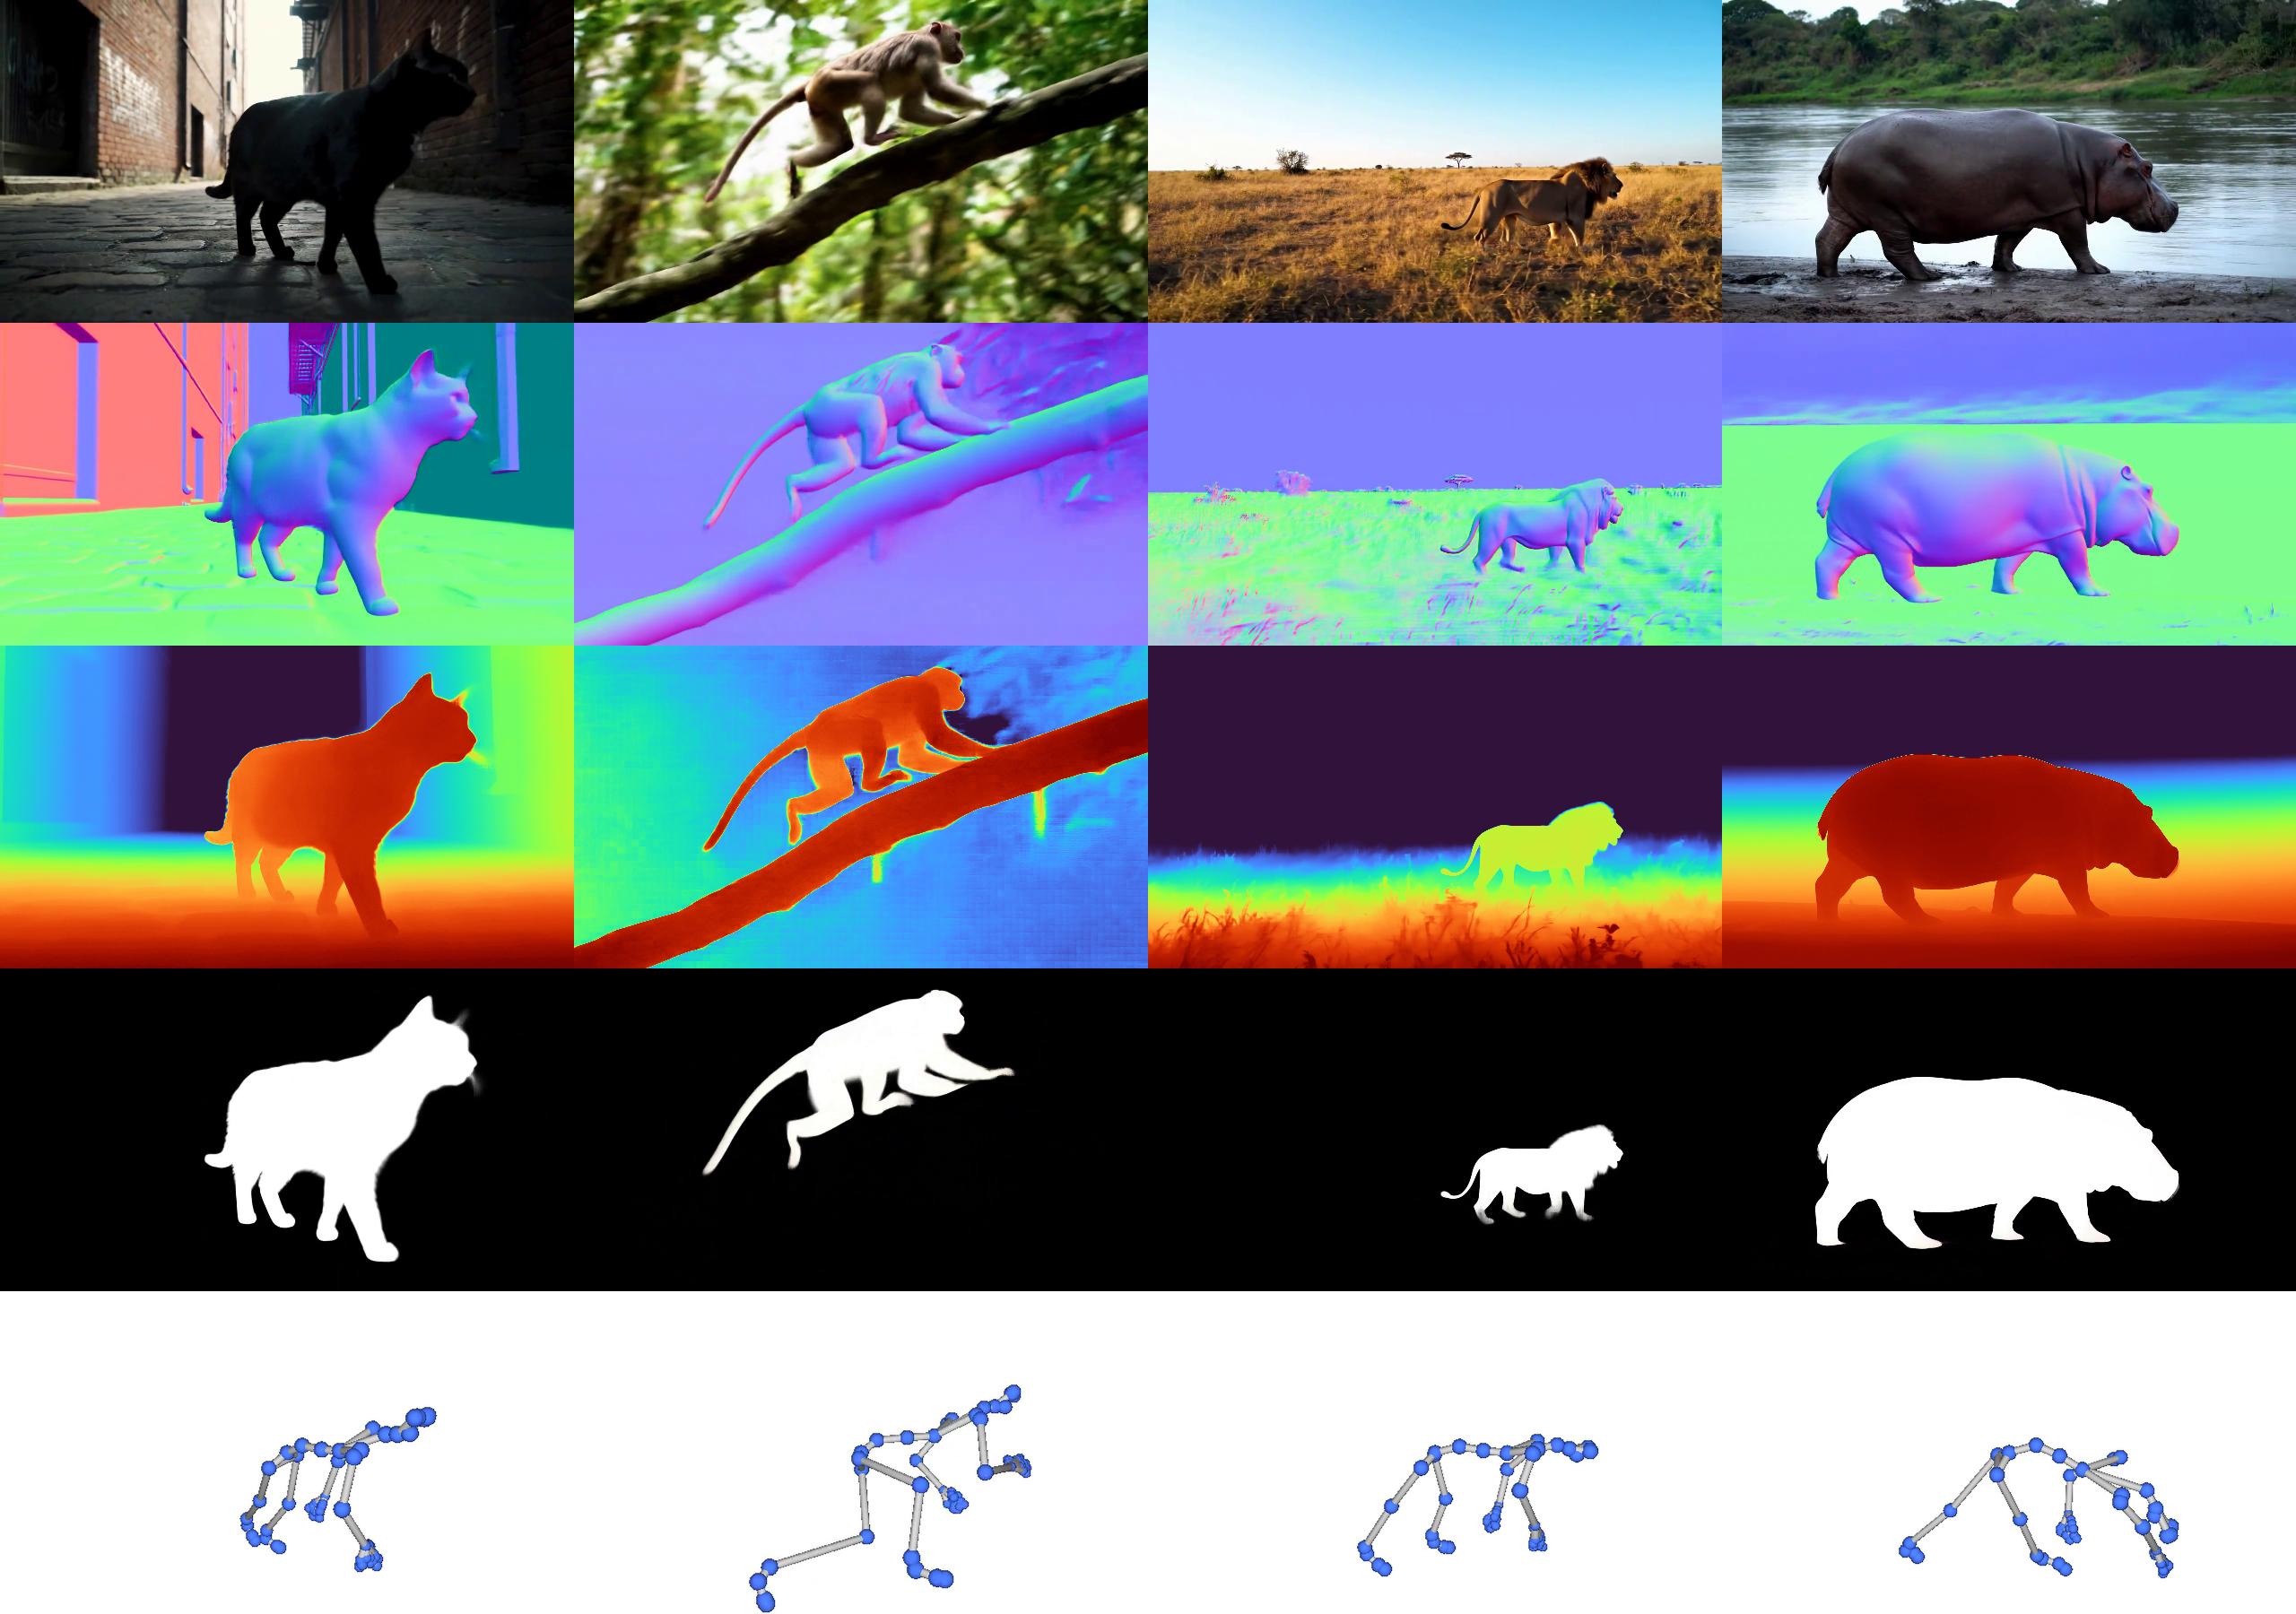
图 10:涌现泛化(b)------仅训练人体类别,泛化到猫等未见类别
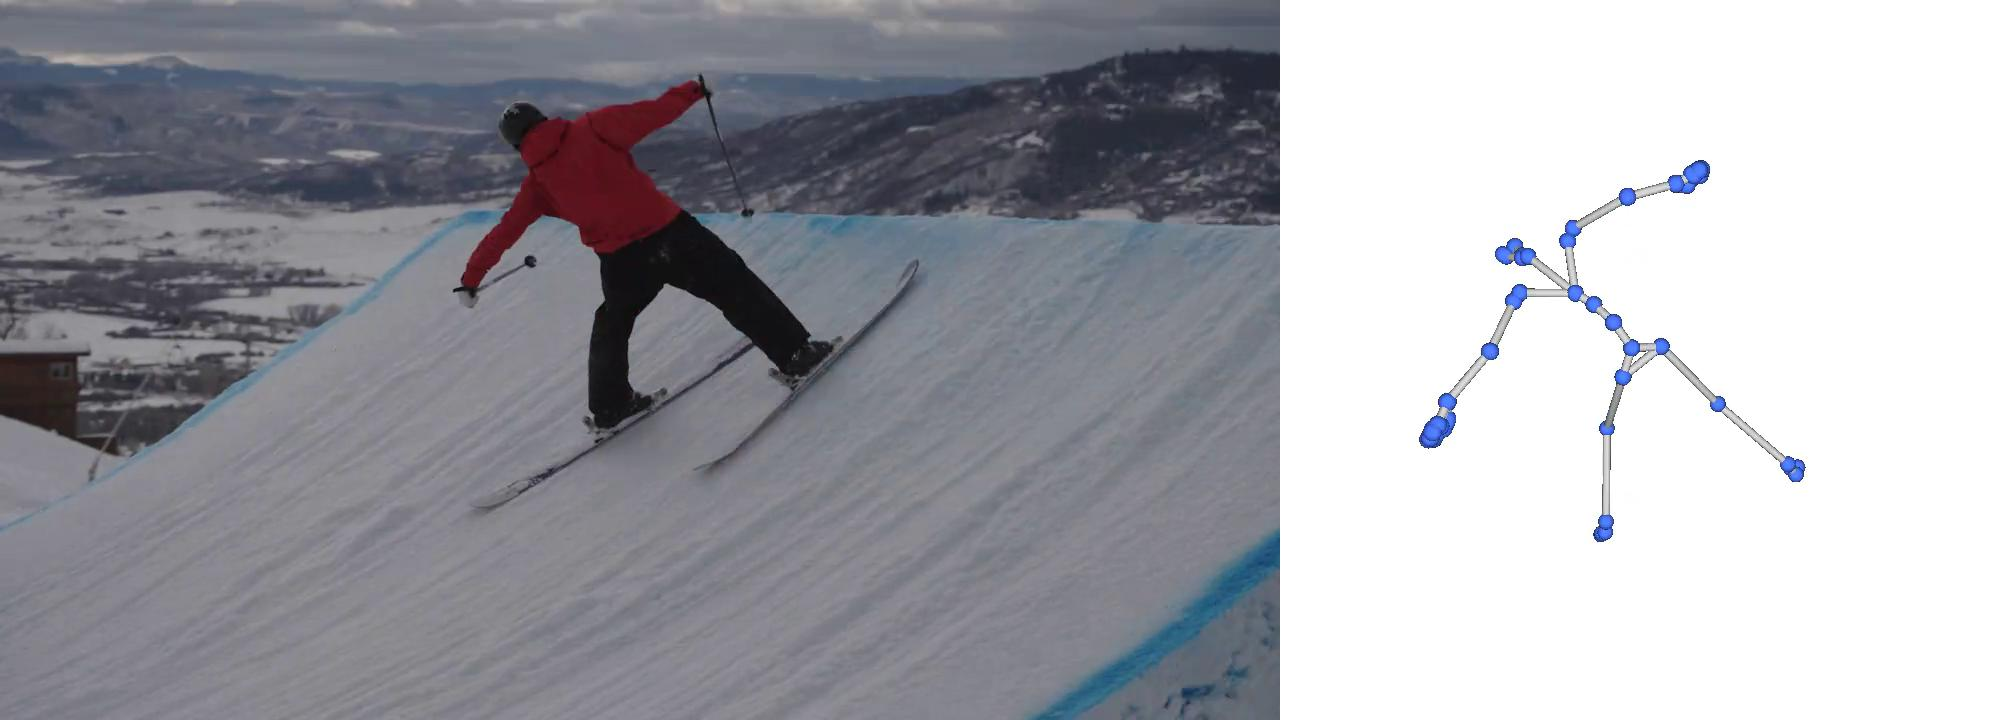
图 11:3D 姿态估计------滑雪/单板视频(每 10 帧取一帧),无需人体检测或 2D 关键点预处理
推理成本:1.3B 模型 81 帧 480×832 单次前向 5.92s @ 13.6 FPS(DiT 0.96s)、15.3GB 显存;14B 模型 10.03s @ 8.0 FPS(DiT 5.11s)、42.8GB 显存------对比 WAN 2.1 原版 50 步扩散采样,推理成本降低约一个数量级。
结果对比总结
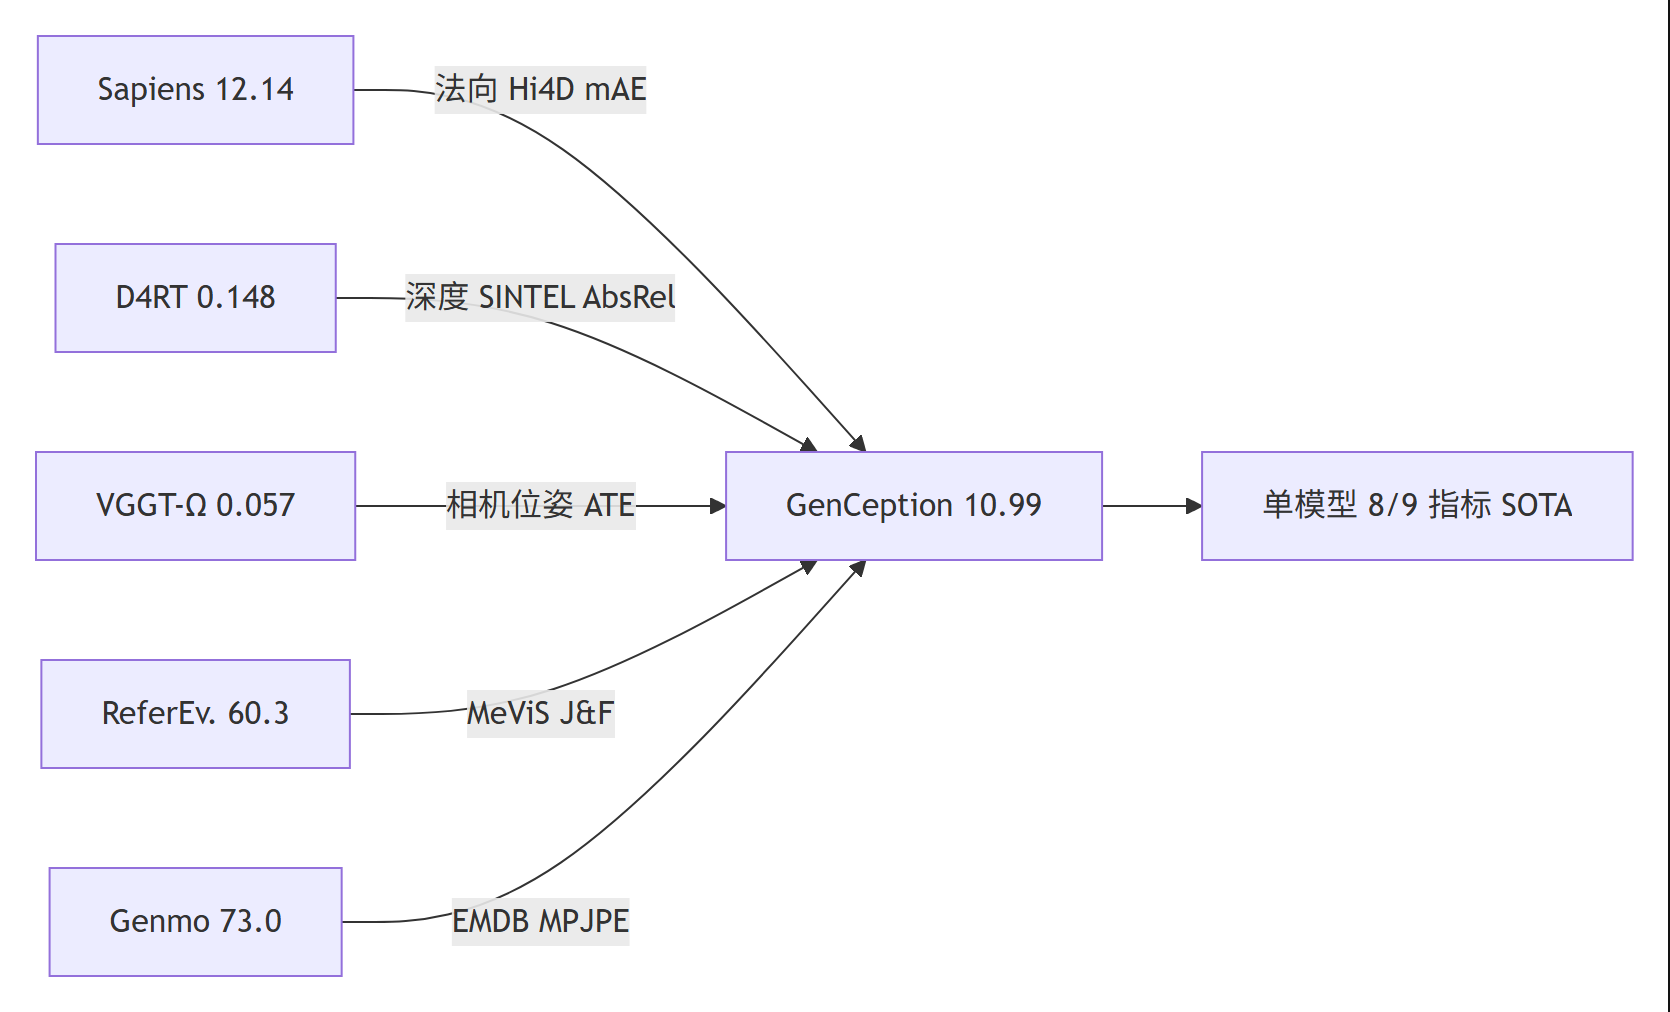
图 14:GenCeption 与各任务专用 SOTA 的对比总结(Mermaid 流程图)
关键发现
- 生成式预训练范式完胜:同数据同规模下,WAN 2.1 生成式预训练平均 AbsRel 0.093(14B),大幅优于 V-JEPA 的 0.281 与 VideoMAE V2 的 0.154------关键在生成目标本身,而非数据集或规模。
- 数据效率惊人:14B 模型用 1.23M 帧达到 VGGT-Ω(约 600M 帧)同级水平,即 7\\times-500\\times 更少训练数据;D4RT(约 86M 帧)同样被 1.23M 帧追平。
- 缩放性质初现:1.3B → 14B、数据翻倍,深度误差单调下降;从零训练 DiT 曲线近乎水平,预训练层数越多收敛越好。
- 涌现行为显著:纯合成人体视频训练,零样本迁移到真实多人场景与猫、机器人等 OOD 类别,猫胡须等细节甚至超过训练数据画质。
- 联合训练有代价:前景分割受益于多任务联合训练,但 3D 关键点 MPJPE 明显退化------token 坐标回归偏离像素空间先验,可学习 token 干扰原生注意力。
- 推理效率数量级提升:14B 单次前向 DiT 5.11s,对比 50 步扩散采样,成本降低约一个数量级。
局限性
- 稀疏任务退化:联合训练使 3D 关键点明显变差------token 回归与像素空间预训练本质相悖,可学习 token 从零训练破坏预训练注意力。
- 合成域依赖:训练数据以人体为中心,背景与物体多样性受限;指代分割仍需 MeViS/Ref-COCO/YouTube-VOS 等真实数据补充。
- 分辨率与显存开销:480×832 输入,14B 模型单次前向需 5.11s 与 42.8GB 显存,虽比 50 步扩散快得多仍非实时。
- 并发竞争:与 Vision Banana、Wiedemer et al. 等工作同期,范式归属与基准差异需后续检验。
- 作者展望:后训练应最小化对预训练骨干的架构改动,或从根本上重新设计预训练目标以原生容纳多样化下游任务。
常见问题(FAQ)
GenCeption 和 Vision Banana 有什么区别?
两者同为"生成模型是通用视觉学习者"的同期工作,但 Vision Banana 只覆盖二维图像空间且采用多步生成,GenCeption 扩展到原生视频域、采用单步前馈架构,并在更广泛的任务谱系上做了定量评测。
为什么视频生成预训练比 CLIP、MAE 更好?
因为生成高保真视频强制模型内化时空因果、3D 几何与物理交互,且文本条件生成天然对齐视觉-语言语义;CLIP 等对比方法缺时空建模,MAE 等掩码方法缺模态对齐,且视频表征模型规模普遍小一个量级。
相机位姿怎么编码进 RGB 图像?
采用像素级 raymap:每个像素记录一条射线的原点与方向(共 6 通道),通过空间分区------中心放射线原点、四周放射线方向------压缩进标准 3 通道 RGB,保持单解码器框架不变。
GenCeption 训练数据量有多大?
核心合成数据集 7,500 段视频(800 个 RenderPeople 模型 × 200 段 CMU 动作),深度补充 TartanAir、Virtual KITTI、MVS Synth,指代分割用 MeViS/Ref-COCO/YouTube-VOS;14B 模型全部训练帧约 1.23M,仅为 D4RT 的约 1/70。
为什么联合训练会损害 3D 关键点?
token 式坐标回归偏离连续像素空间预训练,且从零训练的可学习 token 会扰乱预训练 DiT 层的原生注意力机制------说明后训练应最小化对预训练骨干的架构改动。
GenCeption 开源吗?
论文基于开源的开源权重文生视频模型 WAN 2.1,但 GenCeption 本身暂未发布权重与代码;项目页面(genception.github.io)提供更多演示与细节。
参考链接
- arXiv 论文:https://arxiv.org/abs/2607.09024
- 项目页面:https://genception.github.io
- Vision Banana(同期 2D 图像版本):https://arxiv.org/abs/2604.20329
- Marigold(扩散复用开山之作):https://arxiv.org/abs/2311.17120
- B 站视频讲解:https://www.bilibili.com/video/BV1n78G65Euk
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群 :白拾的小屋 (750365700)
⭐B站账号 :白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页 :YhbCode000(工程文件)