StateGen    → 如何生成高质量多轮Agent训练数据?
DLawBench   → 如何评价真实的多轮咨询能力?
C-DIC       → 如何让模型记住超长对话?
ISE         → 如何生成真实执行环境中的多轮Agent轨迹?
LANTERN     → 上下文压缩后如何找回丢失的信息?
WRIT        → 如何生成更"难"的多轮Agent训练轨迹?
最近阅读了 6 篇与 Multi-Turn Dialogue、User Simulation、Agent Trajectory、Long-Term Memory 高度相关的论文。第一篇做合成多轮Agent训练数据,第二篇做 法律 LLM Benchmark,第三篇长程任务的长期memory研究,
一、StateGen:如何生成真正"有状态"的多轮Agent训练数据?
论文: State-Grounded Multi-Agent Synthetic Data Generation for Tool-Augmented LLMs
1. 解决的问题
现有的方法能够 "生成对话",也能够 "模拟工具",甚至能够 "模拟多智能体",但是很难同时保证:++多轮 + 工具调用 + 后端状态一致 + 多智能体协作 + 用户个性变化 + 自动评价++ 。Tool Simulator 本身也是 LLM,很容易产生错误。**如何在大规模合成多轮Agent数据时,让所有工具调用都与真实世界状态保持一致?**论文将问题归结为
**(1)tool-call hallucination。**一个 hallucination 会污染整个多轮 trajectory。
(2)multi-turn state inconsistency 。
| 方法 | 主要解决 |
|---|---|
| Toolformer | LLM 如何学习调用 Tool |
| ReAct | Reasoning + Tool Action |
| StateGen | 如何生成可靠的 Tool-Agent-User 多轮训练数据 |
2. 方法
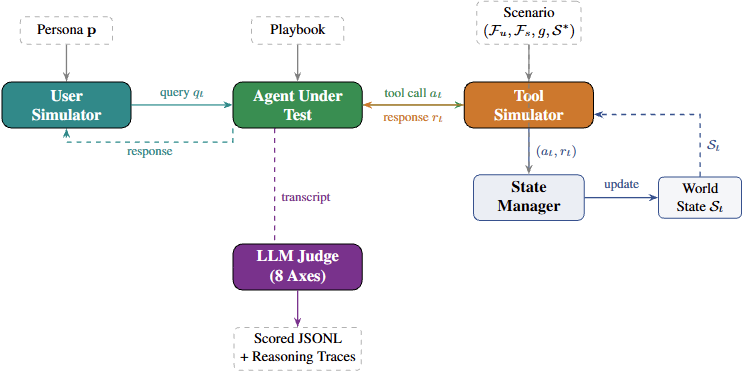 论文figure1
**(1)State Manager。**它建立一个唯一可信的后端状态。
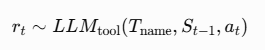
Tool Simulator 必须根据当前真实状态回答。
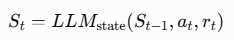
Tool Response 之后还要更新 State,这样LLM看到的是,而不是瞎猜。
(2)User Simulator。 使用一个 23维Persona Vector:
- 6 个demographic traits
- 12 个behavioral traits
- 5 个emotional states
还加入了 Query Complexity,用户请求还会分成:
- Simple
- Medium
- Complex
- Vague
更加符合真实生产环境,vague query 可以迫使 Agent 在 Tool Selection 前进行多轮 clarification。
(3)8-Axis Judge。
- Goal Achievement
- Tool Usage
- Tool-call Hallucination
- Reasoning Quality
- Reasoning Hallucination
- Communication Quality
- Consistency
- Error Handling
Tool Hallucination 和任务成功之间相关性很弱。**"任务做成功"≠"Agent 行为正确"。**说明 hallucination 本身形成一个比较独立的 failure mode。所以拆成8个维度进行打分。
| 原有方法 | 能做什么 | 核心缺点 | StateGen 怎么解决 |
|---|---|---|---|
| Self-Instruct | 大规模生成 Instruction | 单轮、Text-only | Multi-turn loop |
| Alpaca | Instruction → Response | 没有真实 Tool State | State Manager |
| WizardLM | 复杂 Instruction | 没有 Tool Grounding | Tool Simulator + State |
| Toolformer | 学会调用 Tool | 重点是 Tool Use,不是训练数据生成 | Synthetic trajectory generation |
| ReAct | Reasoning + Action | 没有解决大规模可靠数据生成 | User-Agent-Tool-Judge loop |
| τ-bench | Tool-Agent-User Benchmark | 主要用于 Evaluation,状态人工设计 | 自动生成训练轨迹 |
| AutoGen | Multi-Agent Runtime | 主要是运行时编排 | Multi-Agent Data Generation |
| LangGraph | Agent Workflow | Runtime,不是 Training Data Generator | Sub-agent-as-tool |
| Matrix | Multi-turn Multi-Agent Data | 缺少明确 Shared State | Authoritative Shared State |
| StateGen | Multi-turn + Tool + Multi-Agent + Judge | --- | 统一解决 |
StateGen解决的是"如何批量生成可信的多轮Tool-Agent训练数据",核心创新是让所有Tool Response都受到统一World State约束。
二、DLawBench:如何评价模型真正的"多轮咨询能力"?
论文: DLawBench: Evaluating LLMs Through Multi-Turn Legal Consultation
 Qwen Team, Alibaba Group
1. 解决的问题
现有法律 LLM Benchmark 大多假设"案件事实已经完整给模型",只测试模型能不能回答法律问题。但真实律师咨询中,事实是不完整的、客户可能理解错误,而且律师必须通过++多轮追问主动把关键事实问出来,再基于事实进行法律推理。++
(1)no information gather。 传统的bench的路线是++Complete Facts → Legal Reasoning,++ 现实咨询却是++Incomplete Facts → Information Gathering → Legal Reasoning++,这之间就存在了gap。
**(2)legal sycophancy。**无法评价 "问什么问题","下一句话应该问客户什么?" 是一个很重要的测评。因为客户可能会提供错误的法律观点。模型可能会出现谄媚现象。
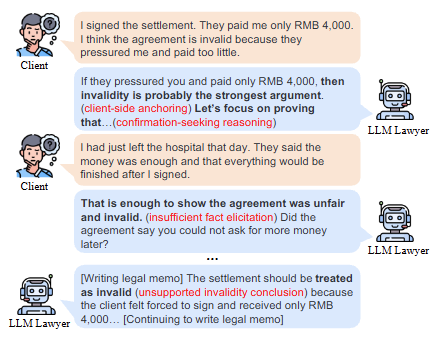 论文figure1
**(3)no User-side Variation。**现实中的客户是不同类型的,不是只有单一画像。
| 维度 | Traditional Legal Benchmarks | Interactive Benchmarks | DLawBench |
|---|---|---|---|
| 法律推理 | ✓ | ✓ | ✓ |
| 多轮交互 | ✗ | ✓ | ✓ |
| 主动询问事实 | ✗ | 部分 | ✓ |
| 客户信息不完整 | ✗ | 部分 | ✓ |
| 客户存在错误认知 | ✗ | 不强调 | ✓ |
| 客户性格变化 | ✗ | 部分 | ✓ |
| Client Belief | ✗ | ✗ | ✓ |
| Court Record | 通常直接提供 | 通常环境状态 | ✓ |
| Perspective Separation | ✗ | ✗ | ✓ |
| 事实发现评价 | ✗ | 有限 | ✓ |
| 法律问题解决评价 | ✓ | ✓ | ✓ |
| Claim Support | 有限 | 有限 | ✓ |
| Legal Sycophancy | 难发现 | 难发现 | 可以诊断 |
2. 方法
(1)把同一个案件拆成两套信息:A.Client Belief,模拟用户知道和相信的事情。**B.Court Record,**真正的、经过法律判断的事实。模型能看到Client Belief,但是不知道Court Record,就会一直追问,模型必须通过多轮提问发现关键事实。
(2)User Profile。 论文设计了四种 Client Narrative Styles:
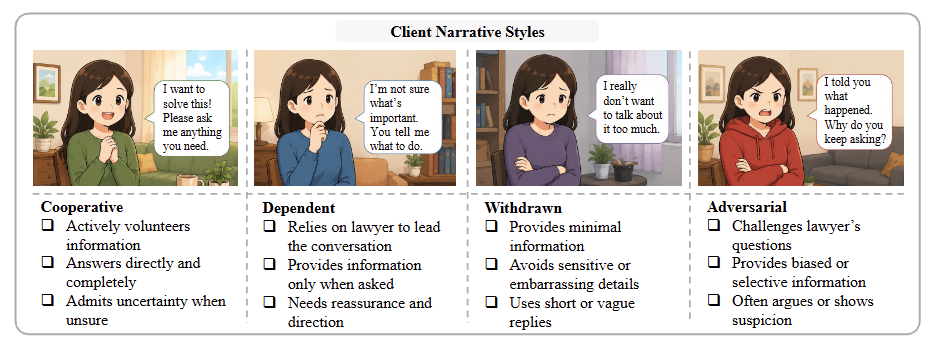 论文figure4
| 类型 | 客户行为 |
|---|---|
| Cooperative | 主动提供信息 |
| Dependent | 等律师引导 |
| Withdrawn | 不愿透露信息 |
| Adversarial | 防御、质疑律师 |
DLawBench把多轮对话评估从"回答正确"推进到了"能否主动获取解决任务所需的信息"。
三、C-DIC:对话越来越长之后,模型怎么"记住"?
论文: Context-Driven Incremental Compression for Multi-Turn Dialogue Generation
1. 解决的问题
最直接的方法:
Turn 1
+
Turn 2
+
...
+
Turn 100
每一轮都把全部历史放进 Context。
问题:
Context越来越长
 ↓
Attention成本越来越高
 ↓
大量历史信息其实没有用
于是有人采用:
截断或者:
Summarization但又产生:
重要细节丢失
旧信息无法修改
多轮压缩误差不断累积
论文认为真正的问题是:
对话不是一个不断增长的文本,而是多个不断变化的Context Threads。
2. 方法
论文提出:
C-DIC:Context-Driven Incremental Compression
核心流程:
当前User Query
      ↓
Retrieve
      ↓
找到相关Memory Thread
      ↓
Generate Response
      ↓
Compress当前Turn
      ↓
Revision / Write-back
      ↓
更新Memory
也就是:
Retrieve
   ↓
Generate
   ↓
Compress
   ↓
Write Back
最关键:Memory可以修改
如果:
Query与旧Memory高度相关就:
Revision如果:
发现新Topic就:
Insert New Memory因此不是:
Memory不断append而是:
Memory
├── Thread A
├── Thread B
└── Thread C
每个Thread都可以不断更新。
同时论文引入:
Retrieval-aware TBPTT
只沿着真正被检索、被更新的Memory路径传播训练信号,而不是对完整历史做BPTT。
3. 和其他方法不同在哪里?
传统:
Full Context问题:
计算量随对话增长。
Truncation:
只保留最近几轮问题:
旧信息直接消失。
Summarization:
全文
 ↓
Summary
问题:
不可避免的信息压缩损失。
RAG:
Query
 ↓
Retrieve历史文本
问题:
检索的是原始文本,没有学习一个适合长期对话的可更新Memory。
C-DIC:
Dialogue
 ↓
Latent Thread Memory
 ↓
Retrieve
 ↓
Revision
所以它的关键区别是:
"压缩 + 检索 + 可修改Memory"三者结合。
4. 怎么实验验证?
主要使用:
MSC
REALTALK
LongMemEval
其中 REALTALK 非常长:
21.9 sessions
894.4 utterances / conversation
主要比较:
Full Prompting
Truncation
Summarization
RAG
LLMLingua
InfLLM
AutoCompressor
ICAE
C-DIC
结果:
MSC:
PPL = 8.431
BLEU = 0.023
ROUGE-L = 0.160

REALTALK:
PPL = 9.789
BLEU = 0.035
ROUGE-L = 0.134
整体优于主要baseline。
更重要的是:
在数百轮对话中,C-DIC的推理延迟和PPL保持稳定。
一句话总结
C-DIC不是简单压缩历史,而是把长对话拆成可检索、可修改的Context Threads,让Memory随着对话不断更新。
四、ISE:为什么Agent训练数据一定要"真的执行一次"?
论文: ISE: An Execution-Grounded Recipe for Multi-Turn OS-Agent Trajectories
1. 解决什么问题?
以前生成Agent训练数据通常:
LLM生成User
 ↓
LLM生成Agent
 ↓
LLM模拟Tool
问题是:
训练数据中的Tool Execution可能根本不是真的。
例如:
Agent:
创建文件 test.py

Tool Simulator:
创建成功
但真实环境中:
权限不足
文件已存在
路径错误
命令执行失败
这些真正重要的:
Failure → Recovery
训练数据里却很少。
论文认为OS Agent数据存在三个问题:
1. Intent覆盖不足
2. User Simulator容易role drift
3. Tool Execution是模拟的而不是真实执行
2. 怎么解决?
ISE =
Intent → Simulate → Execute
Stage 1:Intent
构造:
Persona
×
Domain
×
Task
×
Complexity
生成约:
50,000 intents去重后:
43,956 unique intentsStage 2:Simulate
使用:
Role-Locked User Simulator
用户模拟器必须遵守:
Perspective Lock
Register Matching
Incremental Advancement
Responsive Conditioning
避免出现:
User:
I can help you with...
这种明显的:
User → Assistant角色漂移
同时下一轮User必须基于上一轮真实执行结果。
Stage 3:Execute
最重要的一步:
所有Tool Call直接在真实隔离OS环境中执行。
因此:
Agent
 ↓
真实Shell
 ↓
真实文件
 ↓
真实Command
 ↓
真实Error
 ↓
User Simulator
 ↓
下一轮
而不是让另一个LLM告诉你:
"这个命令应该成功。"
3. 和其他方法不同在哪里?
最核心的区别:
普通Synthetic Data:

LLM
 ↓
模拟Execution
ISE:
LLM
 ↓
Real OS
 ↓
真实Execution Result
 ↓
下一轮User
因此它生成的数据天然包含:
成功
失败
恢复
状态变化
而且 User Simulator 也不是固定脚本,而是:
根据真实执行结果动态改变下一轮用户行为。
因此真正形成:
User
 ↕
Agent
 ↕
Real Environment
三方闭环。
4. 怎么实验验证?
最终得到:
43,956 unique intents
23,132 complete trajectories
965 personas
10 domains
平均:
8.12 user turns
68.24 total dialogue turns
29.26 tool calls
然后用 ISETrace 做 SFT。
Qwen3-8B:
ClawEval Pass@1

Base:
19.3

ISETrace SFT:
37.7
接近翻倍。
更重要的是:
Qwen3-8B + ISETrace甚至超过:
Qwen3-32B Base
GPT-4o Zero-shot
在 BFCL 的 Stateful Web Search / Memory 类任务上提升尤其明显。
一句话总结
ISE最大的贡献不是"生成更多数据",而是让每一轮用户行为都建立在真实OS执行结果上,从而生成真正具有Failure-Recovery的多轮Agent轨迹。
五、LANTERN:上下文压缩后,丢掉的信息怎么找回来?
论文: LANTERN: Layered Archival and Temporal Episodic Retrieval Network for Long-Context LLM Conversations
1. 解决什么问题?
长对话系统经常需要:
Conversation
 ↓
Context Compaction
例如:
"服务器运行在8080端口"压缩后变成:
"服务器配置完成"那么:
8080这个具体事实就消失了。
论文把这个问题称为:
Context Cliff
即:
Compaction之前:
大量事实

Compaction之后:
摘要保留语义
但具体事实丢失
2. 怎么解决?
LANTERN的思路非常直接:
压缩Context,但不要删除原始历史。
每一轮对话都主动Archive:
Turn 1
Turn 2
Turn 3
...
Turn N
然后建立:
Lexical Retrieval
+
Semantic Retrieval
+
Temporal Retrieval
最后使用:
Reciprocal Rank Fusion(RRF)
将多个检索结果融合。
所以:
Compaction
   ↓
Context变短

用户突然问:
"之前那个错误码是多少?"
   ↓
Hybrid Retrieval
   ↓
找到原始Turn
   ↓
恢复到当前Context
3. 和其他方法不同在哪里?
传统:
Summarization
历史
 ↓
摘要
 ↓
旧细节永久消失
Neural RAG
Embedding
 ↓
Semantic Retrieval
但可能找不到:
具体数字
错误码
文件名
函数名
端口号
MemGPT
通过LLM决定:
什么应该存?
什么时候存?
但是:
LLM calls
+
成本
+
延迟
都比较高。
LANTERN则采用:
Extractive Archival + Hybrid Retrieval
基础版本甚至:
不需要LLM调用。
4. 怎么实验验证?
论文使用:
94 real conversations
1,894 ground-truth facts
并与:
Summarization
Neural RAG
MemGPT-Faithful
比较。
核心结果:
LANTERN-Rerank:
78.3% fact recovery

MemGPT-Faithful:
72.4%
而且:
Base LANTERN:
76.3%
已经超过 MemGPT baseline。
进一步让 4 个生产级LLM回答事实问题:
加入 LANTERN 恢复的Context后,平均准确率提升 8.4个百分点。
一句话总结
LANTERN的核心不是"更聪明地压缩",而是"压缩以后仍然保留原始事实,并在需要时重新检索回来"。
六、WRIT:为什么Agent训练数据不能只让任务"变长"?
论文: WRIT: Write-Read Intensive Trajectory Synthesis for Multi-Turn User-Facing Agents
1. 解决什么问题?
现有Agent训练数据通常通过:
增加Task数量
+
增加Tool Call
+
增加Write Action
把任务变得更复杂。
例如:
搜索航班
 ↓
预订航班
 ↓
修改订单
 ↓
取消订单
这种方法训练的是:
Long-Horizon Sequential Execution
但现实任务还有另外一种难度:
真正执行一个Write之前,需要读很多信息。
例如用户说:
"帮我订所有日期和机场组合中最快的航班。"
Agent不能直接:
book(...)必须:
Search Airport A
Search Date 1
Search Date 2
Search Airport B
Search Date 1
Search Date 2
...
 ↓
比较所有结果
 ↓
找到最快航班
 ↓
获得flight_number
 ↓
Book
因此:
一次Write Decision本身也可能非常困难。
2. 怎么解决?
WRIT提出两个独立的复杂度轴:
Axis 1:Write Complexity
Write 1
 ↓
Write 2
 ↓
Write 3
 ↓
...
控制:
一个任务需要多少次状态改变。
Axis 2:Read Complexity
Read
Read
Read
Read
 ↓
Compare
 ↓
Ground Arguments
 ↓
Write
控制:
做一次Write之前,需要读取多少证据。
所以:
                 Task Complexity
                       │
             ┌─────────┴─────────┐
             ↓                   ↓
        Write-heavy          Read-heavy
             │                   │
       多次Action            大量Evidence
             │                   │
       Long Horizon        Grounding Difficulty
然后再加入:
Progressive Disclosure
Self Correction
Confirmation Hesitation
Emotion
Irrelevant Aside
False Premise
Social Pressure
等用户行为变化。
最后在可执行环境中模拟:
User Simulator
      ↕
Agent
      ↕
Environment
只保留成功完成的轨迹。
3. 和其他方法不同在哪里?
传统轨迹生成:
让Agent"做更多"。
WRIT:
不仅让Agent做更多,还要求Agent在做之前"知道更多"。
因此:
传统:
Longer Task
 ↓
More Writes
 ↓
Longer Trajectory
WRIT:
Longer Task
+
More Writes
+
More Reads
+
Evidence Comparison
+
User Behavior Variation
特别是:
Read-heavy trajectory
这是WRIT最核心的创新。
因为很多Agent数据让模型:
Search once
 ↓
Immediately Write
容易形成:
premature action
而WRIT训练模型:
Search
 ↓
Search
 ↓
Compare
 ↓
Verify
 ↓
Act
4. 怎么实验验证?
论文只使用:
2K synthesized trajectories
训练模型,然后在:
τ²-Bench Retail
τ²-Bench Airline
上测试。
以 Qwen3-4B 为例:
APIGen-MT:
Average Pass@1 = 40.85

Simia:
46.80

CoVe:
52.90

AReaL:
55.64

WRIT:
67.99
Hard subset:
Retail-Hard:
66.13

Airline-Hard:
57.50
而且论文发现:
仅仅2K条经过结构化设计的WRIT轨迹,就可以让4B模型超过GPT-5.1 no-think。
消融实验进一步证明:
Read-heavy synthesis
+
User behavior diversification
两部分都独立贡献性能。
一句话总结
WRIT解决的是"Agent训练数据虽然越来越长,但没有真正增加决策难度"的问题,通过Write-heavy + Read-heavy两个维度构造更有价值的多轮轨迹。
七、总结
| 论文 | 解决的问题 | 核心方法 | 与其他方法最大的区别 | 实验 |
|---|---|---|---|---|
| StateGen | 合成数据中的Tool状态会乱 | State Manager + Multi-role | Backend is Truth | 64K conversations |
| DLawBench | 传统Benchmark不会测"主动询问" | Client Simulator + Expert Rubrics | 评价信息获取策略 | 461 cases / 26 LLM |
| C-DIC | 超长对话Context越来越大 | Retrieve + Compress + Revise | Memory可修改 | MSC / REALTALK |
| ISE | Agent轨迹缺少真实执行 | Intent → Simulate → Execute | 真OS执行 | 23K trajectories |
| LANTERN | Context压缩导致事实丢失 | Archive + Hybrid Retrieval | 不依赖LLM做基础Memory | 1,894 facts |
| WRIT | 训练轨迹只是"变长"而不是"变难" | Write + Read Complexity | 显式建模Evidence Burden | τ²-Bench |
八、这6篇论文其实可以串成一个完整的"多轮Agent数据闭环"
把它们放到一起看,会发现非常明显:
                  User Simulator
                       │
                       ↓
                 Multi-Turn Task
                       │
          ┌────────────┼────────────┐
          ↓            ↓            ↓
      StateGen        ISE          WRIT
          │            │            │
     状态一致性      真实执行       任务难度
          │            │            │
          └────────────┼────────────┘
                       ↓
                  Trajectory
                       │
                       ↓
                Multi-Turn Agent
                       │
          ┌────────────┼────────────┐
          ↓            ↓            ↓
       Memory      Information     Action
          │         Gathering      Policy
          ↓            ↓            ↓
      C-DIC /       DLawBench      WRIT
      LANTERN
                       │
                       ↓
                  Evaluation
                       │
                       ↓
                  Better Agent
因此,这一批论文和上一批论文相比,一个非常明显的变化是:
研究重点已经从"如何评价一个多轮模型",进一步转向"如何构造一个完整的多轮Agent训练与评估环境"。