文章链接:Visually-Guided Policy Optimization for Multimodal Reasoning - ACL Anthology
文章名称:Visually-Guided Policy Optimization for Multimodal Reasoning
文章来源:ACL26-Long (CCF-A)
问题来源:大模型在生成内容时会发生信息遗忘现象,其后续生成内容会逐渐更多依赖已经生成的文本,而弱化对原始输入资源的利用。这种现象在多模态视觉推理中尤其明显,表现为模型在推理早期能够关注图像,但随着推理链延长,视觉注意逐渐衰减,形成 Temporal Visual Forgetting(时序视觉遗忘) 。因此,文章提出一种视觉引导的强化学习训练方法 VGPO,在策略优化过程中识别与视觉信息关联程度较高的生成 token,并对推理后期的视觉关注进行补偿,使模型在长链推理过程中持续利用原始视觉证据,而不是过度依赖自身已经生成的文本信息。
1.问题描述
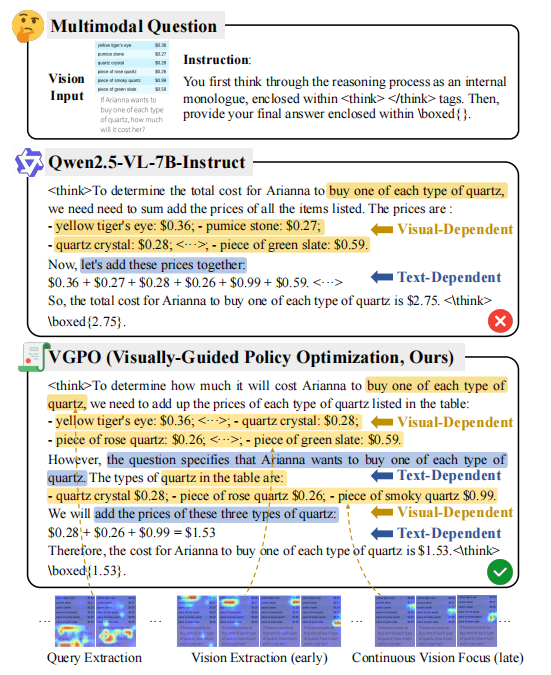
文章中图1具体描述了问题细节:
向文章提出的模型和基线模型(Qwen2.5-VL-7B-Instruct)中输入一个表格,里面是每个物品及其价格,要求模型进行总价计算。观察在处理相同问题时两个模型的思考过程:
1.基线模型前期很好的提取出了图片中的价格内容,但是从计算总价开始,并没有继续获取图片的相关信息。
2.文章提出模型前期和基线大体一致,但是后期再计算时在思考中再次提及了视觉内容。
这说明, 基线模型虽然能够在推理早期正确读取视觉信息,但随着推理过程推进,会逐渐转而**依赖自身已经生成的文本信息,而减少对原始视觉证据的再次调用。**VGPO则使模型在后续推理过程中仍能重新关注并利用视觉信息,从而缓解视觉遗忘。
2.问题切入
2.1.Group Relative Policy Optimization
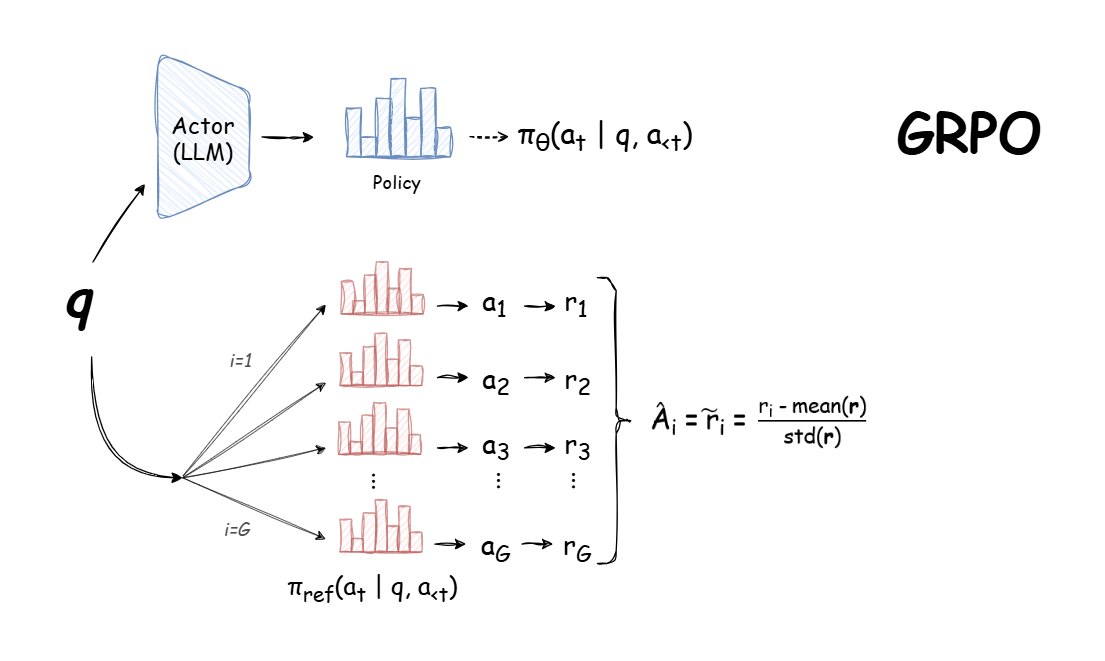
Group Relative Policy Optimization (GRPO),是一种专门为大语言模型(LLM)的强化学习训练 设计的策略优化算法。其核心思想是:针对同一个问题生成一组不同回答,通过组内比较判断哪些回答更好,再利用这种相对优劣更新模型。
其主要原理流程为:
1.生成多个候选回答。
如图所示,对于同一个问题 q,当前策略模型会采样生成 G个不同的回答:
2.对每个回答进行评分。
根据答案正确性或其他评价标准,为每个回答得到奖励:
3.进行组内相对比较。
GRPO不只看奖励的绝对大小,而是比较一个回答在当前组中的表现。可以简单理解为:
4.根据优势更新模型。
对于正向优势的回答,提高模型产生相应生成行为的概率,对于负向优势的回答,则降低其概率:
经过大量问题和候选回答的反复训练,经常出现在高奖励推理轨迹中的有效生成模式会逐渐得到强化,而经常导致错误结果的生成模式则逐渐受到抑制。因此,可以将 GRPO 简单理解为:
同一道题多生成几个答案 → 比较谁答得更好 → 奖励好的生成行为、抑制差的生成行为 → 逐渐优化模型的推理策略。
这也正好为后面的 VGPO 埋下问题:GRPO知道"哪条回答更好",但并不知道一条回答内部哪些 token 真正利用了视觉信息。
2.2.Key Findings in Multimodal Reasoning
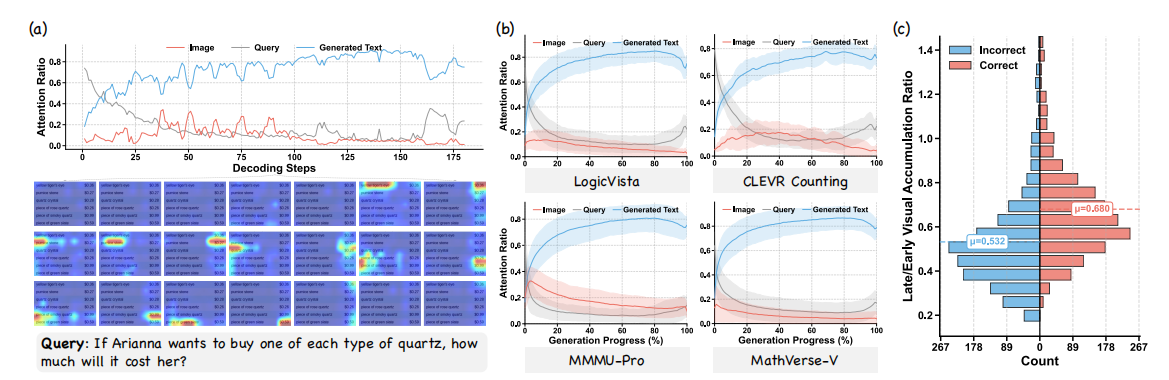
Key Findings in Multimodal Reasoning 主要通过分析多模态模型在推理过程中的注意力分配,揭示模型在长链推理中存在的视觉利用问题。其主要发现包括:
1.Text-dominated Inference and Sparse Visual Activation
在每一步生成过程中,模型的注意力主要集中在输入问题和已经生成的文本上,而分配给图像 token 的注意力整体较低。视觉信息通常只在少数推理步骤中出现明显激活,表现为"短暂看图、随后主要依赖文本继续推理"。
2.emporal Visual Forgetting
随着推理步骤增加,模型对视觉信息的关注通常会逐渐下降。文章进一步比较正确样本和错误样本的后期/前期视觉关注比例:
实验中,正确样本的平均比例约为:
而错误样本约为:
3.Inherent Visual Similarity can serve as Visual Focus Score
虽然整体视觉激活较弱,但当模型真正关注视觉信息时,其注意区域通常能够较准确地定位到与当前推理相关的图像内容。这说明模型的主要问题并非"完全看不懂图像",而是无法在后续推理中持续保持对视觉信息的关注。
因此,该部分实验最终得到的核心结论是:
多模态模型通常具备基本的视觉定位和信息提取能力,但在长链推理过程中容易逐渐转向依赖自身已经生成的文本,导致原始视觉证据被弱化甚至遗忘。
这一发现也直接构成了后续 VGPO 方法的设计依据:不是单纯增强视觉编码能力,而是让模型在后期推理中继续保持必要的视觉依赖。
3.方法思想
VGPO 的核心目标是:在强化学习训练过程中,让模型不仅关注最终答案是否正确,还关注推理过程中是否持续、合理地利用了视觉信息。
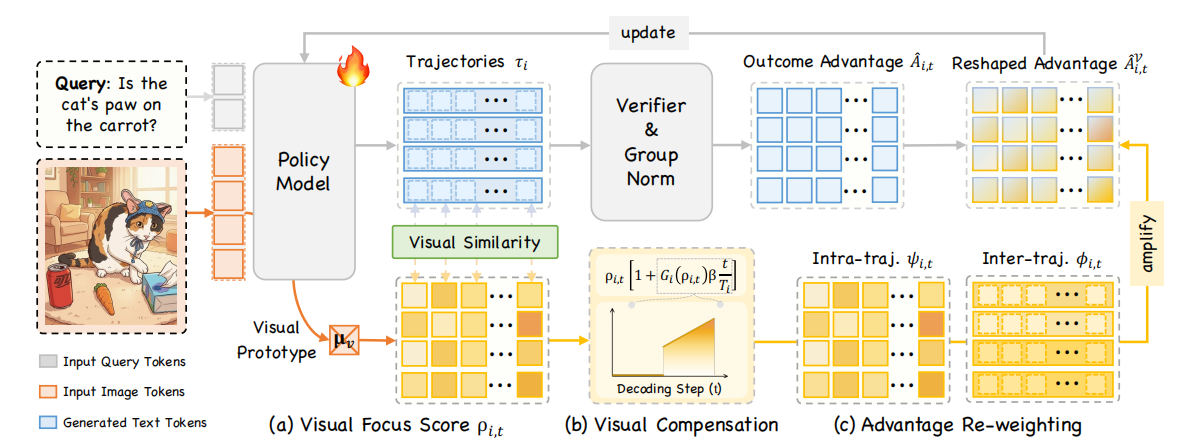
结合图中的数据流,其主要过程可以概括为:
生成多条推理结果
输入图片和文本问题后,模型针对同一问题生成多条不同的推理轨迹,并像传统 GRPO 一样根据最终答案的正确性获得奖励。判断生成内容对视觉信息的依赖程度
VGPO利用模型内部表示,比较每个生成 token 与图像视觉表示之间的相似程度。相似程度越高,说明当前生成内容与视觉信息的联系越强。补偿后期逐渐减弱的视觉关注
针对前文发现的"视觉遗忘"现象,VGPO会更加关注推理后期仍与视觉信息相关的内容,避免模型随着推理链增长完全转向依赖自身已经生成的文本。重新调整强化学习奖励。
在原有"答案是否正确"的基础上,同时考虑:最终利用重新调整后的奖励更新模型,使其逐渐学习到:不仅要得到正确答案,还应该在需要视觉证据时持续利用原始图像信息。
4.关键算法
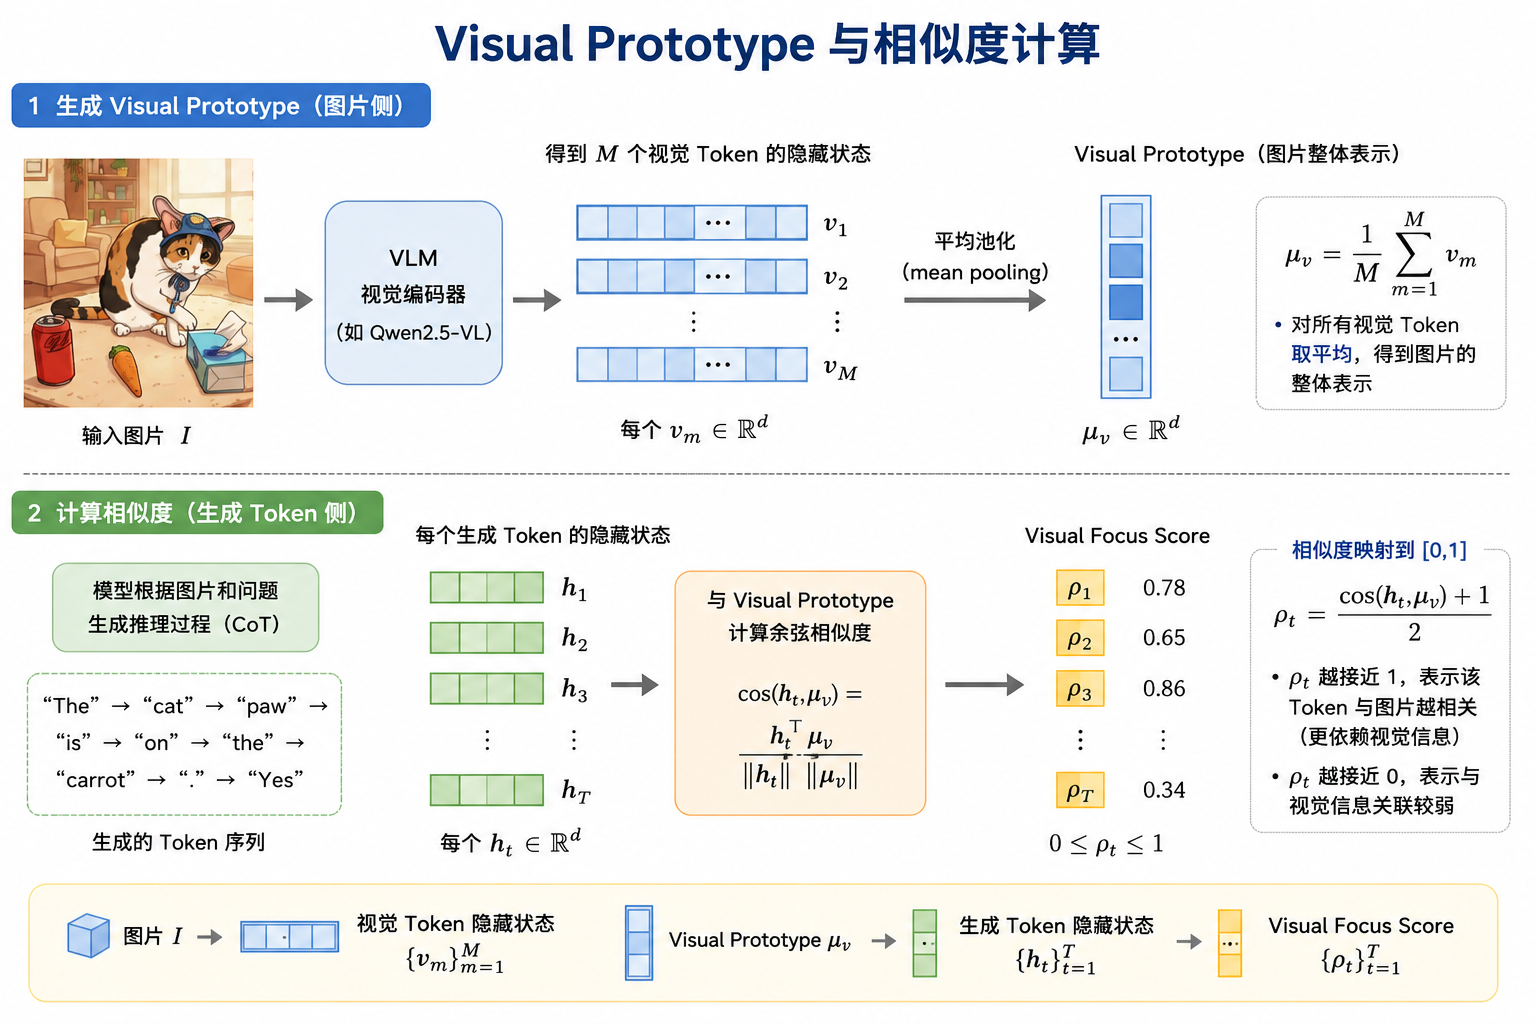
4.1.Visual Prototype 与相似度计算
首先提取图片中所有视觉 Token 的隐藏状态,并通过平均池化 得到一个整体视觉表示,即 Visual Prototype:
随后,将模型每个生成 Token 的隐藏状态与 Visual Prototype 计算余弦相似度 ,得到 Visual Focus Score:
相似度越高,表示当前生成 Token 与视觉信息的关联越强。该方法不需要额外使用 CLIP,而是直接利用 VLM 自身的内部表示。
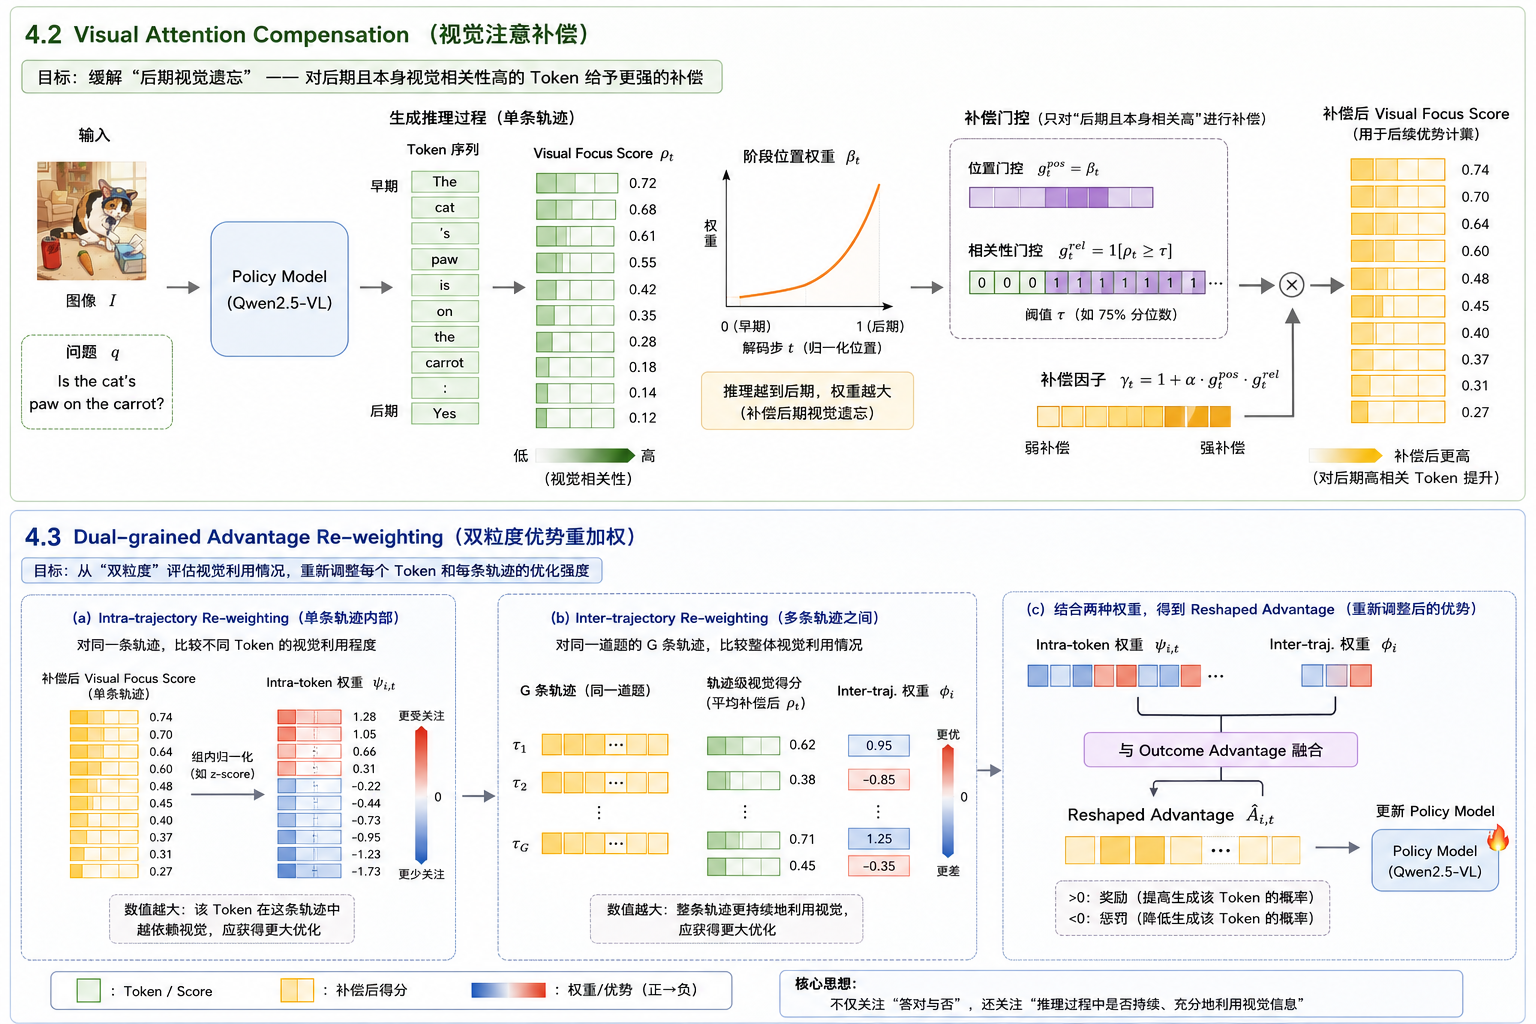
4.2 Visual Attention Compensation(视觉注意补偿)
Visual Focus Score 得到每个生成 Token 与视觉信息的相关程度以后,作者发现不能直接拿它训练,因为推理越到后期,视觉关注天然越容易下降。
因此作者加入补偿机制:
推理越靠后,对于那些本身就具有较高视觉相关性的 Token,给予更强的视觉补偿。
它不是简单粗暴地提高所有后期 Token 的视觉权重,而是有一个门控条件:
- 推理已经进入后半程;
- 当前 Token 的视觉相关程度本身较高;
满足条件才增强。
4.3 Dual-grained Advantage Re-weighting(双粒度优势重加权)
这是把前面的视觉分析真正接入 GRPO 的关键。
作者从两个尺度调整原来的奖励:
Intra-trajectory:单条推理内部比较
哪些 Token 比这条推理中的其他 Token 更依赖视觉?
视觉相关程度更高的 Token,在策略更新时获得更大的权重。
Inter-trajectory:多条推理之间比较
同一道题生成的多条回答中,哪条推理整体保持了更好的视觉利用?
视觉利用更充分的 trajectory 得到更强的优化信号。
所以 Reshaped Advantage 本身不用单独列成一个算法章节 ,它就是 4.3 最后的结果:重新决定不同生成行为应该被奖励/抑制多大程度。
5.启发
这篇论文对后续研究最重要的启发并非 VGPO 本身,而是其对多模态模型内部信息利用过程的分析。
-
自回归生成可能造成原始信息逐渐丢失。
模型生成的内容会继续成为后续生成的上下文,因此随着推理链增长,模型可能越来越依赖自身此前生成的信息,而逐渐降低对原始输入证据的利用。VGPO观察到的视觉遗忘就是这一现象在视觉模态上的具体表现。 -
"输入了某种模态"不代表模型始终在利用该模态。
即使图像和文本同时输入模型,不同推理阶段对两种模态的依赖程度也可能发生明显变化。因此,未来研究图文相关性或一致性时,不应只分析最终输出,还可以研究推理过程中图像与文本的动态依赖变化。 -
模型内部表示可以用于衡量模态相关性。
VGPO没有额外使用 CLIP,而是将视觉 Token 聚合为 Visual Prototype,再与生成 Token 的 Hidden State 计算相似度,以此估计当前生成内容对视觉信息的依赖程度。
这一思想可以迁移到未来的图文一致性研究中,例如分别构造视觉和文本表示,判断两种模态之间的相关程度,而不一定完全依赖外部相似度模型。
-
"相关"与"冲突"需要区分。
Visual Focus Score解决的主要是"当前内容与视觉信息是否相关",但低相关并不代表图文冲突。例如图片无法验证文本中的某项信息时,也可能表现为低相关。因此未来若研究图文一致性,可以进一步拆分为:
图文输入 ↓ 相关性 / 可验证性判断 ↓ 是否存在共同语义证据? ↓ 一致性 / 冲突判断 ↓ 图像支持文本 / 图像反驳文本 / 无法判断 -
研究问题的发现方式值得借鉴。
论文不是先提出 VGPO 再寻找应用场景,而是从错误案例出发,通过 Attention 分析发现文本主导现象,再通过跨数据集统计和正确/错误样本对比确认 Temporal Visual Forgetting,最后才针对该现象设计优化方法。
因此以后面对"图文是否表达一致"这类问题,可以优先采用:
观察失败案例
    ↓
分析模型内部行为
    ↓
提出潜在异常现象
    ↓
设计指标量化
    ↓
在不同数据/模型上验证是否普遍存在
    ↓
最后设计针对性方法
核心启发: 与其直接设计一个"图文一致性门控",更值得首先研究:当图像和文本共同输入时,模型究竟如何在两种模态之间分配依赖;这种依赖是否会随着自回归推理发生漂移;当图文存在冲突时,模型又会逐渐相信哪一种模态。 如果这些现象能够被稳定测量和验证,本身就可能形成后续研究的问题基础。