大宗商品销采运储系统・六层架构连载(公共中间件层)
上一篇(消息队列中篇),我们重点拆解了事务消息和业务幂等,解决销采运储单据场景下,数据库事务与消息投递的原子性、消息重复消费脏数据两大核心问题。事务消息保障事件可靠发出,幂等控制防止重复处理。
但系统上线运行之后,大量的故障不是来自业务代码,而是消息队列运维层面:
-
消息堆积;
-
无限重试引发重试风暴;
-
异常消息污染正常队列;
-
集群无告警,等到故障爆发才发现。
本篇聚焦生产运维治理,讲解消息队列集群的异常治理、监控告警、故障应急方案,完成消息队列整套落地闭环。
一句话定调:
事务消息和幂等解决业务正确性;堆积治理、死信、监控告警解决系统稳定性。
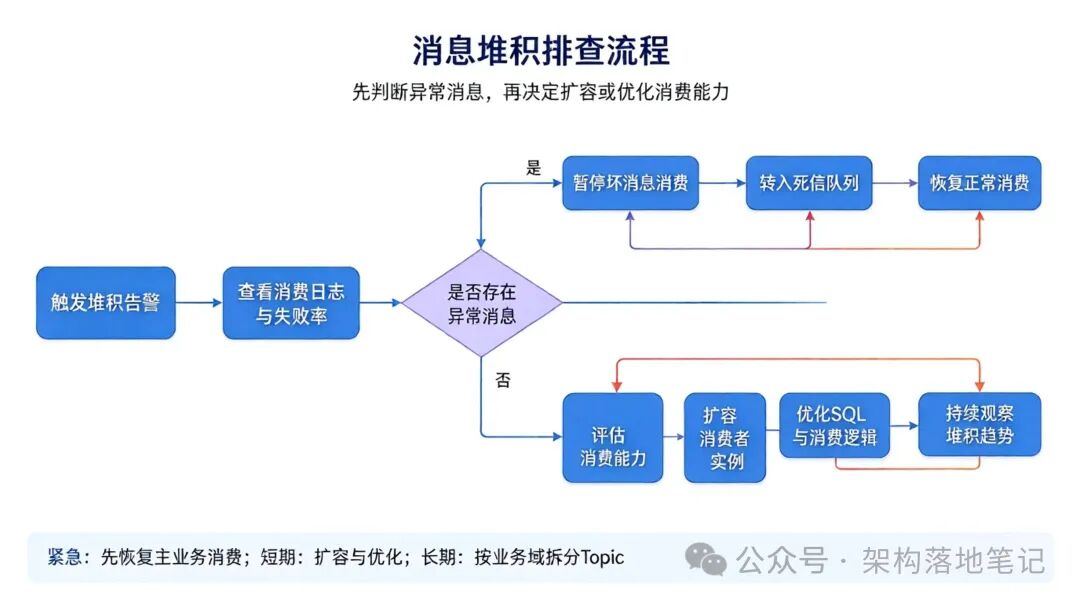
一、消息堆积:定位原因与分级治理
消息堆积是 RocketMQ 最常见的线上问题。本质一句话:
生产者生产速度 > 消费者消费速度。
大宗商品业务极易出现堆积场景:月底批量对账、夜间大批量单据同步、开盘瞬间大量订单涌入。
1. 堆积常见根因
-
消费逻辑过重:消费内部包含复杂查询、大事务、同步调用外部接口,单条消息处理耗时久;
-
下游服务故障:数据库慢、第三方接口超时,消费卡住;
-
消费实例不足:并发线程数配置过小,消费能力不足;
-
异常消息持续重试:坏消息反复重试占用消费线程,拖垮整个队列;
-
Topic 分区数不足:分区决定消费最大并发,分区太少无法横向扩容。
2. 分级治理方案
| 级别 | 措施 | 说明 |
|---|---|---|
| 紧急预案 | 临时扩容消费者实例 | 提升消费并发,快速消化积压消息 |
| 短期优化 | 拆分消费逻辑 | 剥离非核心逻辑,优化 SQL 与索引 |
| 长期架构 | 按业务域拆分 Topic | 大流量单据和普通通知消息隔离 |
| 容量规划 | 合理规划分区数量 | 分区数决定消费并发上限 |
工程规范:
禁止无限堆积,设置堆积阈值告警,不要等到消息堆积几十万条之后再处理。
3. 堆积监控命令示例
# 查看 Topic 堆积情况mqadmin consumerProgress -n 10.0.0.20:9876 -g stock-consumer-group
# 查看指定 Topic 的消费 TPSmqadmin topicStatus -n 10.0.0.20:9876 -t supply_order_stock_topi
二、重试风暴与死信队列完整治理
1. 重试机制的坑
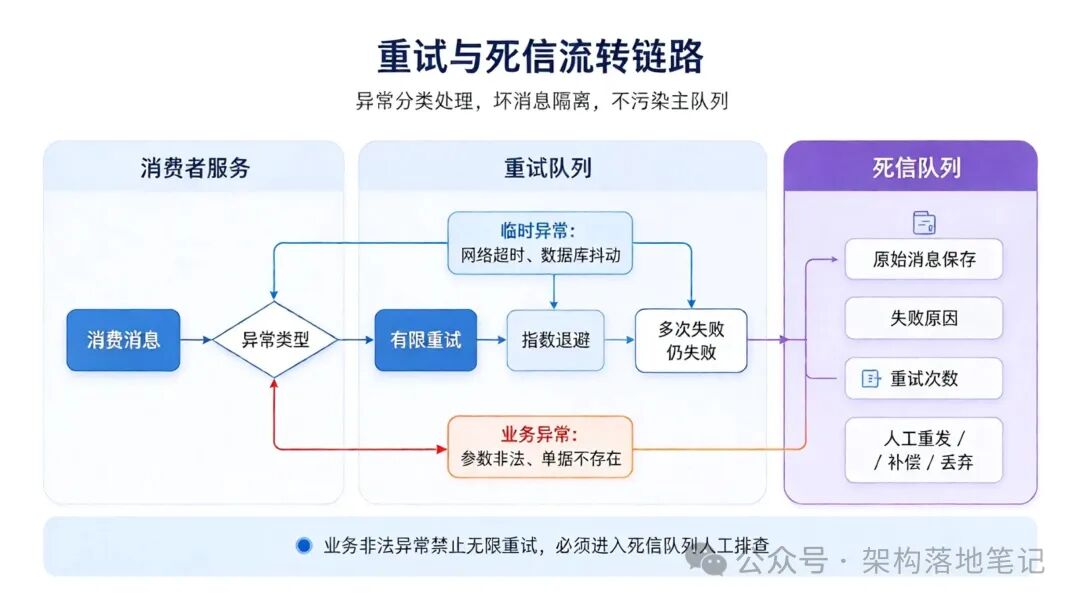
RocketMQ 消费失败默认会自动重试。如果一条业务校验失败的消息,反复重试,会持续占用消费线程,甚至把正常消息阻塞,引发重试风暴。
区分异常类型,设置不同策略:
| 异常类型 | 示例 | 处理策略 |
|---|---|---|
| 临时性异常 | 网络抖动、数据库短暂超时 | 有限次数重试,指数退避,拉长重试间隔 |
| 业务非法异常 | 单据不存在、参数错误、业务规则不满足 | 禁止重试,直接投递死信队列 |
2. 重试配置示例
rocketmq: consumer: # 最大重试次数 max-reconsume-times: 3 # 重试间隔(毫秒),指数退避 suspend-current-queue-time-millis: 1000
3. 死信队列设计
多次重试依然处理失败的消息,自动转入死信 Topic。
死信不是丢弃消息,而是故障消息的隔离区,核心能力:
-
独立 Topic:和正常业务消息物理隔离,坏消息不会污染主业务队列;
-
完整记录:保存原始消息内容、重试次数、失败堆栈、发生时间;
-
管理后台:查看消息、重发、人工补偿、丢弃。
4. 死信队列配置示例
@RocketMQMessageListener(
    topic = "supply_order_stock_topic",
    consumerGroup = "stock-consumer-group",
    maxReconsumeTimes = 3
)
public class StockOrderConsumer implements RocketMQListener<OrderStockDTO> {

    @Override
    public void onMessage(OrderStockDTO message) {
        try {
            stockService.createStockOrder(message);
        } catch (BusinessException e) {
            // 业务非法异常,禁止重试,直接转入死信
            log.error("业务异常,消息转入死信,orderNo={}", message.getOrderNo(), e);
            throw new MessageBizException(e.getMessage());
        }
        // 临时异常继续抛出,RocketMQ 自动重试
    }
}
销采运储业务落地规范:
所有核心单据 Topic 必须配置对应的死信 Topic;死信消息产生后触发告警,运维人员及时介入排查,不能放任不管。
三、集群监控与告警体系搭建
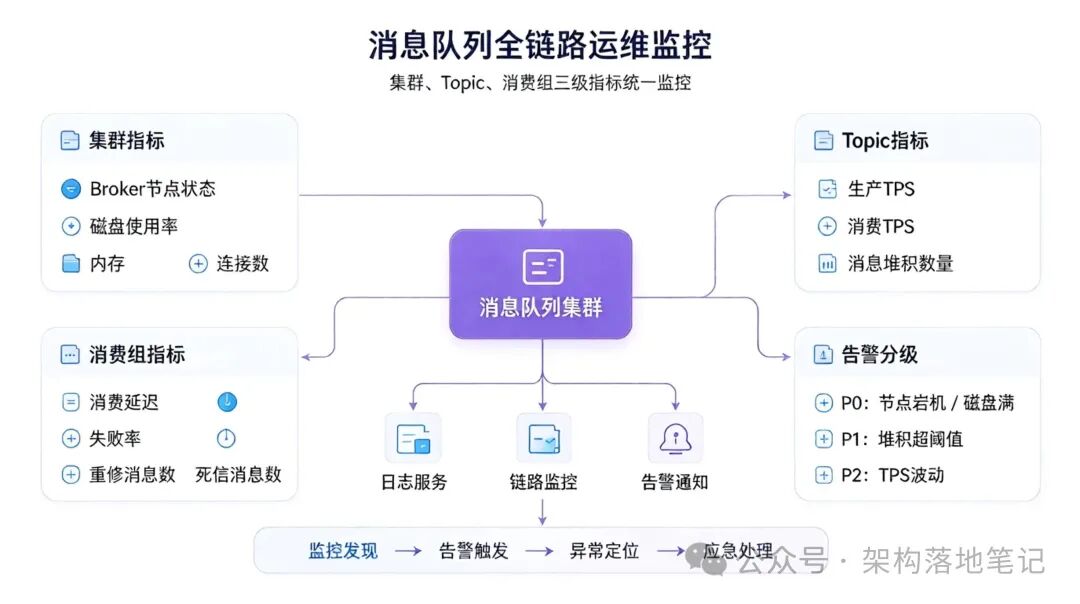
只靠人工登录后台查看集群,无法提前发现隐患,需要一套完整监控指标体系。
1. 核心监控指标
| 层级 | 指标 | 说明 |
|---|---|---|
| 集群 | Broker 节点状态、磁盘使用率、内存、连接数 | 判断集群健康度 |
| Topic | 生产 TPS、消费 TPS、消息堆积数量 | 判断 Topic 流量与积压 |
| 消费组 | 消费延迟、消费失败率、重试消息数、死信消息数 | 判断消费健康度 |
2. 告警分级
| 级别 | 触发条件 | 通知方式 |
|---|---|---|
| P0 紧急 | Broker 节点宕机、磁盘满、大量死信产生 | 电话 + 短信 |
| P1 重要 | 消息堆积超过阈值、消费失败率突增 | 企业微信/钉钉 |
| P2 观察 | TPS 波动、延迟小幅上涨 | 日志记录,每日报表汇总 |
3. Prometheus 监控指标示例
# RocketMQ Exporter 关键指标
rocketmq_producer_tps{topic="supply_order_stock_topic"}
rocketmq_consumer_tps{group="stock-consumer-group"}
rocketmq_group_diff{group="stock-consumer-group"}          # 消费堆积量
rocketmq_group_get_latency_by_storetime{group="stock-consumer-group"}  # 消费延迟
rocketmq_producer_offset{topic="supply_order_stock_topic"}
rocketmq_consumer_offset{group="stock-consumer-group"}
4. 告警规则示例
groups:  - name: rocketmq-alert    rules:      - alert: RocketMQMessageAccumulation        expr: rocketmq_group_diff{group="stock-consumer-group"} > 10000        for: 5m        labels:          severity: P1        annotations:          summary: "消费组 {{ $labels.group }} 消息堆积超过 1 万条"
      - alert: RocketMQDeadLetter        expr: increase(rocketmq_group_dead_letter_count[5m]) > 0        labels:          severity: P0        annotations:          summary: "消费组 {{ $labels.group }} 产生死信消息"
落地要求:
监控数据接入系统现有链路监控、日志服务,把消息队列指标统一纳入大盘。
四、生产环境故障应急案例:月底对账消息堆积
场景:
月底财务对账任务批量触发,大量对账消息涌入 Topic,消费处理慢,消息持续堆积。
应急步骤:
-
监控触发堆积告警,收到通知;
-
排查消费日志,确认无大量业务异常消息,属于流量突增;
-
临时扩容消费者实例,提升消费并发,快速消化积压;
-
优化对账消费逻辑,拆分大事务,减少单条消息处理耗时;
-
事后复盘,调整任务调度时间,将批量对账任务错峰执行,避开业务高峰。
如果排查发现是非法业务消息导致持续重试,则暂停消费,把坏消息转入死信,恢复正常队列消费。
五、消息队列整套系列总结
消息队列三篇连载到此完成:
| 篇 | 核心内容 | 解决什么问题 |
|---|---|---|
| 上篇 | 基础架构、流转模型、选型、基础代码 | 理解消息队列能干什么 |
| 中篇 | 事务消息、业务幂等 | 解决核心单据数据一致性 |
| 下篇 | 堆积治理、重试风暴、死信、监控告警 | 保障生产环境长期稳定运行 |
一句话总结整套消息队列:
消息队列通过异步解耦、削峰填谷提升系统弹性;事务消息保障事件可靠投递;幂等控制防止重复业务;死信、监控、堆积治理守住生产稳定性底线,共同支撑大宗商品销采运储全链路单据流转。
下篇预告:进入 Redis 缓存体系架构(上篇),讲解集群架构、多级缓存、热点 Key 治理,以及大宗商品库存、商品报价、客户基础信息的缓存实战落地。