如果数组的每一对相邻元素都是两个奇偶性不同的数字,则该数组被认为是一个 特殊数组 。
周洋哥有一个整数数组 nums 和一个二维整数矩阵 queries,对于 queriesi = fromi, toi,请你帮助周洋哥检查子数组 numsfromi...toi 是不是一个 特殊数组 。
返回布尔数组 answer,如果 numsfromi...toi 是特殊数组,则 answeri 为 true ,否则,answeri 为 false 。
示例 1:
输入:nums = 3,4,1,2,6, queries = \[0,4]
输出:false
解释:
子数组是 3,4,1,2,6。2 和 6 都是偶数。
示例 2:
输入:nums = 4,3,1,6, queries = \[0,2,2,3]
输出:false,true
解释:
子数组是 4,3,1。3 和 1 都是奇数。因此这个查询的答案是 false。
子数组是 1,6。只有一对:(1,6),且包含了奇偶性不同的数字。因此这个查询的答案是 true。
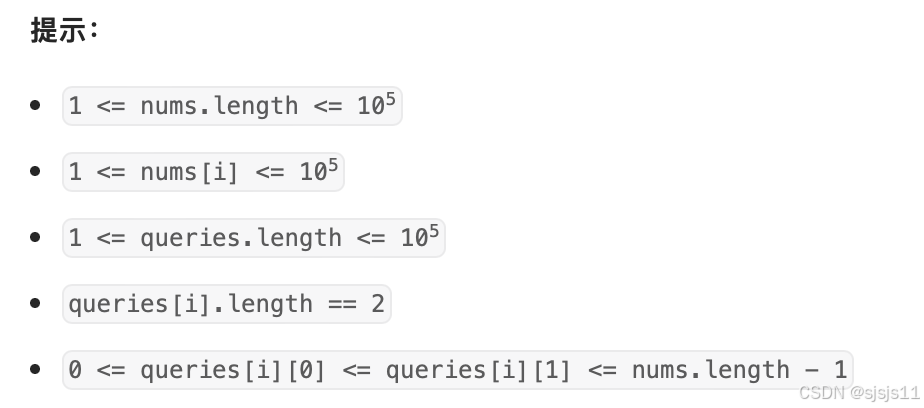
超时代码
cpp
class Solution {
public:
    vector<bool> isArraySpecial(vector<int>& nums, vector<vector<int>>& queries) {
        vector<int> group(nums.size());
        for(int i = 0;i<nums.size();i++){
            group[i] = (nums[i] % 2 == 0) ? 0 : 1;
        }

        return CheckIt(group, queries);
    }

private:
    vector<bool> CheckIt(vector<int>& group, vector<vector<int>>& queries){
        vector<bool> answer;
        for(const auto query : queries){
            bool flag = true;
            for(int i = query[0];i < query[1];i++){
                if(group[i] == group[i+1]){
                    flag = false;
                    break;
                }
            }
            answer.push_back(flag);
        }
        return answer;
    }
};
group储存偶数为0,奇数为1;
第一次写的代码超时了,问题出在了以下循环
cpp
	  	  for(int i = query[0];i < query[1];i++){
              if(group[i] == group[i+1]){
                  flag = false;
                  break;
              }
          }
我们在处理每次query的时候,根据query给的上限和下限又重新遍历了数组,当query较大的时候,就会消耗很多内存。所以可以考虑是不是可以避免每次计算answer是true还是false的时候,都要把group里面对应的元素循环一遍
优化后的代码
cpp
class Solution {
public:
    vector<bool> isArraySpecial(vector<int>& nums, vector<vector<int>>& queries) {
        vector<int> group(nums.size());
        for(int i = 0;i<nums.size();i++){
            group[i] = (nums[i] % 2 == 0) ? 0 : 1;
        }
        vector<int> prefix(nums.size(), 0);
        for(int i = 1;i < nums.size();i++){
            prefix[i] = prefix[i-1];
            if(group[i] == group[i-1]){
                prefix[i]++;
            }
        }

        vector<bool> answer;
        for(const auto& query : queries){
            int sameCount = prefix[query[1]] - prefix[query[0]];
            answer.push_back(sameCount == 0);
        }
        return answer;
    }
};
所以为了避免一直重复的遍历数组,定义一个prefix用来储存group在 i 次前相同字符出现次数(也就是有两个false或者两个true相邻的次数)。所以只需要看在某个范围内,prefix上限 减去 prefix下限如果为0,说明没有出现过两个false和两个true相邻的情况,说明是特殊字符。