【强化学习基础概念】

State 状态

智能体的位置就是状态

State Space

状态的集合

Action

对每个状态来说,可能发出的行为

Action Space of a state

一个状态发出所有动作的集合。

State transition

状态变换的过程

Policy

在每个状态应该采取什么动作

tells the agent what actions to take at a state

确定性策略概率为1,随机粗略采集动作为概率和为1

Reward

采取一个动作后得到数字。

trajectory

一个状态行为回报链
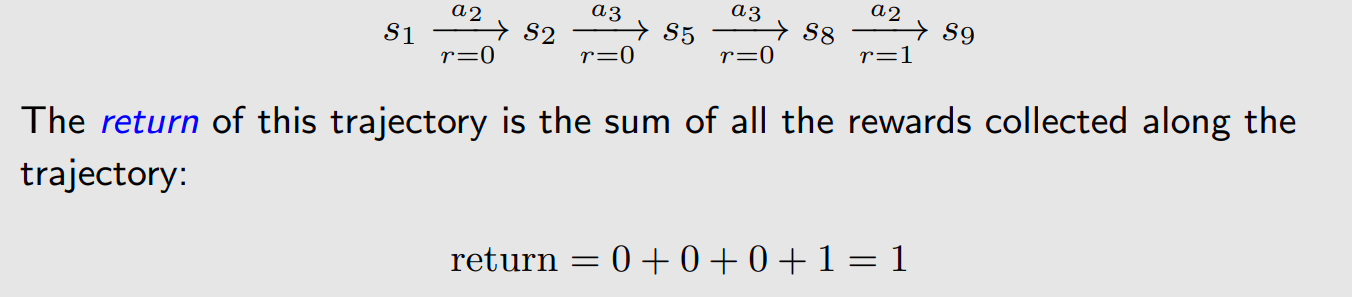
return

return 就是所有的rewards加在一起的总和。
discount return,当前的奖励r不加γ,后面乘以γ,按照次数多少进行加倍进行乘以伽马,然后所有的求和就是discount return。也就是打了折的return.

episode

有限的trajectory。

continuing tasks

无线的trajectory,一直跟环境进行交互。

MDP

Markov decision process,马尔科夫决策过程。

Sets:

  • State
  • Action
  • Reward

Probability:

  • 状态转移概率,
    状态s,采取动作a,转移到s'的概率。
  • 回报概率
  • 状态s,采取动作a,获得回报r的概率

Policy

Markov Property

只跟上一时刻相关。

State Value

说白了就是reward的总和,带有discount的return
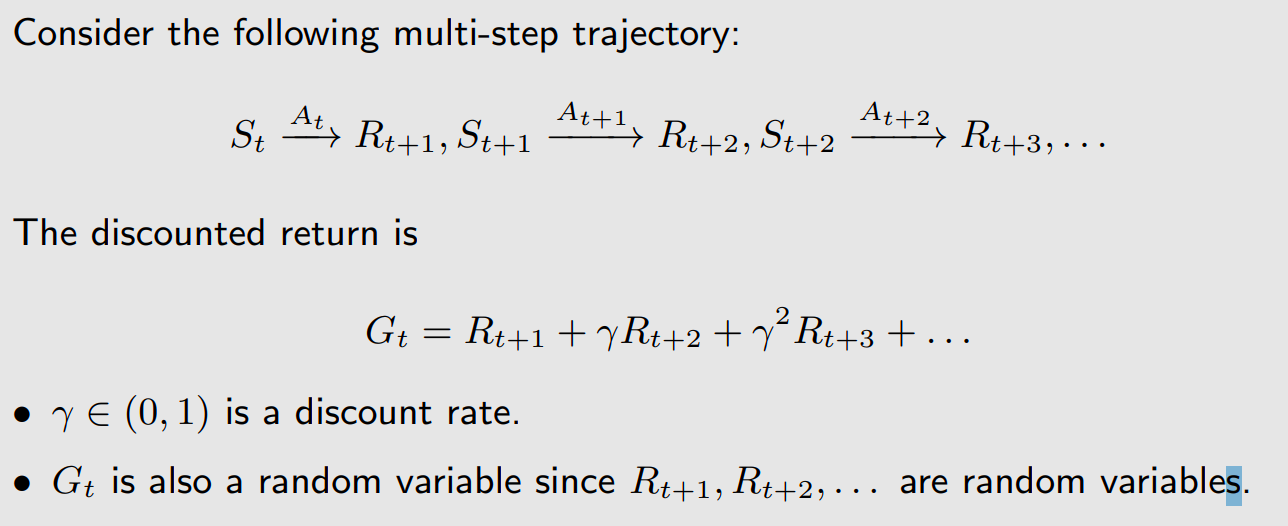
以上以为一个trajectory。不确定是否有限,如果有限就是episode。
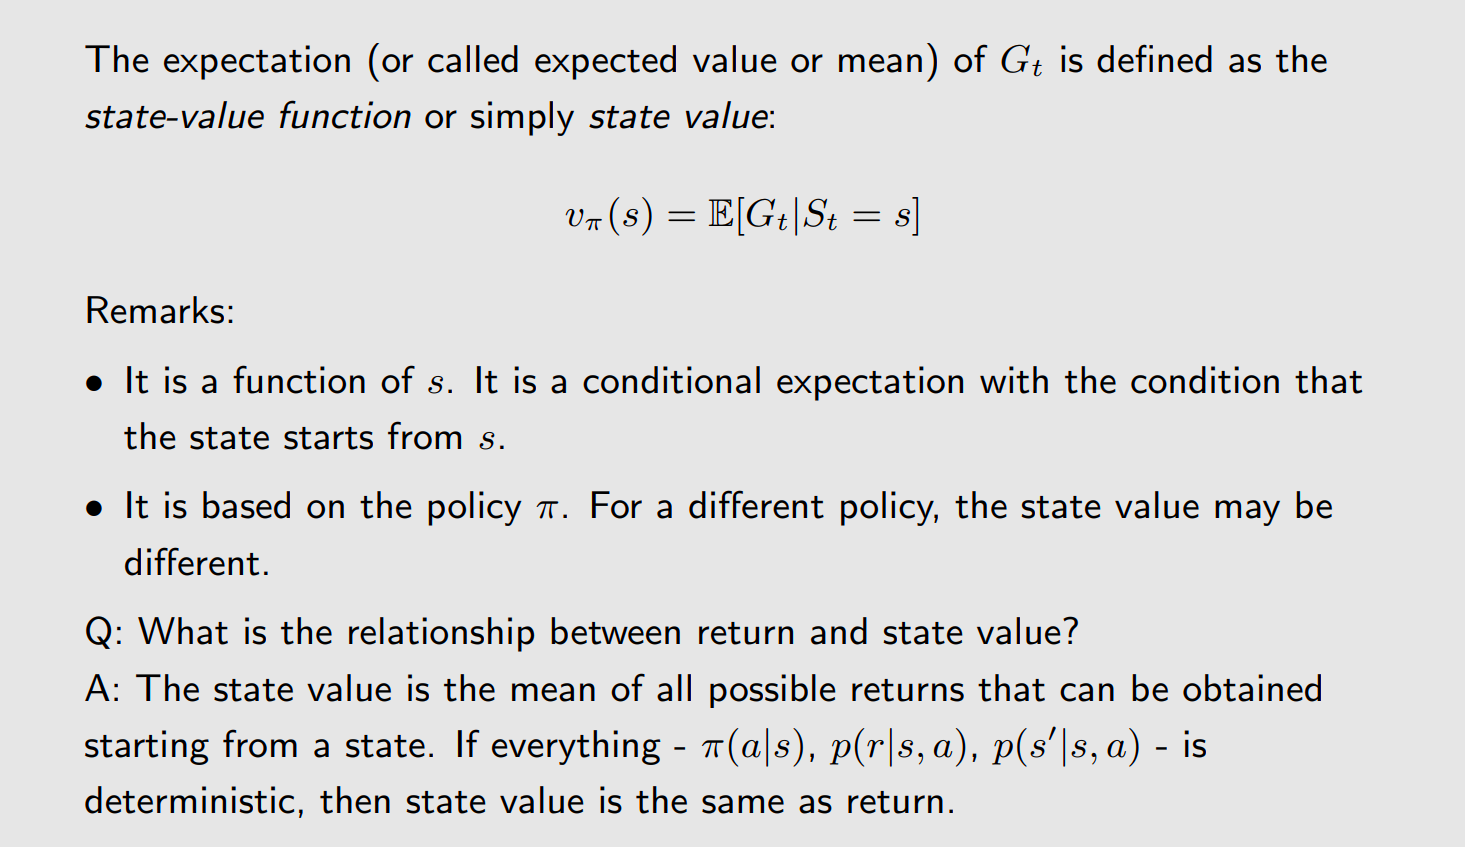
按照策略π,带有discount的return总和。

相关推荐
猫先生Mr.Mao1 天前
让动作先接受“未来检验”:ThinkWorld 如何用世界想象强化机器人推理
机器人·强化学习·具身智能·vla·世界模型·thinkworld
Jsundoku1 天前
第三章 强化学习 -- 多臂老虎机
人工智能·强化学习·多臂老虎机·朴素策略·置信上界算法·贝叶斯老虎机·上下文老虎机
ZhengEnCi2 天前
想让AI能力翻倍需要多少数据:874条专家轨迹的后训练杠杆效应
llm·agent·强化学习
郝学胜-神的一滴2 天前
AI 编程智能体 17:四步搞定专属AI智能体
大数据·人工智能·python·神经网络·算法·langchain·强化学习
zh路西法4 天前
【模型式强化学习】(三):MBPO——短轨迹生成与模型数据驱动的策略优化
python·强化学习·pe·sac·pets·mbpo·mbrl
Together_CZ6 天前
Introducing Kimi K3.1 Pro——隆重推出 Kimi K3.1 Pro
llm·agent·强化学习·1024程序员节·kimi·kimi k3.1 pro·3t参数
zh路西法6 天前
【四足强化学习经典算法】(一):RMA——盲视运动控制与快速适应模块
pytorch·强化学习·1024程序员节·四足机器人·dagger·pyhon·rma
迷途呀6 天前
强化学习概念
人工智能·深度学习·机器学习·强化学习·1024程序员节
山顶夕景6 天前
【VideoLLM】Agentic Video Understanding视频理解综述
agent·强化学习·1024程序员节·视频理解·agentic·多模态理解·grpo