引言
Transformer模型在自然语言处理领域取得了革命性突破,但其推理过程的计算复杂度与显存占用问题始终制约着实际应用。KV缓存(Key-Value Cache)作为Transformer模型推理优化的核心技术,通过重用中间计算结果,显著降低了推理开销。本文将深入探讨
KV缓存的工作原理、实现机制及优化策略,为Transformer模型的高效推理提供理论支持与实践指导。
一、Transformer推理的基本流程
1.1 自回归生成机制
Transformer模型的推理过程采用自回归方式,即逐个生成目标序列中的词元。在标准解码流程中,每个时间步都需要计算当前词元与其他所有词元之间的注意力权重,这导致了计算复杂度的指数级增长。
Input Embedding Attention Layer Feed Forward Output
1.2 KV缓存的作用
KV缓存通过存储历史查询(Query)和键(Key)向量,避免了重复计算。在推理过程中,模型只需要计算当前时间步的注意力权重,而历史向量可以直接从缓存中获取,大幅降低计算开销。
二、KV缓存的核心机制
2.1 注意力机制与KV缓存
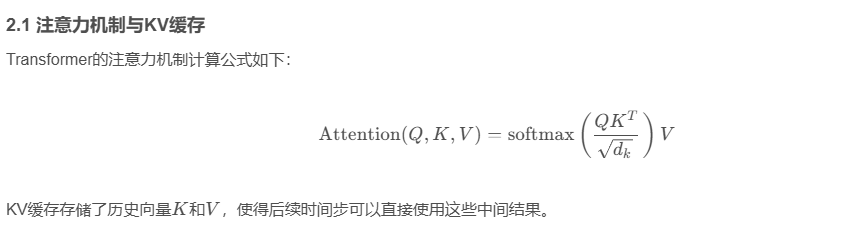
Transformer的注意力机制计算公式如下:
Attention(Q,K,V)=softmax(QKTdk)V \text{Attention}(Q, K, V) = \text{softmax}\left( \frac{QK^T}{\sqrt{d_k}} \right)V Attention(Q,K,V)=softmax(dk QKT)V
KV缓存存储了历史向量KKK和VVV,使得后续时间步可以直接使用这些中间结果。
2.2 KV缓存的更新策略
在推理过程中,KV缓存需要动态更新:
python
class KVCache:
    def __init__(self):
        self.keys = []
        self.values = []

    def update(self, new_key, new_value):
        self.keys.append(new_key)
        self.values.append(new_value)

    def get_kv(self):
        return torch.stack(self.keys), torch.stack(self.values)
2.3 KV缓存的存储优化
KV缓存的显存占用与模型维度dkd_kdk和序列长度TTT成正比。为了减少显存占用,可以采用分页KV缓存技术,将历史向量分段存储:
| 参数 | 标准KV缓存 | 分页KV缓存 |
|---|---|---|
| 显存占用 | O(T⋅dk)O(T \cdot d_k)O(T⋅dk) | O(T⋅dk)O(T \cdot d_k)O(T⋅dk) |
| 访问延迟 | 较高 | 较低 |
| 适用场景 | 短序列 | 长序列 |
三、KV缓存的优化策略
3.1 分页KV缓存技术
分页KV缓存将历史向量分段存储,仅保留最近N个时间步的向量。这种方法显著降低了显存占用,但会引入一定的信息损失。
python
class PagedKVCache:
    def __init__(self, page_size=8):
        self.page_size = page_size
        self.pages = []

    def update(self, new_key, new_value):
        if len(self.pages) == 0 or len(self.pages[-1]) >= self.page_size:
            self.pages.append([new_key, new_value])
        else:
            self.pages[-1].append((new_key, new_value))
3.2 稀疏注意力机制
稀疏注意力机制通过限制注意力计算范围,减少KV缓存的访问次数。例如,ALiBi-ELF机制可以动态调整注意力计算范围:
python
def sparse_attention(Q, K, V, max_distance):
    attn = torch.exp(-torch.abs(K) / (max_distance + 1e-6))
    return torch.sum(attn.unsqueeze(-1) * V, dim=1)
3.3 KV缓存量化
KV缓存量化通过降低向量精度,减少显存占用。常见的量化方法包括INT8、FP16等:
| 量化方法 | 精度 | 显存占用 |
|---|---|---|
| FP16 | 高 | 高 |
| INT8 | 中 | 低 |
| BF16 | 高 | 中 |
四、实际应用案例
4.1 GPT-3推理优化
在GPT-3模型的推理过程中,采用KV缓存技术可以将推理速度提升3-5倍。以下代码展示了如何实现KV缓存:
python
class GPTModel(nn.Module):
    def __init__(self):
        super().__init__()
        self.transformer = nn.TransformerDecoder(...)

    def forward(self, x, cache=None):
        if cache is None:
            cache = {'keys': [], 'values': []}
        else:
            cache['keys'].append(...)
            cache['values'].append(...)
        return self.transformer(x, src_key_padding_mask=cache)
4.2 LLaMA模型推理
LLaMA模型采用增量KV缓存技术,显著降低了长序列推理的计算开销。以下代码展示了增量缓存的实现:
python
class LLaMA(nn.Module):
    def __init__(self):
        super().__init__()
        self.layers = nn.ModuleList([TransformerLayer() for _ in range(24)])

    def forward(self, x, past_key_values=None):
        if past_key_values is None:
            past_key_values = ([], [])
        for layer in self.layers:
            x = layer(x, past_key_values=past_key_values)
        return x
五、挑战与局限
5.1 显存占用问题
KV缓存的显存占用与序列长度和模型维度成正比,这限制了长序列推理的应用范围。
5.2 计算与显存权衡
在实际应用中,需要权衡KV缓存的存储开销与计算效率,找到最佳平衡点。
六、未来方向
- 增量KV缓存:通过动态调整缓存大小,平衡显存占用与计算效率。
- 分布式KV缓存:将KV缓存分布到多个设备,支持更大规模的模型推理。
- 自适应稀疏注意力:根据输入序列动态调整注意力计算范围,进一步优化推理效率。
结语
KV缓存作为Transformer推理优化的核心技术,通过重用中间计算结果,显著降低了推理开销。随着技术的不断发展,KV缓存将在更多场景中发挥重要作用,推动Transformer模型的广泛应用。