MATLAB代码实现了一个TCN-Transformer-BiGRU 混合深度学习模型 ,用于多输入多输出回归预测任务,并集成了模型解释与可视化功能。
一、研究背景
该模型结合了三种先进的深度学习结构:
- TCN(时序卷积网络):用于捕获长期依赖关系,具有因果卷积和膨胀卷积结构。
- Transformer:引入自注意力机制,增强对重要特征的关注能力。
- BiGRU(双向门控循环单元):捕捉序列数据的前后依赖关系。
这种混合结构旨在融合**局部特征提取(TCN)、全局依赖建模(Transformer)和时序建模(BiGRU)**的优势,适用于复杂时序或序列回归问题。
二、主要功能
- 数据预处理:归一化、训练集/测试集划分(可选是否打乱)。
- 模型构建:构建 TCN + Transformer + BiGRU 混合网络。
- 模型训练:使用 Adam 优化器进行训练,支持学习率衰减。
- 预测与评估:对训练集和测试集进行预测,计算 RMSE、MAE、R² 等指标。
- 可视化分析 :
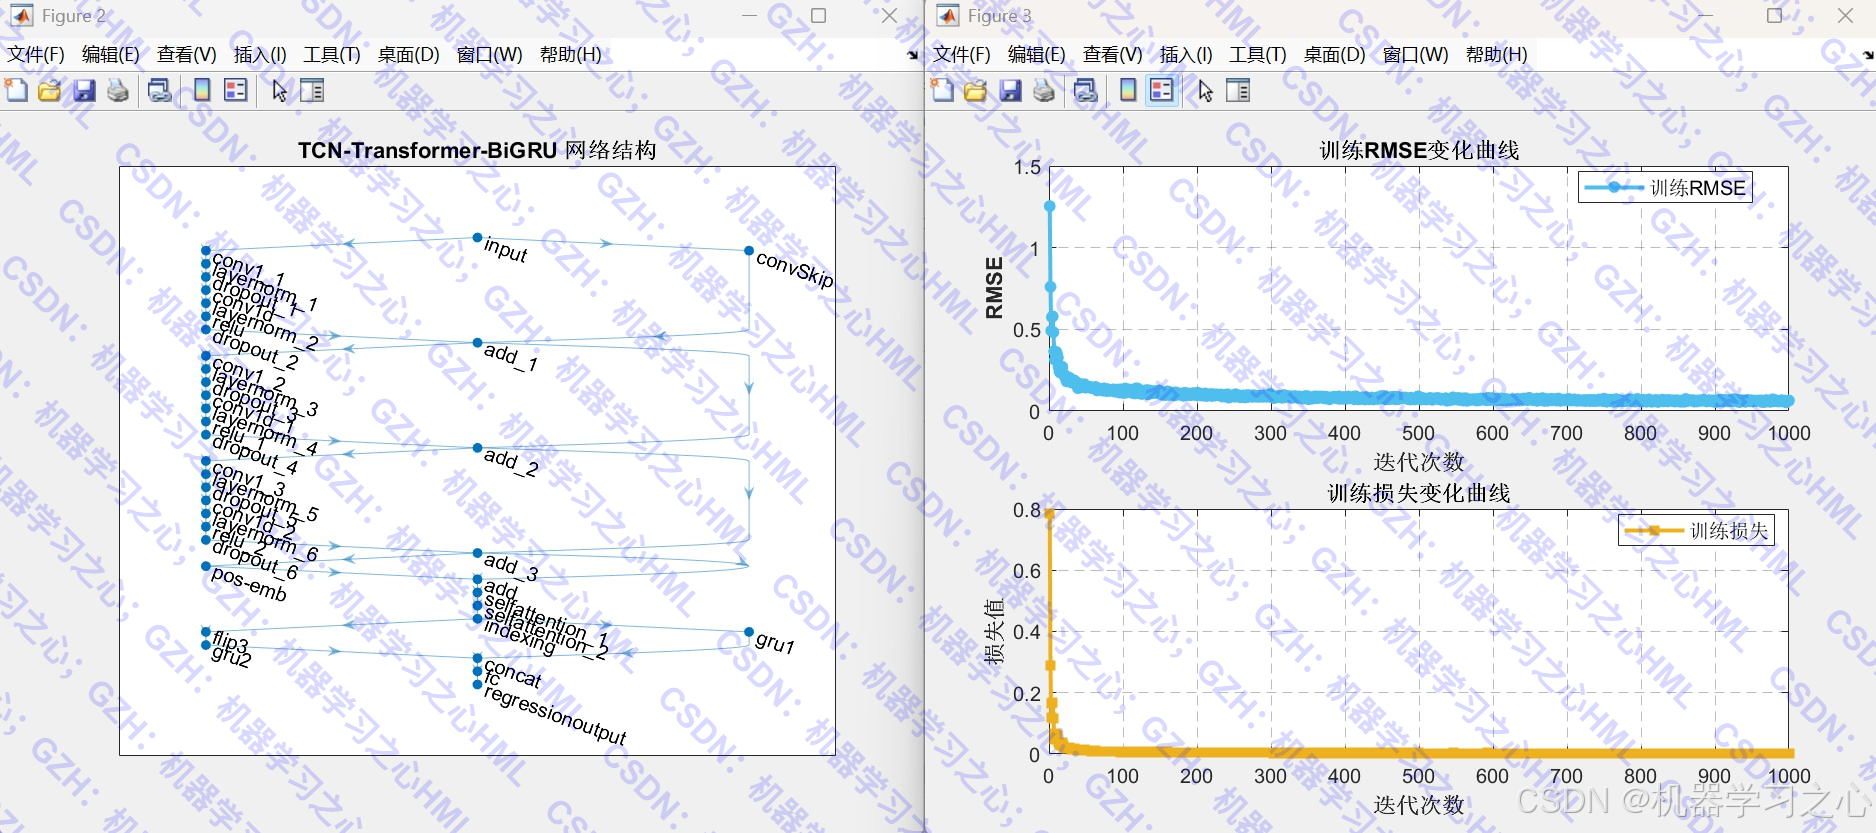
- 网络结构图
- 训练过程曲线(RMSE、Loss)
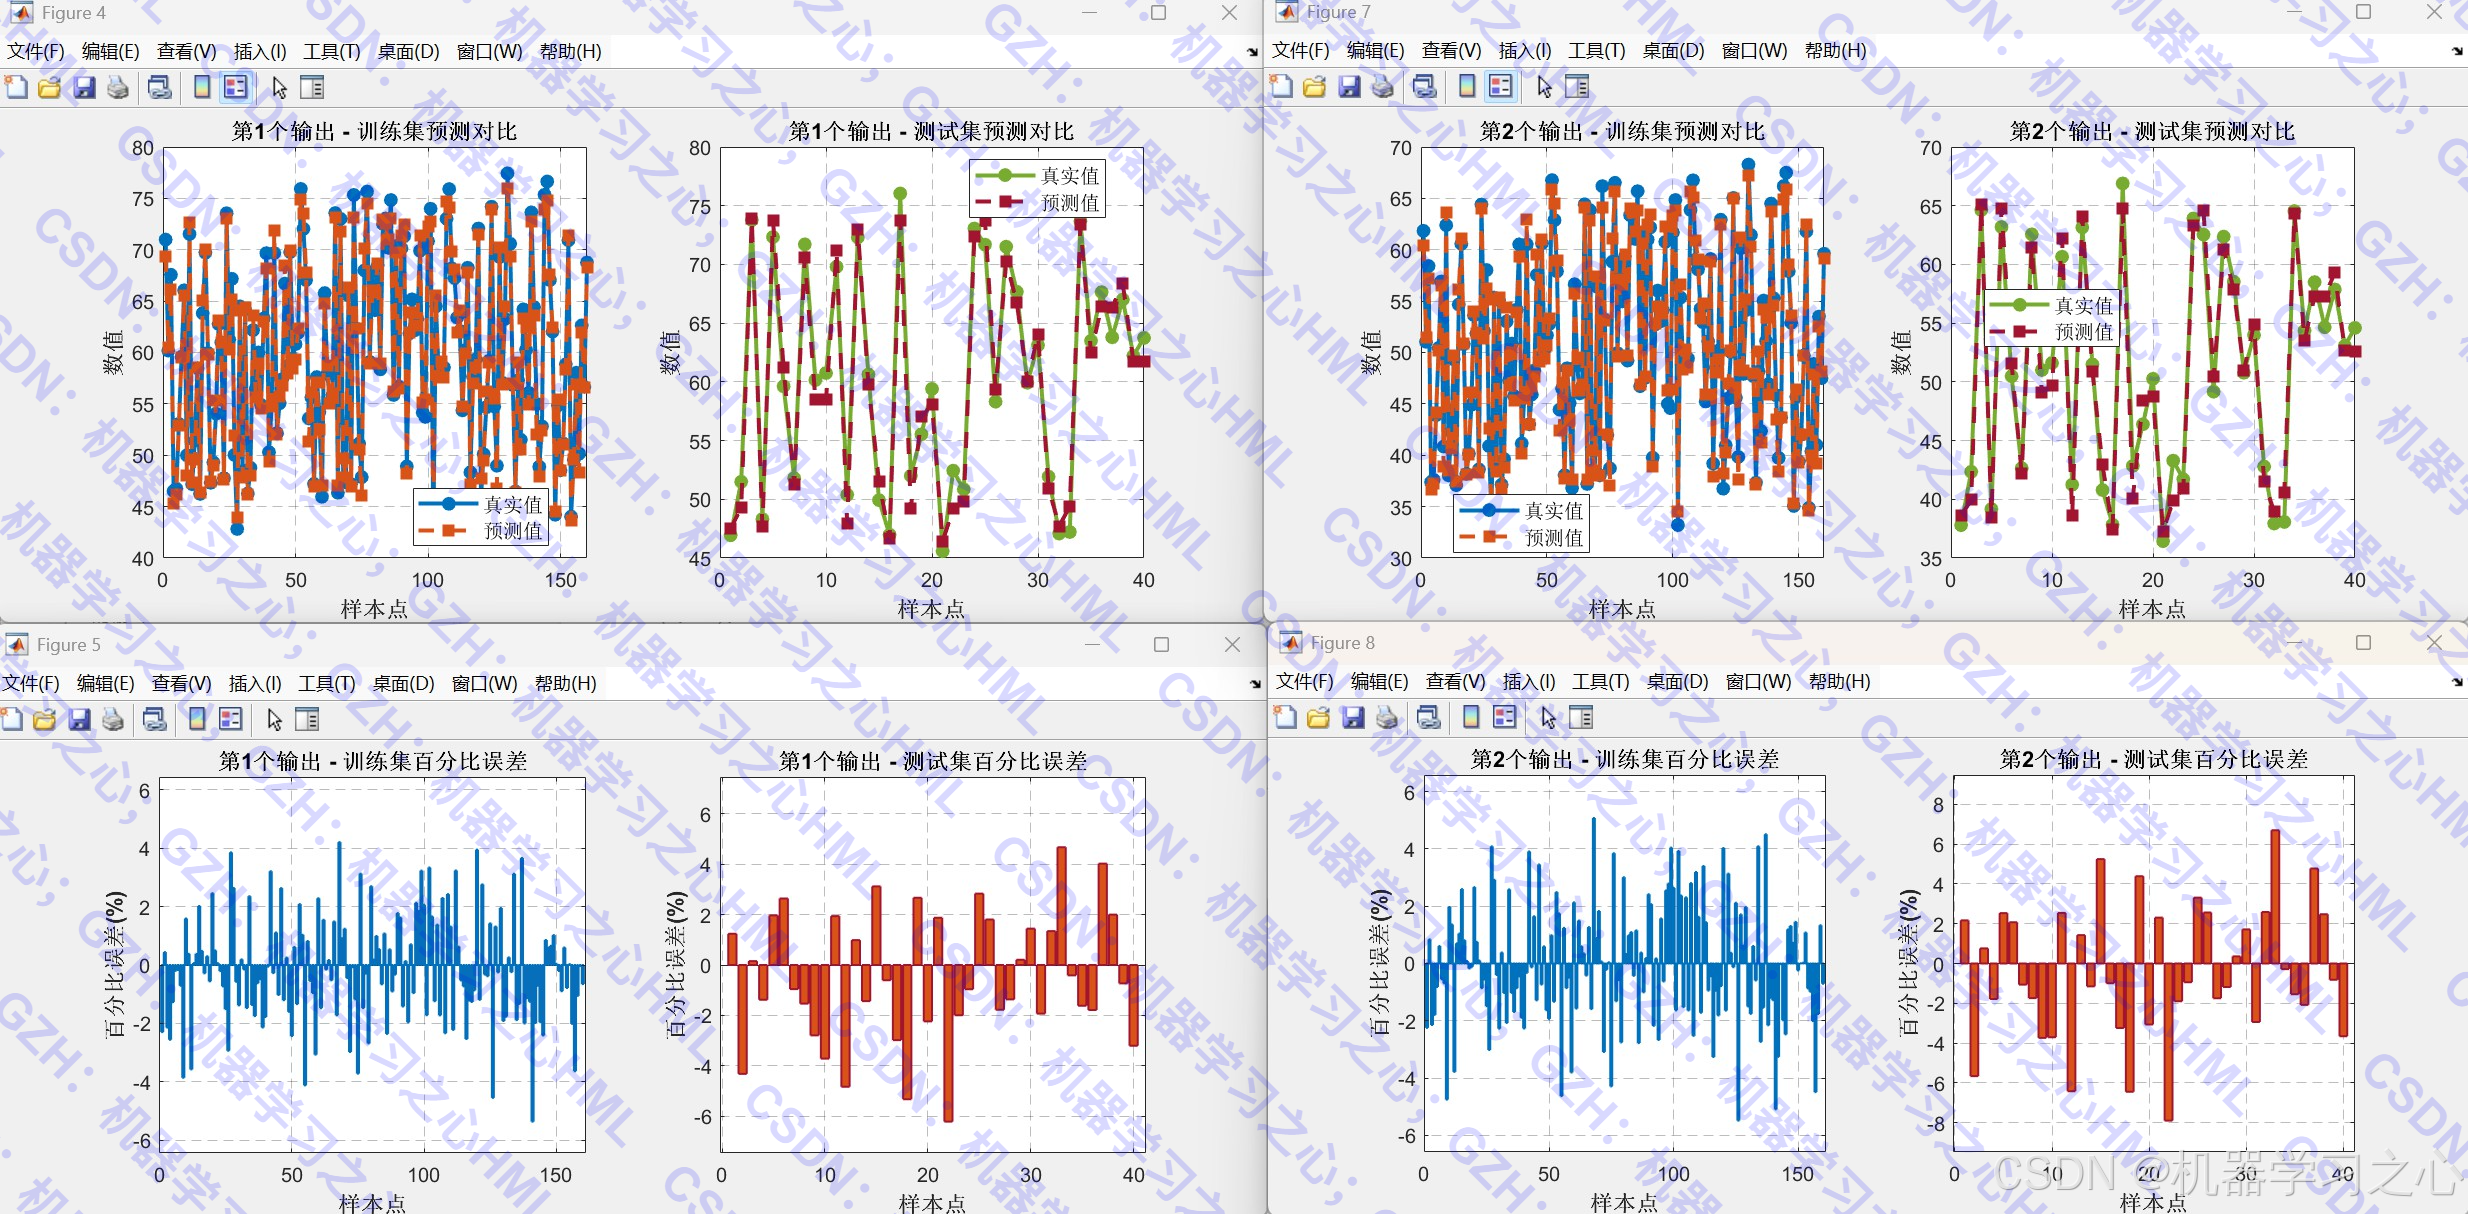
- 预测对比图(真实值 vs 预测值)
- 百分比误差图
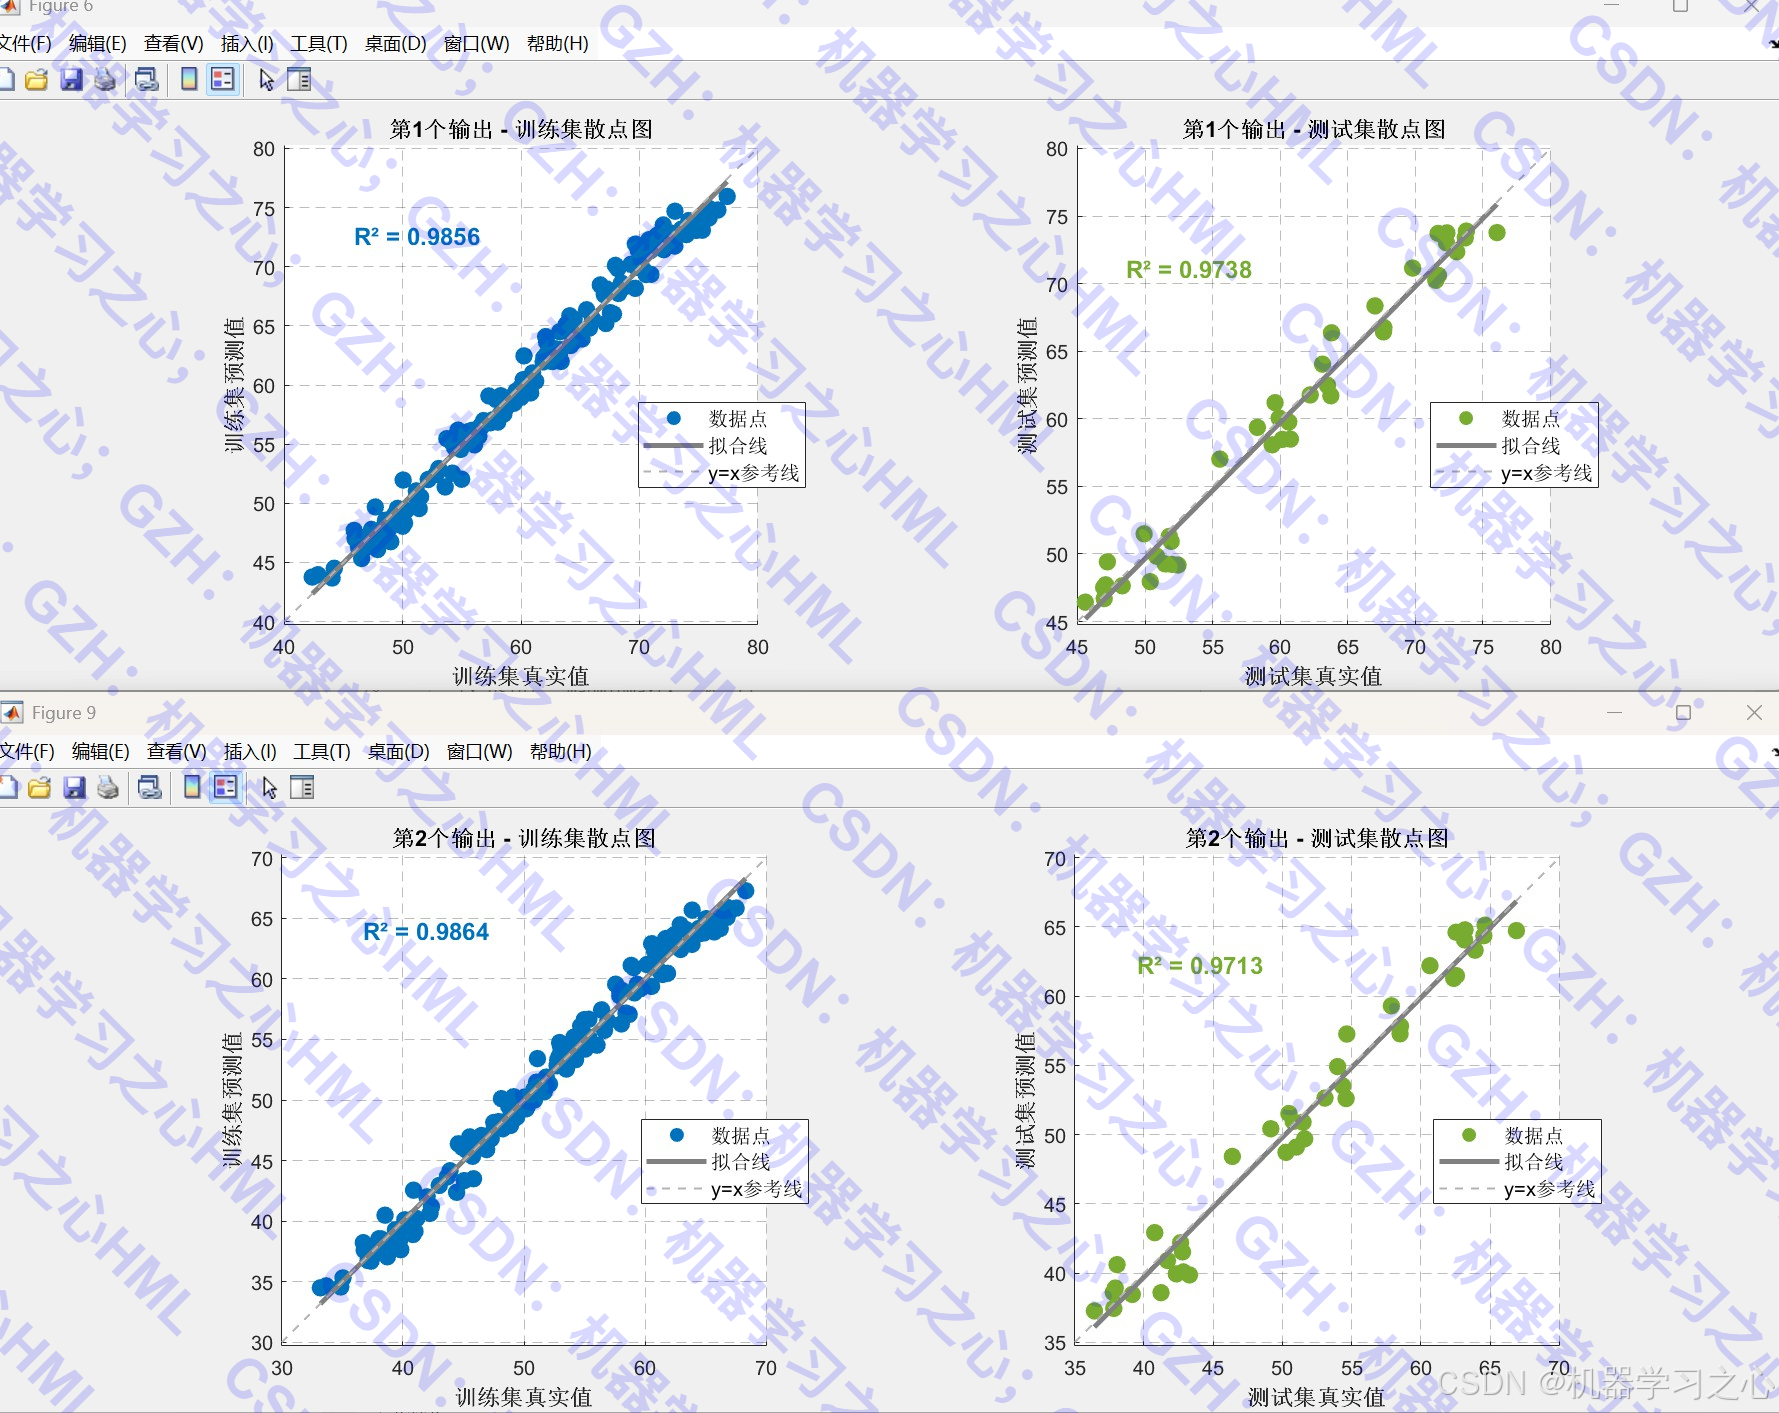
- 散点图与拟合线
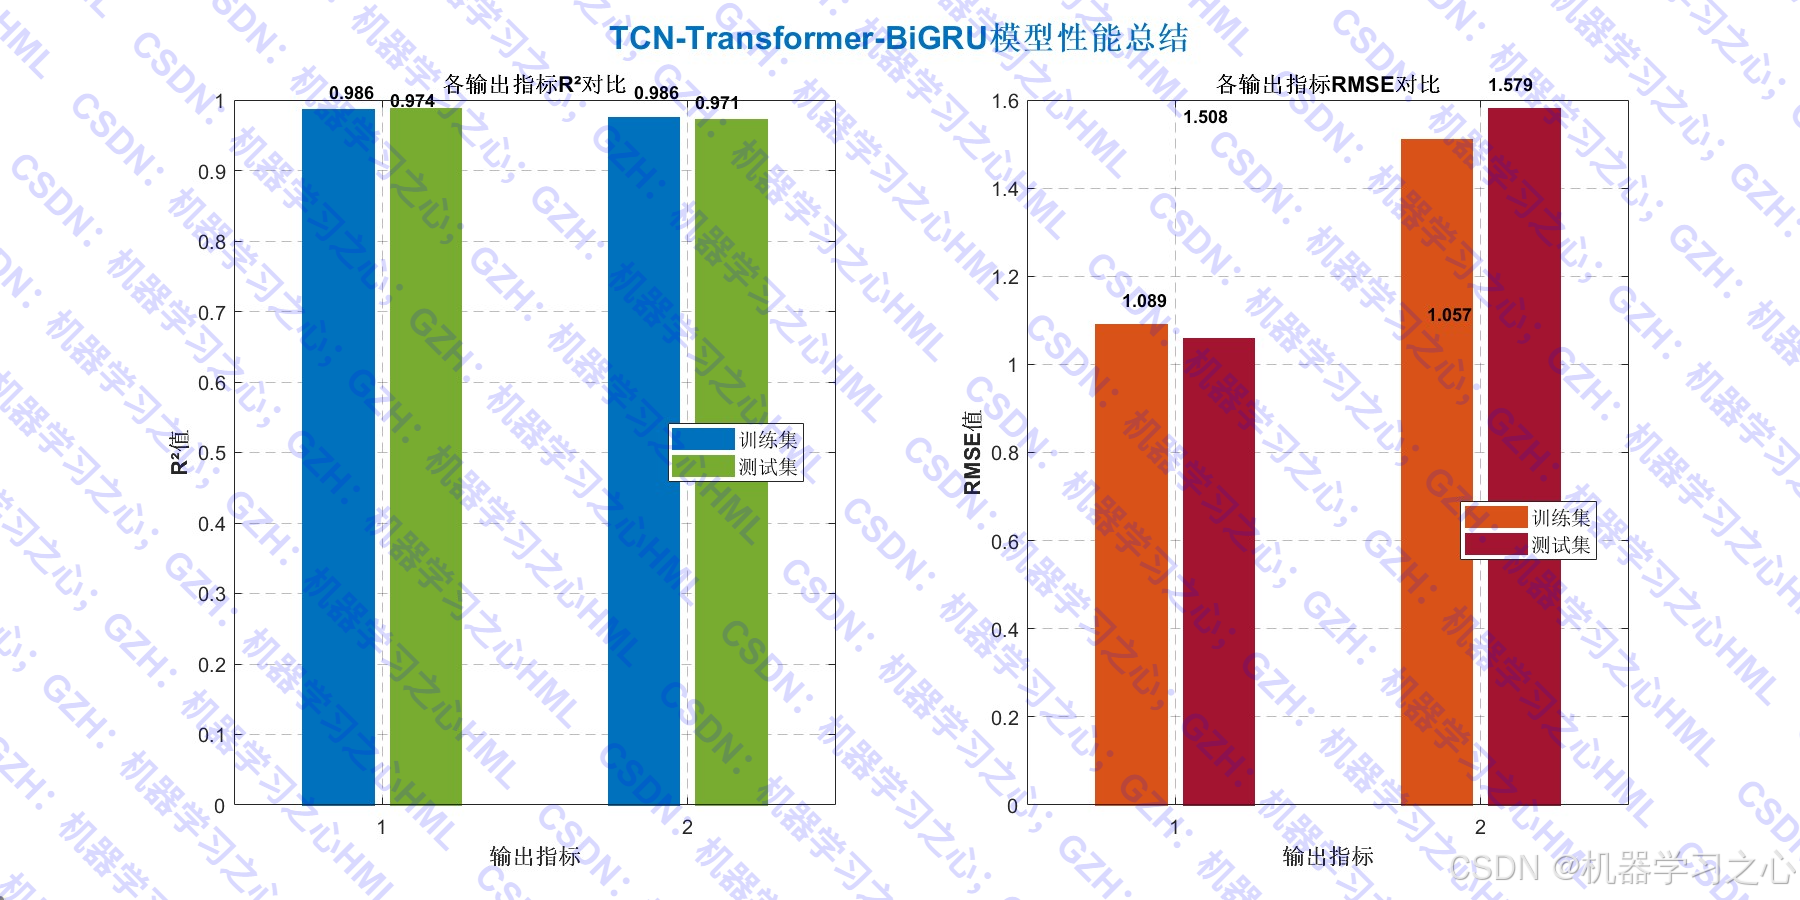
- 模型性能总结图(R² 和 RMSE 对比)
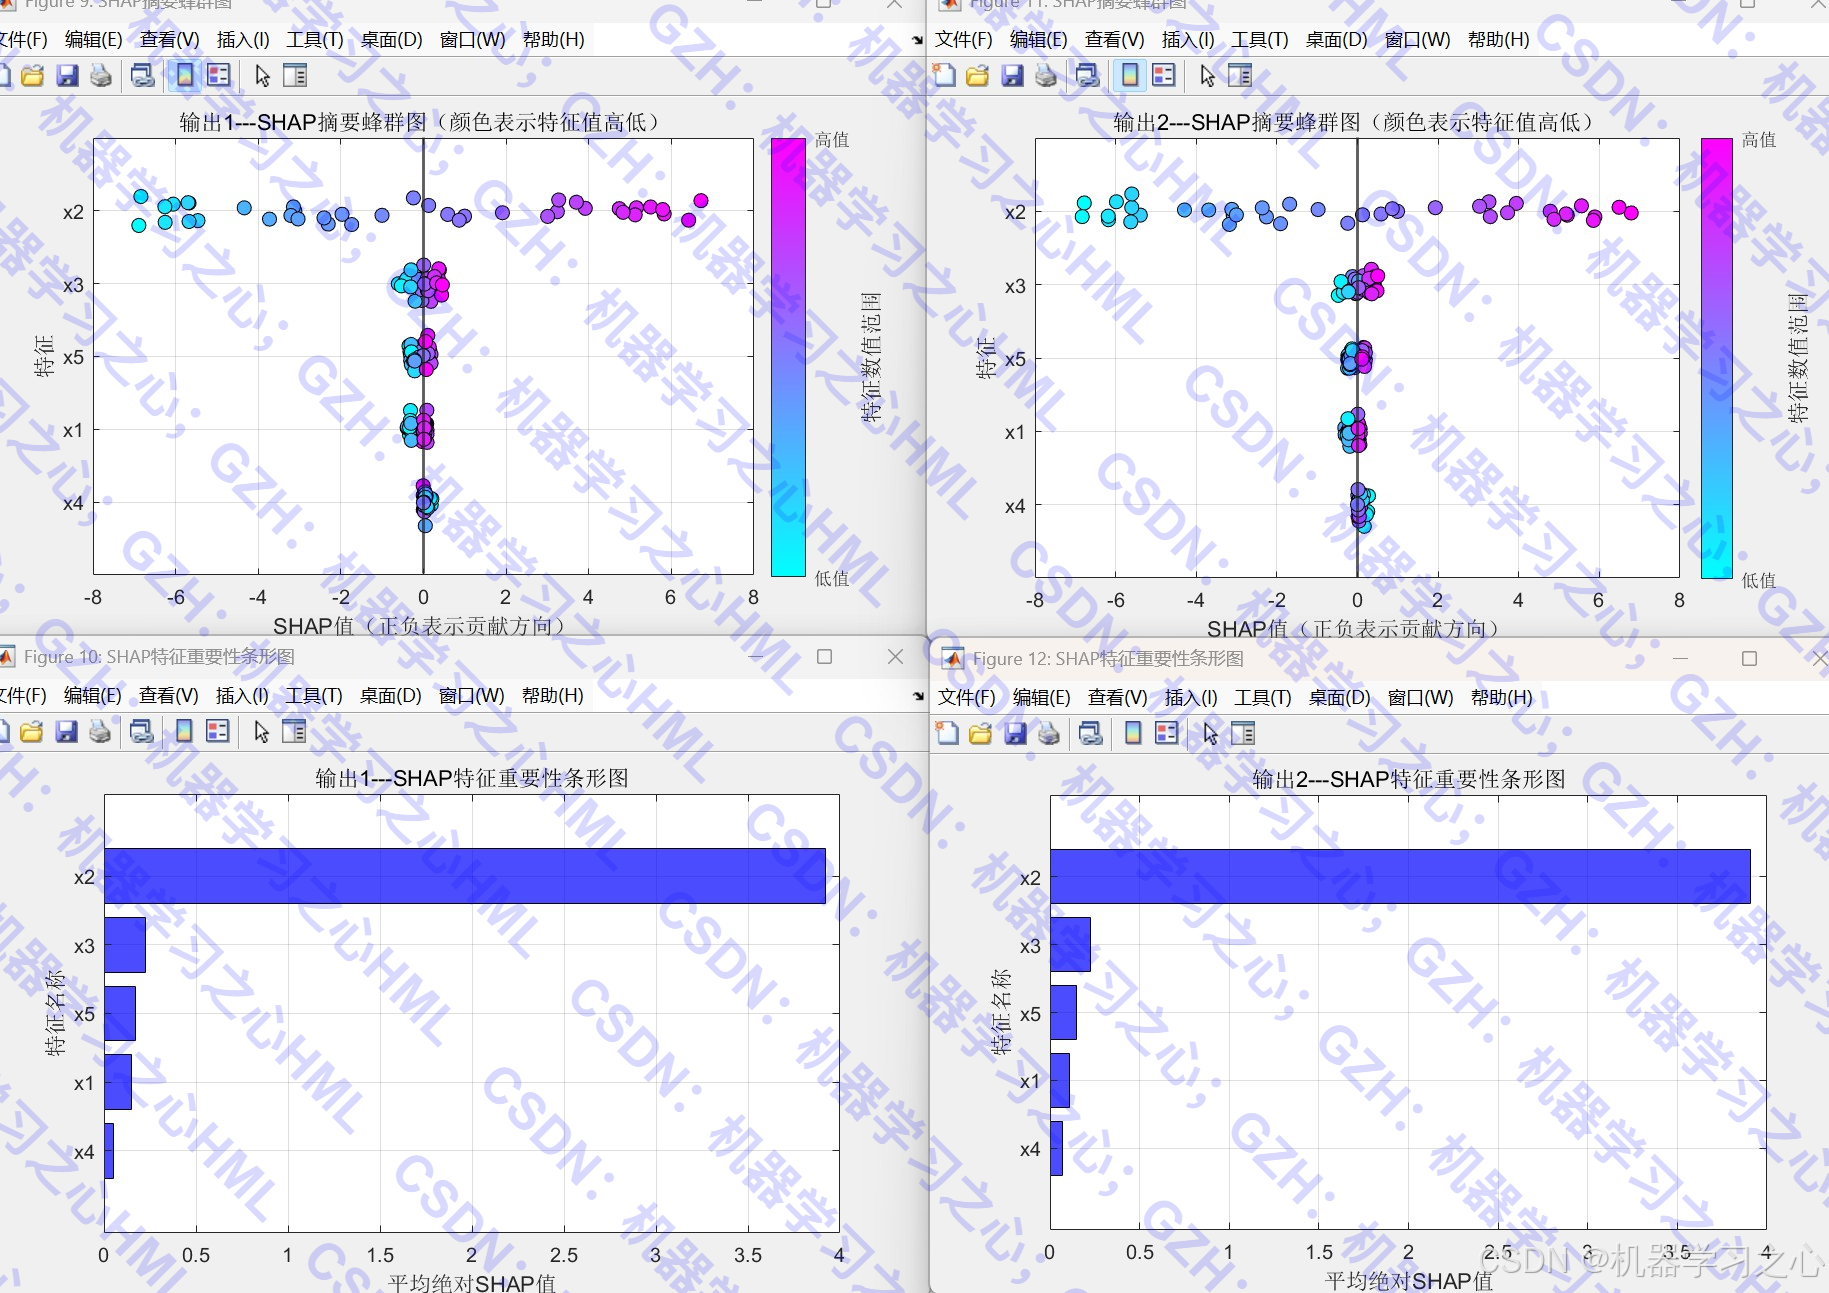
- 模型解释:使用 SHAP 值进行特征重要性分析。
- 新数据预测:加载新数据进行预测并保存结果。
三、算法步骤
- 数据导入与归一化 :使用
mapminmax将数据归一化到 0,1。 - 数据集划分:按比例(默认80%)划分训练集和测试集。
- 模型构建 :
- TCN 模块:多层级联卷积 + 残差连接
- Transformer 模块:位置编码 + 自注意力层
- BiGRU 模块:双向 GRU + 全连接输出层
- 模型训练:使用训练集进行监督学习。
- 预测与反归一化:对训练集和测试集进行预测,并反归一化。
- 评估与可视化:计算指标并绘制各类图表。
- SHAP 值计算:分析特征对输出的贡献度。
- 新数据预测:加载外部数据并进行预测输出。
四、技术路线
- 深度学习框架:MATLAB Deep Learning Toolbox
- 网络结构:TCN → Transformer → BiGRU → 全连接输出
- 优化算法:Adam + 学习率衰减策略
- 正则化方法:Dropout、Layer Normalization
- 评估指标:RMSE、MAE、R²
- 解释性方法:SHAP(Shapley Additive Explanations)
五、公式原理(核心部分)
-
TCN 膨胀卷积 :
yt=∑k=1Kwk⋅xt−d⋅(k−1) y_t = \sum_{k=1}^{K} w_k \cdot x_{t-d\cdot(k-1)} yt=k=1∑Kwk⋅xt−d⋅(k−1)其中 ddd 为膨胀因子,KKK 为卷积核大小。
-
自注意力机制 :
Attention(Q,K,V)=softmax(QKTdk)V \text{Attention}(Q,K,V) = \text{softmax}\left(\frac{QK^T}{\sqrt{d_k}}\right)V Attention(Q,K,V)=softmax(dk QKT)V -
GRU 更新门与重置门 :
zt=σ(Wz⋅ht−1,xt) z_t = \sigma(W_z \cdot h_{t-1}, x_t) zt=σ(Wz⋅ht−1,xt)
rt=σ(Wr⋅ht−1,xt) r_t = \sigma(W_r \cdot h_{t-1}, x_t) rt=σ(Wr⋅ht−1,xt)
h~t=tanh(W⋅rt⊙ht−1,xt) \tilde{h}t = \tanh(W \cdot r_t \\odot h_{t-1}, x_t) h~t=tanh(W⋅rt⊙ht−1,xt)
ht=(1−zt)⊙ht−1+zt⊙h~t h_t = (1 - z_t) \odot h{t-1} + z_t \odot \tilde{h}_t ht=(1−zt)⊙ht−1+zt⊙h~t
六、参数设定(关键参数)
| 参数 | 值/说明 |
|---|---|
| 输入特征数 | 5 |
| 输出目标数 | 2 |
TCN 层数 (numBlocks) |
3 |
卷积核大小 (filterSize) |
5 |
卷积核数量 (numFilters) |
32 |
Transformer 头数 (numHeads) |
4 |
BiGRU 隐藏单元数 (hiddens) |
6 |
训练轮数 (MaxEpochs) |
1000 |
| 初始学习率 | 1e-3 |
| 学习率衰减周期 | 800 |
训练集比例 (ratio) |
0.8 |
七、运行环境
- 平台:MATLAB(建议 R2021a 或以上版本)
- 工具箱 :
- Deep Learning Toolbox
- Parallel Computing Toolbox(可选,用于 GPU 加速)
- 硬件建议:支持 CPU 运行,GPU 可加速训练
- 数据格式 :Excel 文件(
.xlsx)
八、应用场景
该模型适用于多变量时序回归预测问题,例如:
- 电力负荷预测
- 气象预测(温度、湿度等)
- 交通流量预测
- 股票价格预测
- 工业生产参数预测
- 环境监测指标预测
总结
该代码实现了一个结构完整、功能丰富、可视化强大的深度学习回归预测系统,适用于需要高精度预测和模型可解释性的工程与科研场景。通过混合 TCN、Transformer 和 BiGRU 结构,该模型在时序建模中同时具备了局部特征提取、全局依赖建模和双向时序建模的能力。