官方网址
MSELoss
创建张量
inputs=torch.tensor([1,2,3],dtype=torch.float32)
targets=torch.tensor([1,2,5],dtype=torch.float32)
创建inputs和targets张量,其数值分别为1, 2, 3和1,2,5,数据类型为float32
形状变换
inputs=torch.reshape(inputs,(1,1,1,3))
targets=torch.reshape(targets,(1,1,1,3))
对inputs和targets进行形状变换,将原始形状(3,)变为(1, 1, 1, 3)
这样的变换通常在深度学习中用于处理需要4D输入的模型,如卷积神经网络 (CNN) 的输入格式
此处 的(1,1,1,3)
其中,1表示批次大小(batch size),1表示通道数,1表示高度(height),3表示宽度(width)

例如:
形状变换前的数据结构:
inputs: [1.0, 2.0, 3.0],形状 (3,)


形状变换后的数据结构:
inputs: [[[[1.0, 2.0, 3.0]]]],形状 (1, 1, 1, 3)
loss=L1Loss(reduction='sum')
result=loss(inputs,targets)
使用 PyTorch 中的 L1 损失函数(平均绝对误差损失),并通过 reduction='sum' 参数指定计算总和损失。然后,将 inputs 和 targets 传递给损失函数,计算它们之间的损失值。
loss_mse=nn.MSELoss()
result_mse=loss_mse(inputs,targets)
使用 PyTorch 中的均方误差损失函数(nn.MSELoss)计算了两个张量 inputs 和 targets 之间的均方误差(Mean Squared Error,MSE)。
解释具体步骤:
-
loss_mse=nn.MSELoss():创建了一个均方误差损失函数的实例,该实例被存储在变量loss_mse中。 -
result_mse=loss_mse(inputs,targets):使用创建的均方误差损失函数计算了inputs和targets之间的均方误差,并将结果存储在变量result_mse中。
均方误差是回归问题中常用的损失函数,它计算了预测值与真实值之间的差异的平方的均值。在这里,inputs 可能是模型的输出,而 targets 则是真实的标签或目标值。result_mse 中的数值表示了两个张量之间的均方误差,数值越小表示模型的预测越接近真实值。
输出结果
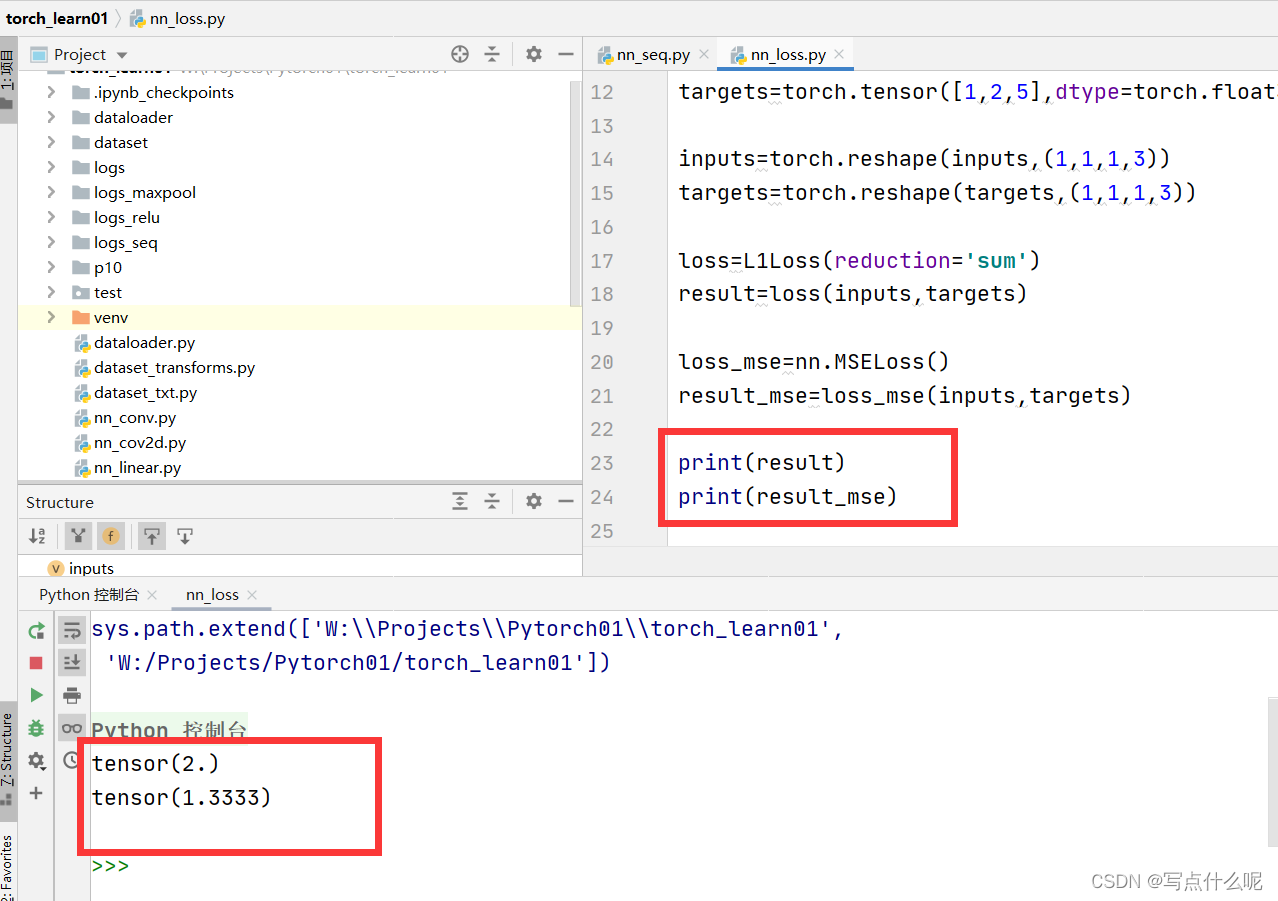
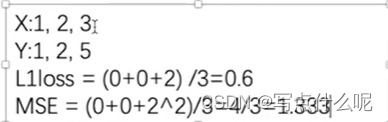
交叉熵
x=torch.tensor([0.1,0.2,0.3])
y=torch.tensor([1])
x=torch.reshape(x,(1,3))
loss_cross=nn.CrossEntropyLoss()
result_cross=loss_cross(x,y)
print(f"result_cross:{result_cross}")
这段代码使用 PyTorch 中的交叉熵损失函数(nn.CrossEntropyLoss)计算了两个张量 x 和 y 之间的交叉熵损失。
解释具体步骤:
-
x=torch.tensor([0.1,0.2,0.3]):定义了一个包含三个元素的张量x,这可能是模型的输出。 -
y=torch.tensor([1]):定义了一个包含一个元素的张量y,这可能是真实的类别标签。 -
x=torch.reshape(x,(1,3)):将张量x的形状调整为(1, 3),这是为了与交叉熵损失函数的要求相符。 -
loss_cross=nn.CrossEntropyLoss():创建了一个交叉熵损失函数的实例,该实例被存储在变量loss_cross中。 -
result_cross=loss_cross(x, y):使用创建的交叉熵损失函数计算了x和y之间的交叉熵损失,并将结果存储在变量result_cross中。
在交叉熵损失中,x 通常是模型的输出,表示各个类别的得分,而 y 是真实的类别标签。result_cross 中的数值表示了两个张量之间的交叉熵损失,数值越小表示模型的预测越接近真实类别。
import torch
from torch import nn
from torch.nn import L1Loss

inputs=torch.tensor([1,2,3],dtype=torch.float32)#张量,其数值为[1, 2, 3],数据类型为float32
targets=torch.tensor([1,2,5],dtype=torch.float32)

inputs=torch.reshape(inputs,(1,1,1,3))
targets=torch.reshape(targets,(1,1,1,3))

loss=L1Loss(reduction='sum')
result=loss(inputs,targets)

loss_mse=nn.MSELoss()
result_mse=loss_mse(inputs,targets)

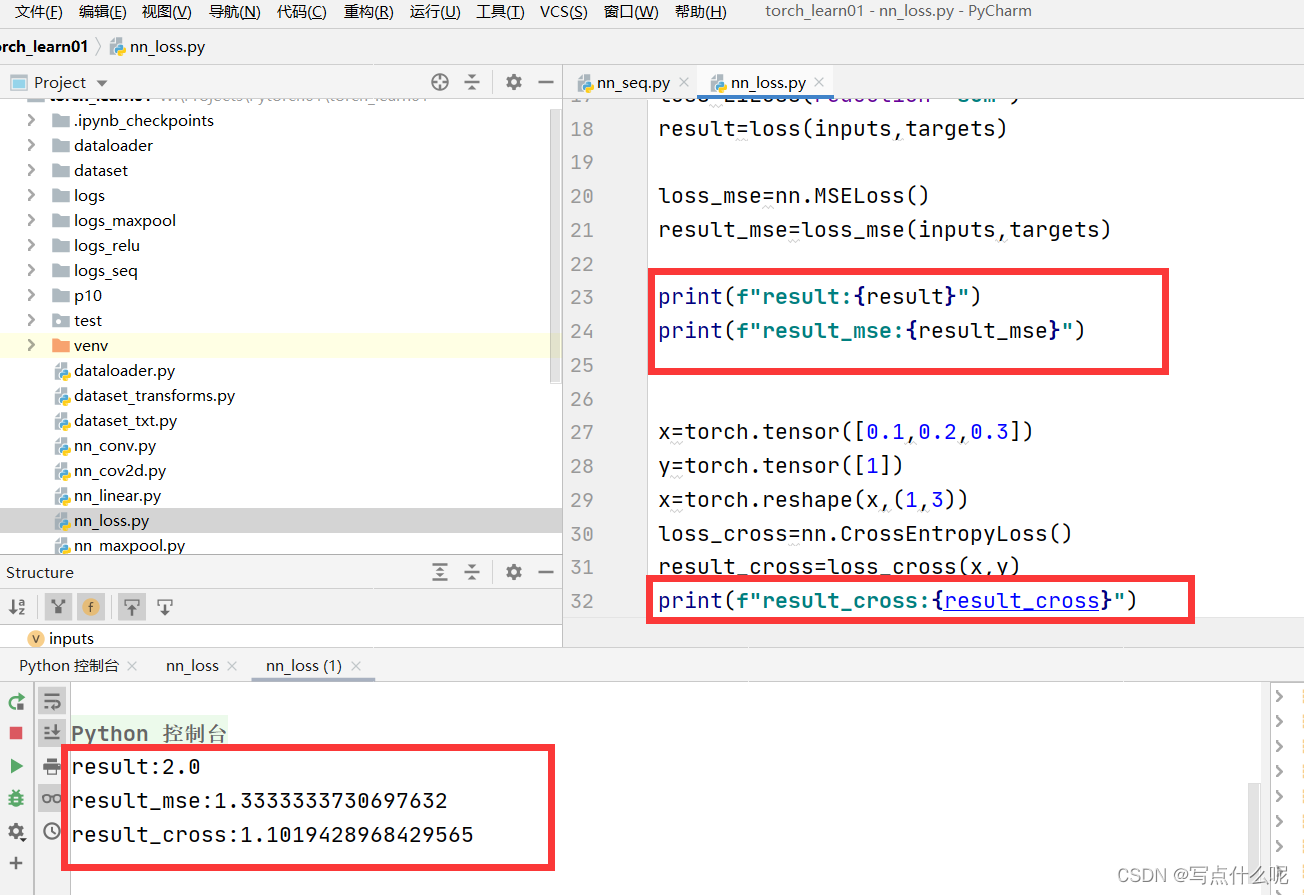
print(f"result:{result}")
print(f"result_mse:{result_mse}")


x=torch.tensor([0.1,0.2,0.3])
y=torch.tensor([1])
x=torch.reshape(x,(1,3))
loss_cross=nn.CrossEntropyLoss()
result_cross=loss_cross(x,y)
print(f"result_cross:{result_cross}")
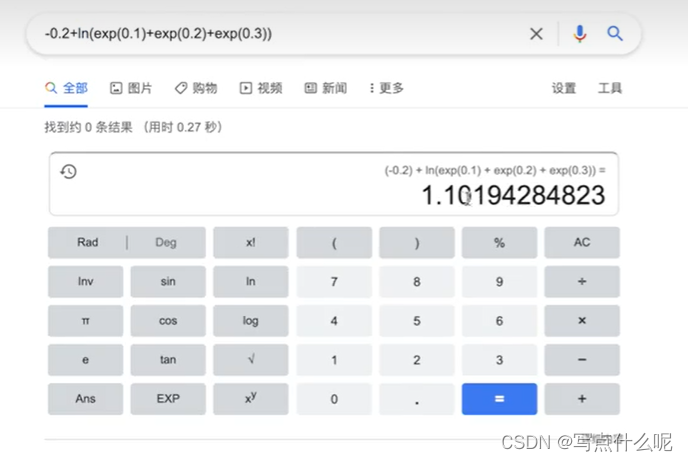
输出结果
dataset=torchvision.datasets.CIFAR10("./dataset",train=False,transform=torchvision.transforms.ToTensor(),download=True)

dataloader=DataLoader(batch_size=64)
加载 CIFAR-10 数据集并创建一个 DataLoader 对象,其中包含每个批次(batch)包含 64 个样本。
代码全文:
import torchvision
from torch import nn
from torch.nn import Sequential, Conv2d, MaxPool2d, Flatten, Linear
from torch.utils.data import DataLoader

dataset=torchvision.datasets.CIFAR10("./dataset",train=False,transform=torchvision.transforms.ToTensor(),
                                     download=True)

dataloader=DataLoader(dataset,batch_size=64)

class Xuex(nn.Module):
    def __init__(self):
        super(Xuex,self).__init__()
        self.model1=Sequential(
            Conv2d(3,32,5,padding=2),
            MaxPool2d(2),
            Conv2d(32, 32, 5, padding=2),
            MaxPool2d(2),
            Conv2d(32, 64, 5, padding=2),
            MaxPool2d(2),
            Flatten(),
            Linear(1024, 64),
            Linear(64, 10)
        )

    def forward(self,x):
        x=self.model1(x)
        return x
xuexu=Xuex()
for data in dataloader:
    imgs,targets=data
    outputs=xuexu(imgs)
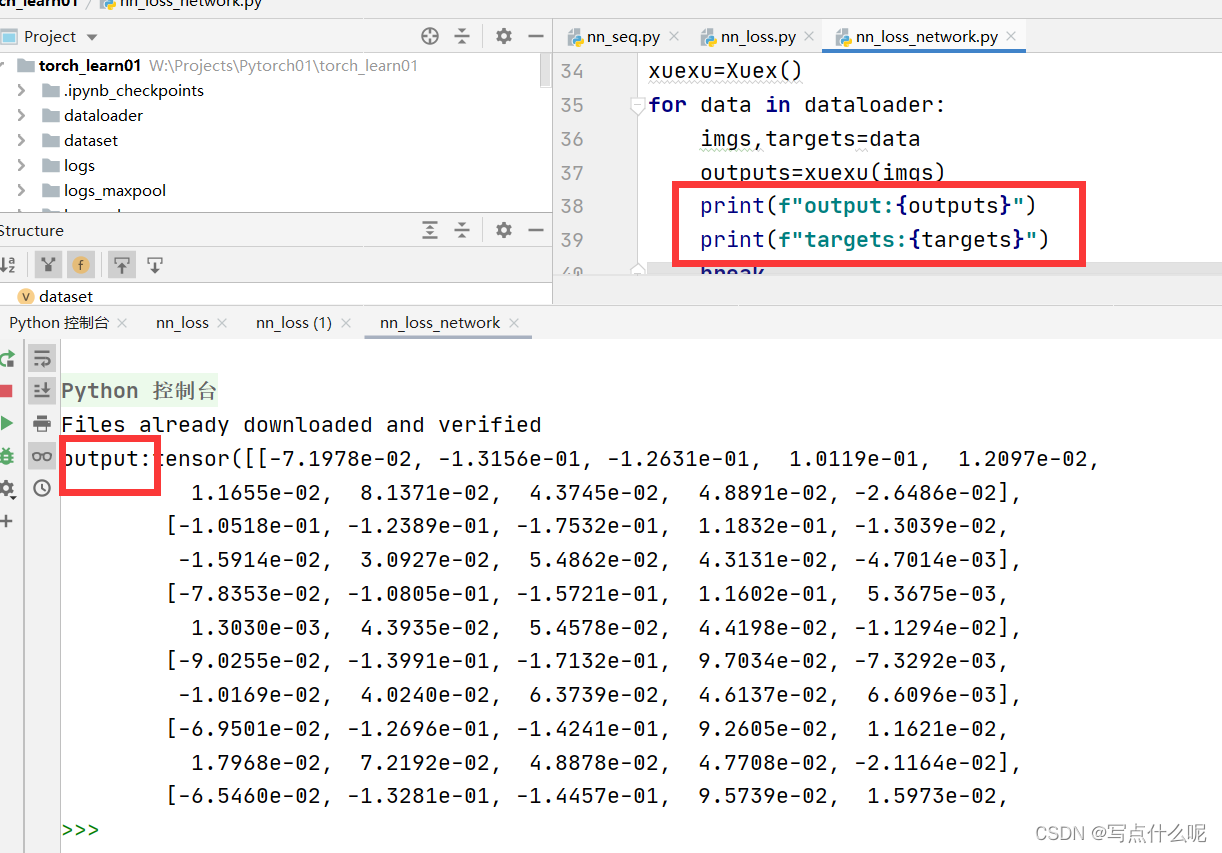
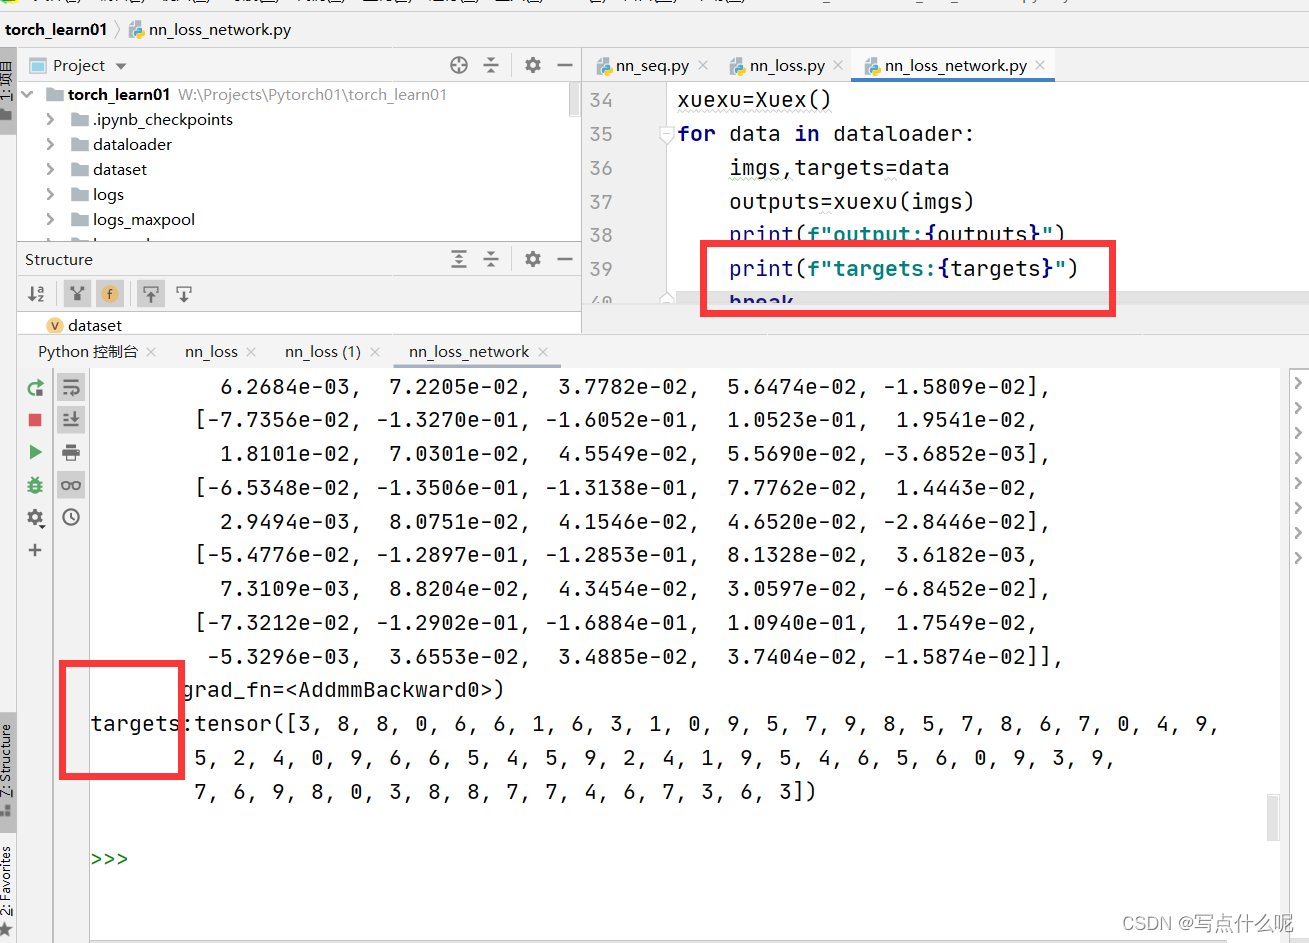
    print(f"output:{outputs}")
    print(f"targets:{targets}")
    break
输出结果
~
参考
【PyTorch深度学习快速入门教程(绝对通俗易懂!)【小土堆】】 https://www.bilibili.com/video/BV1hE411t7RN/?p=23\&share_source=copy_web\&vd_source=be33b1553b08cc7b94afdd6c8a50dc5a