文章目录
- 前言
- 一、项目准备与整体流程
- 概念介绍
- 项目准备
- 二、第一步:读取文本并分词(红楼梦关键字检索.py)
- [三、第二步:用 TF-IDF 提取关键词(红楼梦关键字提取.py)](#三、第二步:用 TF-IDF 提取关键词(红楼梦关键字提取.py))
- 核心步骤
- 四、运行结果示例
- 总结
前言
在信息爆炸的时代,快速从文本中抓取核心信息的能力非常重要。TF-IDF 是 NLP 领域最经典、也最容易上手的关键词提取算法之一。本文将带你从零开始,完成从文本读取、分词、去停用词,到使用 TF-IDF 提取每一回关键词的全过程,代码清晰易懂,有需要可直接运行。
一、项目准备与整体流程
概念介绍
TF-IDF(词频 - 逆文档频率)是一种统计方法,用来评估一个词在文本中的重要程度:
-
TF(词频):这个词在当前文本中出现的次数。出现越多,TF 越高。
-
IDF(逆文档频率):这个词在所有文本中出现的频率。出现的文本越少,IDF 越高。
-
TF-IDF 值 = TF × IDF:值越高,代表这个词对当前文本的区分度越大,越可能是关键词。
项目准备
首先,确保你已经安装了项目所需的 Python 库。打开终端执行以下命令:
c
pip install pandas jieba scikit-learn-
pandas:用于数据处理和表格操作
-
jieba:中文分词神器,专门处理中文文本
-
scikit-learn:提供 TF-IDF 算法的实现
为了让项目顺利运行,我们先把文件都准备好,放在同一个文件夹下:
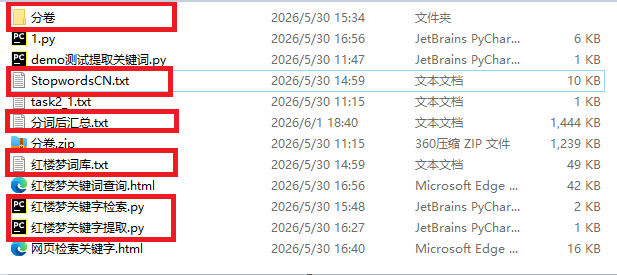
分卷,中存放着红楼梦所有章回
StopwordsCN,中存放着中文停用词表(比如"的、了、是"这类无意义词)
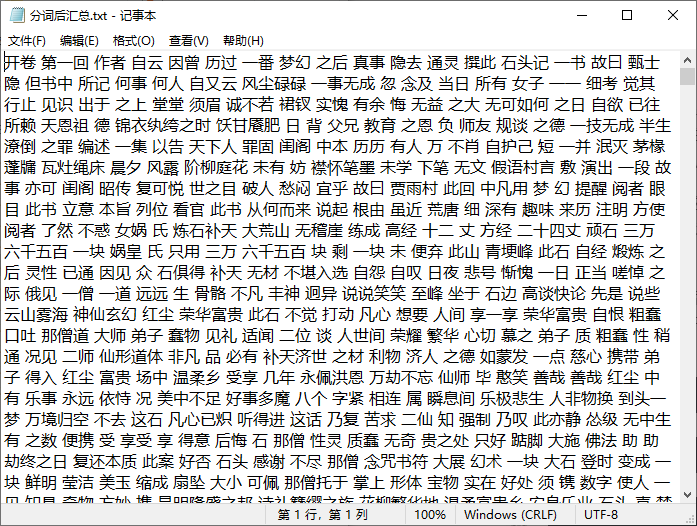
分词后汇总,用来保存分词后的文本
红楼梦词库,是自定义词库,帮助jieba更好地识别专有名词
二、第一步:读取文本并分词(红楼梦关键字检索.py)
这部分代码负责把分卷文件夹里的所有《红楼梦》文本读出来,用jieba分词,再去掉停用词,最后保存成一个干净的文本文件。
c
import pandas as pd
import os

# 1. 读取所有文件路径和内容
filePaths = []
fileContents = []
for root, dirs, files in os.walk('分卷'):
    for name in files:
        filePath = os.path.join(root, name)
        filePaths.append(filePath)
        # 打开文件并读取内容
        f = open(filePath, 'r', encoding='utf-8')
        fileContent = f.read()
        f.close()

        # 去掉第一行标题,只保留正文内容(根据你的文件格式调整)
        lines = fileContent.splitlines()
        fileContent = "\n".join(lines[1:])
        fileContents.append(fileContent)

# 2. 把文件路径和内容存入DataFrame,方便后续处理
corpos = pd.DataFrame({
    'filePaths': filePaths,
    'fileContents': fileContents
})
print("成功读取文件,共{}个文本".format(len(corpos)))

# 3. 加载自定义词库和停用词表
import jieba
jieba.load_userdict('红楼梦词库.txt')  # 告诉jieba《红楼梦》里的专有名词,比如"贾宝玉"
stopwords = pd.read_csv('StopwordsCN.txt', encoding='utf-8', engine='python', index_col=False)

# 4. 打开一个新文件,准备写入分词后的结果
file_to_jieba = open('分词后汇总.txt', 'w', encoding='utf-8')

# 5. 遍历每个文本,分词+去停用词
for index, row in corpos.iterrows():
    fileContents = row['fileContents']
    segs = jieba.cut(fileContents)  # 对文本进行分词
    jian_ci = ''
    for seg in segs:
        # 过滤掉停用词和空白字符
        if seg not in stopwords.stopword.values and len(seg.strip()) > 0:
            jian_ci += seg + ' '  # 用空格把分词结果连起来
    file_to_jieba.write(jian_ci + '\n')  # 每回文本占一行

file_to_jieba.close()
print("分词完成,结果已保存到'分词后汇总.txt'")-
批量读取文件:os.walk会自动遍历分卷文件夹里的所有.txt文件,把每个文件的路径和内容存起来。
-
清洗文本:lines1:去掉了文件的第一行标题,只保留正文内容。
-
加载词库:jieba.load_userdict可以让分词器识别《红楼梦》里的人名、地名等专有名词,避免把 "贾宝玉" 拆成 "贾""宝""玉"。
-
去停用词:像 "的、了、是、我、你" 这类高频但无实际意义的词,会被过滤掉,只保留有信息量的词。
-
保存结果:分词后的文本会被写成一行一个文本,方便后续 TF-IDF 读取。
三、第二步:用 TF-IDF 提取关键词(红楼梦关键字提取.py)
这部分代码会读取上一步生成的分词后汇总.txt,使用scikit-learn的TfidfVectorizer计算每个词的 TF-IDF 值,最后为每一回文本提取 TOP10 关键词。
c
from sklearn.feature_extraction.text import TfidfVectorizer
import pandas as pd

# 1. 读取分词后的文本数据
inFile = open(r'.\分词后汇总.txt', 'r', encoding='utf-8')
corpus = inFile.readlines()  # 每一行是一回文本
print("成功读取{}个文本".format(len(corpus)))

# 2. 初始化TF-IDF模型
vectorizer = TfidfVectorizer()
# 拟合数据并计算TF-IDF矩阵
tfidf = vectorizer.fit_transform(corpus)

# 3. 获取所有词的列表
wordlist = vectorizer.get_feature_names_out()

# 4. 把TF-IDF矩阵转换成DataFrame,方便查看和处理
df = pd.DataFrame(tfidf.T.todense(), index=wordlist)

# 5. 遍历每一回文本,提取TOP10关键词
for j in range(len(corpus)):
    # 获取当前文本中所有词的TF-IDF值
    featurelist = df.iloc[:, j].to_list()
    # 把词和对应的TF-IDF值存成字典
    resdict = {}
    for i in range(0, len(wordlist)):
        resdict[wordlist[i]] = featurelist[i]
    # 按TF-IDF值从高到低排序
    resdict = sorted(resdict.items(), key=lambda x: x[1], reverse=True)
    # 取前10个作为关键词
    top10 = resdict[:10]
    print("第{}回的TOP10关键词:".format(j+1))
    print(top10)
核心步骤
-
TfidfVectorizer():初始化 TF-IDF 模型,参数用默认值就可以,非常方便。
-
fit_transform(corpus):模型会学习所有文本的词频,并计算出每个词的 TF-IDF 值。
-
get_feature_names_out():获取所有出现过的词,作为后续排序的索引。
-
DataFrame(tfidf.T.todense()):把稀疏矩阵转成普通表格,方便我们查看和排序。
-
sorted(resdict.items(), key=lambda x: x1, reverse=True):按 TF-IDF 值从高到低排序,取前 10 个就是关键词啦。
四、运行结果示例
c
[('士隐', 0.44813777205112726), ('雨村', 0.1591461377160705), ('弟子', 0.13985916684686453), ('道人', 0.12699873793774877), ('那僧', 0.12237677099100645), ('英莲', 0.11173783977712862), ('那僧道', 0.10489437513514839), ('一段', 0.09793608474835107), ('封肃', 0.09311486648094051), ('空空道人', 0.09311486648094051)]
[('尤氏', 0.23866936440258454), ('鸳鸯', 0.2044460822953718), ('林之孝家的', 0.19750641940904387), ('奶奶', 0.17814015246070256), ('贾母', 0.15255642022708202), ('太妃', 0.13674765484916634), ('周瑞家的', 0.13557973470592935), ('喜鸾', 0.13151470995577685), ('南安', 0.13079210176877828), ('司棋', 0.11527013414232981)]
[('宝玉', 0.34342932566889794), ('晴雯', 0.3135073747865914), ('王夫人', 0.21705862584865596), ('司棋', 0.210447634912385), ('周瑞家的', 0.1980213502705289), ('袭人', 0.16147604616317685), ('太太', 0.1350587005280526), ('芳官', 0.10757495210650907), ('迎春', 0.10055457383772931), ('干娘', 0.08199748579817936)]
可以看到,提取出的关键词基本都能对应上每一回的核心人物和事件,同时还输出了每个关键字的权重,权重越接近1,代表越重要。
总结
代码运行中我们需要注意检查文件路径是否正确,特别是分卷文件夹、红楼梦词库.txt和StopwordsCN.txt是否和代码在同一个文件夹,同时确保所有文件都是 UTF-8 编码,特别是停用词表和自定义词库。