45多尺度目标检测
python
# 多尺度锚框
"""
减少图像上的锚框数量并不困难。 比如,我们可以在输入图像中均匀采样一小部分像素,
并以它们为中心生成锚框。 此外,在不同尺度下,我们可以生成不同数量和不同大小的锚框。
直观地说,比起较大的目标,较小的目标在图像上出现的可能性更多样。
例如,1*1,1*2,2*2的目标可以分别以4、2和1种可能的方式出现在2*2
图像上。 因此,当使用较小的锚框检测较小的物体时,我们可以采样更多的区域,
而对于较大的物体,我们可以采样较少的区域。
"""
import torch
from PIL import Image
import matplotlib.pylab as plt
from d2l import torch as d2l

plt.figure('catdog')
img = plt.imread('../limuPytorch/images/catdog.jpg')
# # plt.imshow(img)
# print(img.shape) # (561, 728, 3)
# 获取图像的高度和宽度,忽略通道数
h, w = img.shape[:2]

# 定义一个显示锚框(anchors)的函数
def display_anchors(fmap_w, fmap_h, s):
    # 设置图像的显示大小
    d2l.set_figsize()
    # 创建一个零张量,形状为(1, 10, fmap_h, fmap_w),前两个维度不影响输出
    fmap = torch.zeros((1, 10, fmap_h, fmap_w))
    # 生成多尺度的锚框,sizes参数为s,ratios参数为[1, 2, 0.5]
    anchors = d2l.multibox_prior(fmap, sizes=s, ratios=[1, 2, 0.5])
    """
    sizes=s:指定了锚框的尺寸,这里传入的是一个列表 s。
    例如,在代码的调用中 s=[0.15]、s=[0.4]、s=[0.8]。
    这些值表示锚框相对于图像尺寸的比例
    ratios=[1, 2, 0.5]:指定了锚框的长宽比,分别是 1(即正方形),
    2(即宽高比为2的矩形),以及 0.5(即宽高比为0.5的矩形)。
    """
    # 将图像宽高转化为张量,用于尺度转换
    bbox_scale = torch.tensor((w, h, w, h))

    # 显示图像上的锚框,使用工具库d2l的show_bboxes函数
    # 显示图像,获取axes,anchors乘以bbox_scale进行尺度转换
    d2l.show_bboxes(d2l.plt.imshow(img).axes, anchors[0] * bbox_scale)

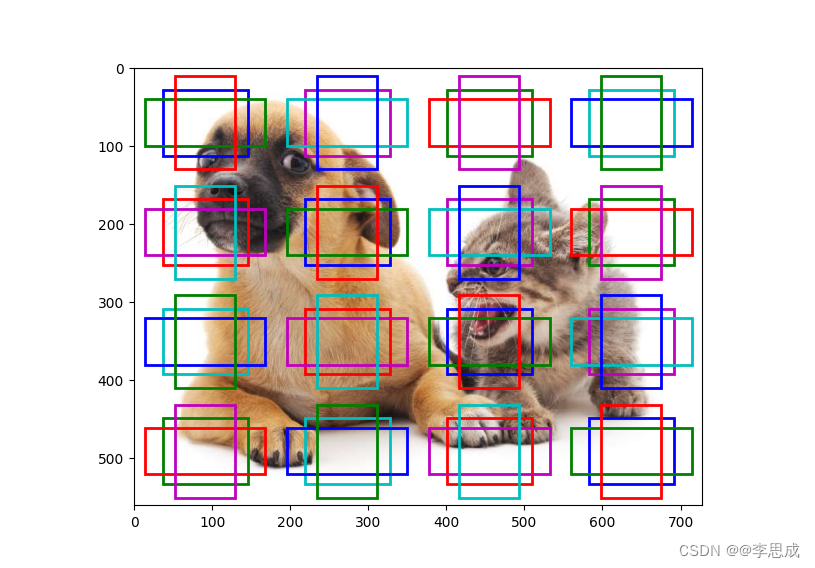
# 调用display_anchors函数,特征图大小为4x4,锚框尺度为0.15
display_anchors(fmap_w=4, fmap_h=4, s=[0.15])
# 显示图像
plt.show()

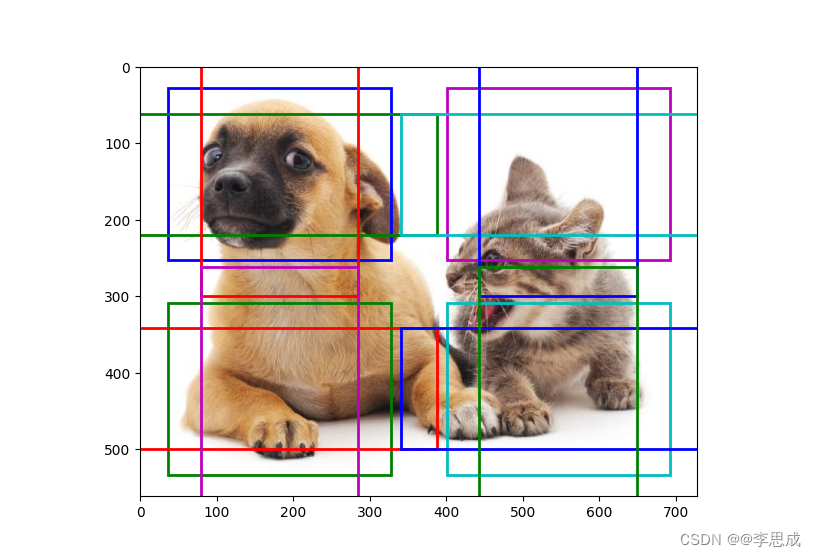
# 调用display_anchors函数,特征图大小为2x2,锚框尺度为0.4
display_anchors(fmap_w=2, fmap_h=2, s=[0.4])
# 显示图像
plt.show()

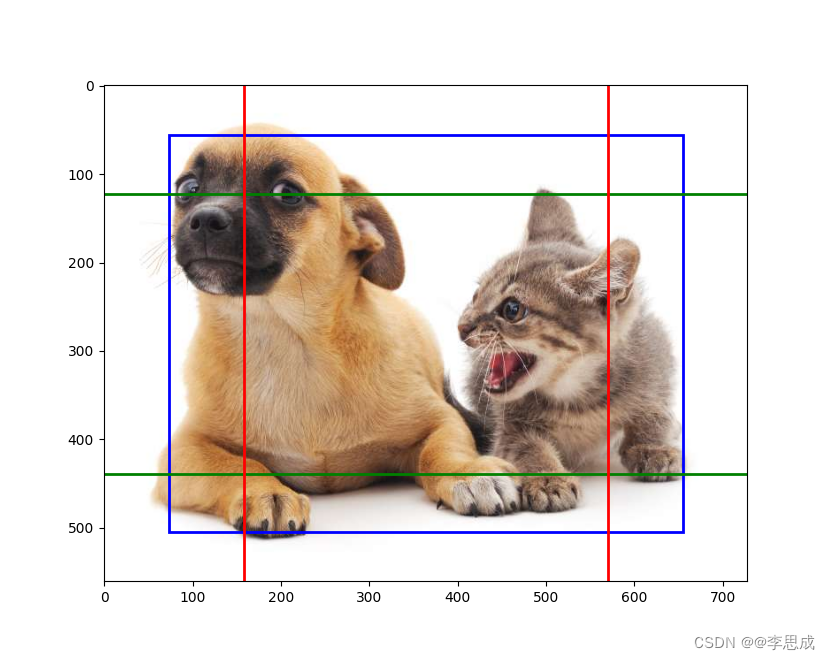
# 调用display_anchors函数,特征图大小为1x1,锚框尺度为0.8
display_anchors(fmap_w=1, fmap_h=1, s=[0.8])
# 显示图像
plt.show()
运行结果: