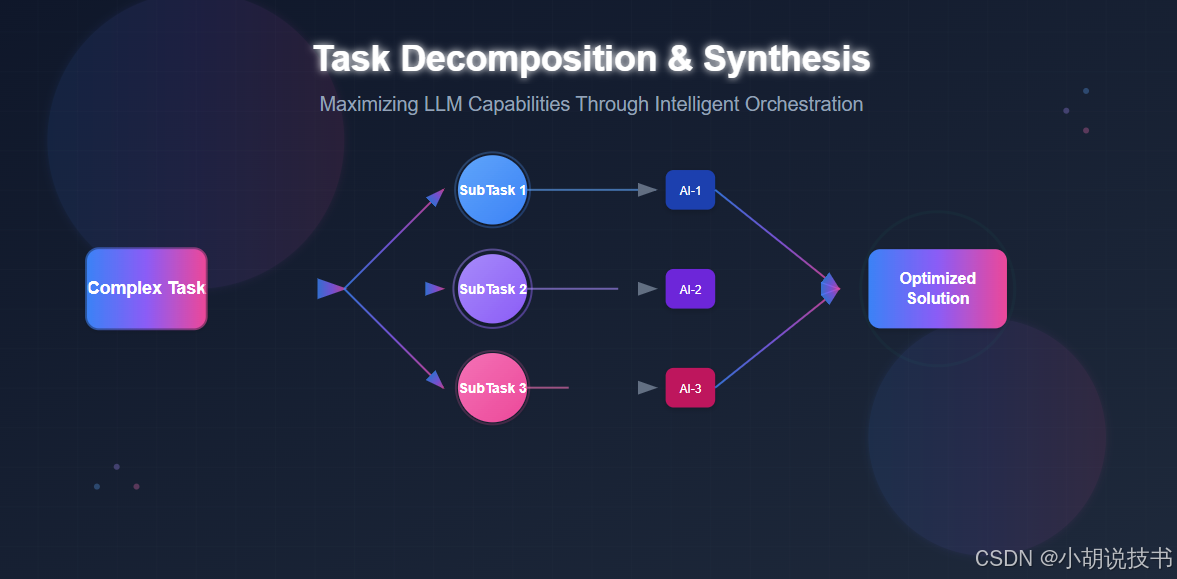
一、缘起:为什么大模型需要"分而治之"
1.1 从一个真实场景说起
设想这样一个场景:你要求GPT-4帮你完成一份包含市场调研、竞品分析、财务预测和战略规划的商业计划书。即使是最先进的大模型,面对这样的复杂任务也会"力不从心"。这并非模型能力不足,而是触及了当前大语言模型的根本性限制。
这种现象背后,反映的是认知架构 与计算架构之间的深层矛盾。人类处理复杂问题时,会自然地将其分解为多个子问题,这种能力源于我们的认知结构。而大模型虽然在某些方面已经接近甚至超越人类,但在任务组织和规划能力上仍存在明显短板。
1.2 大模型的"阿喀琉斯之踵"
上下文窗口限制
上下文窗口(Context Window):指大模型在单次推理中能够处理的最大文本长度,通常以令牌(Token)数量计算。
当前主流大模型的上下文窗口限制:
- GPT-4:128K tokens(约10万字)
- Claude 3:200K tokens(约15万字)
- Gemini 1.5:1M tokens(约75万字)
看似庞大的数字,但在处理真实世界的复杂任务时,这些限制很快就会成为瓶颈。一份完整的企业年报、一个大型软件项目的代码库,都可能轻易超过这些限制。
注意力机制的计算复杂度
注意力机制(Attention Mechanism):Transformer架构的核心组件,允许模型在处理序列时关注不同位置的信息。
注意力机制的计算复杂度是O(n²),这意味着处理长度翻倍的文本,计算量会增加四倍。这种二次方增长使得无限扩展上下文窗口在经济上不可行。
推理链断裂问题
大模型在处理复杂多步骤任务时,容易出现"推理链断裂"------前面的推理结果无法有效传递到后续步骤,导致逻辑不连贯或遗忘关键信息。这类似于人类在心算复杂数学题时的困境。
二、理论基础:从认知科学到计算理论
2.1 认知科学的启示
Miller的魔法数字与工作记忆
心理学家George Miller在1956年提出的"7±2法则"揭示了人类工作记忆的容量限制。这一发现对理解大模型的局限性具有重要启示:
| 认知系统 | 容量限制 | 持续时间 | 处理方式 |
|---|---|---|---|
| 人类工作记忆 | 7±2个信息块 | 15-30秒 | 通过组块和编码扩展 |
| 大模型上下文 | 固定token数 | 单次推理周期 | 通过分解和链接扩展 |
问题解决的认知模型
Herbert Simon的 通用问题解决器(GPS) 提出了三个核心概念:
- 问题空间:所有可能状态的集合
- 操作符:改变状态的动作
- 手段-目标分析:通过设置子目标缩小当前状态与目标状态的差距
这一模型直接启发了现代任务分解方法的设计。当我们让大模型"逐步思考"时,实际上是在模拟人类的手段-目标分析过程。
2.2 分布式认知理论的应用
认知不仅存在于"头脑"中
Edwin Hutchins的分布式认知理论告诉我们,复杂的认知活动往往分布在多个主体和工具之间。航海导航不是由单个人完成的,而是由船长、领航员、海图、罗盘等共同构成的认知系统完成的。
这一理论为多智能体系统提供了理论基础:
- 单个大模型 → 多个专门化模型
- 集中式处理 → 分布式协作
- 静态能力 → 动态组合
认知负荷理论的实践意义
John Sweller的认知负荷理论区分了三种负荷类型,这对设计任务分解策略具有直接指导意义:
| 负荷类型 | 定义 | 在LLM中的体现 | 优化策略 |
|---|---|---|---|
| 内在负荷 | 任务本身的复杂性 | 问题的固有难度 | 无法减少,只能分解 |
| 外在负荷 | 不当设计造成的负担 | 冗余信息、模糊指令 | 优化提示词设计 |
| 相关负荷 | 有益的认知处理 | 推理步骤、知识整合 | 适度增加以提升质量 |
三、核心方法论:任务分解的技术路径
3.1 思维链(Chain-of-Thought):让推理过程显性化
方法本质
思维链不仅仅是"让模型一步步思考"那么简单。其深层机制是通过将隐式推理转化为显式文本,使得:
- 中间结果得以保存和传递
- 推理过程可被检验和纠正
- 复杂问题被自然分解为步骤
实施要点与效果
| 实施方式 | 触发方法 | 适用场景 | 性能提升 |
|---|---|---|---|
| 零样本CoT | "让我们逐步思考" | 通用推理任务 | 10-30% |
| 少样本CoT | 提供推理示例 | 特定领域问题 | 30-50% |
| 自动CoT | 算法生成示例 | 大规模应用 | 20-40% |
局限性分析
思维链方法存在几个关键局限:
- 线性思维束缚:只能沿着单一路径推理
- 错误累积:早期错误会传播到后续步骤
- 计算开销:生成详细推理步骤增加了token消耗
3.2 思维树(Tree-of-Thoughts):探索多重可能性
从链到树的演进
思维树方法引入了搜索 和评估机制,使得模型能够:
- 生成多个候选思路
- 评估每条路径的前景
- 必要时回溯和重新选择
技术实现的关键组件
| 组件 | 功能 | 实现方式 | 挑战 |
|---|---|---|---|
| 思维生成器 | 产生候选方案 | 采样/提议 | 多样性vs相关性平衡 |
| 状态评估器 | 判断思路质量 | 价值函数/投票 | 评估标准的设计 |
| 搜索算法 | 导航解空间 | BFS/DFS/束搜索 | 效率vs完备性权衡 |
实践效果
在"24点游戏"这类需要探索的任务中,ToT将成功率从4%提升到74%,这种巨大提升来源于:
- 避免了过早承诺于错误路径
- 能够比较不同方案的优劣
- 支持策略性的前瞻规划
3.3 分解式提示(Decomposed Prompting):模块化的力量
设计理念
分解式提示的核心思想是关注点分离:
- 不同类型的子任务由不同的处理器处理
- 每个处理器针对特定任务类型优化
- 通过标准接口实现处理器间协作
处理器类型与选择策略
| 处理器类型 | 适用任务 | 优势 | 实例 |
|---|---|---|---|
| 符号处理器 | 确定性计算 | 100%准确 | 字符串操作、数学运算 |
| 神经处理器 | 模糊推理 | 灵活适应 | 语义理解、创意生成 |
| 混合处理器 | 结构化推理 | 平衡准确性与灵活性 | 代码生成、逻辑推理 |
四、多智能体协作:从单打独斗到团队作战
4.1 为什么需要多智能体系统
专业化分工的必然性
就像人类社会的专业分工带来效率提升,让不同的模型专注于不同类型的任务,可以:
- 提高单项任务性能:专门训练的模型表现更好
- 降低整体成本:小模型组合比大模型更经济
- 增强系统灵活性:可按需组合不同能力
协同效应的产生机制
多智能体协作不是简单的"1+1=2",而是通过以下机制产生协同效应:
| 协同机制 | 作用原理 | 效果体现 |
|---|---|---|
| 互补性 | 不同模型擅长不同任务 | 覆盖更广的能力范围 |
| 冗余性 | 多个模型验证同一结果 | 提高可靠性和准确性 |
| 涌现性 | 交互产生新的能力 | 解决单一模型无法处理的问题 |
4.2 主流多智能体框架对比
框架选择的考量维度
| 框架 | 核心理念 | 适用场景 | 学习曲线 | 生产就绪度 |
|---|---|---|---|---|
| LangGraph | 状态图编排 | 复杂工作流 | 陡峭 | 高 |
| AutoGen | 对话驱动 | 协作任务 | 平缓 | 中 |
| CrewAI | 角色扮演 | 模拟团队 | 平缓 | 中 |
| Semantic Kernel | 企业集成 | 大规模部署 | 陡峭 | 高 |
架构模式的演进
-
网状架构:所有代理平等通信
- 优点:灵活、去中心化
- 缺点:协调困难、通信开销大
-
层级架构:监督者协调下属
- 优点:清晰的控制流、易于管理
- 缺点:监督者成为瓶颈
-
混合架构:结合两者优势
- 优点:兼顾灵活性和可控性
- 缺点:设计和实现复杂
4.3 协作模式的设计原则
通信协议设计
有效的代理间通信需要考虑:
| 设计要素 | 考虑因素 | 最佳实践 |
|---|---|---|
| 消息格式 | 结构化vs自然语言 | 使用JSON-LD等语义化格式 |
| 交互模式 | 同步vs异步 | 根据任务时效性选择 |
| 错误处理 | 重试vs降级 | 实现渐进式降级策略 |
状态管理策略
多智能体系统的状态管理是确保协作coherence的关键:
- 共享内存模式:所有代理访问同一状态存储
- 消息传递模式:状态通过消息在代理间流转
- 事件溯源模式:通过事件日志重建任意时刻状态
五、结果汇总与质量保证
5.1 汇总策略的选择逻辑
基于任务特性的策略匹配
| 任务特性 | 推荐策略 | 原因分析 | 注意事项 |
|---|---|---|---|
| 顺序依赖 | 链式汇总 | 保持逻辑连贯性 | 错误传播风险 |
| 并行独立 | 并行聚合 | 提高处理效率 | 结果一致性挑战 |
| 层次结构 | 递归汇总 | 自然映射问题结构 | 深度控制 |
| 相互验证 | 交叉验证 | 提高结果可靠性 | 计算成本增加 |
质量控制机制
多层次验证体系:
- 语法层:检查格式、结构正确性
- 语义层:验证内容逻辑一致性
- 语用层:确保满足实际需求
5.2 冲突解决与共识形成
冲突类型与解决策略
| 冲突类型 | 表现形式 | 解决策略 | 实施要点 |
|---|---|---|---|
| 事实冲突 | 不同代理给出矛盾信息 | 源头验证、可信度加权 | 建立事实核查机制 |
| 推理冲突 | 逻辑路径不一致 | 推理链比较、专家仲裁 | 保留推理过程 |
| 偏好冲突 | 价值判断差异 | 多数投票、加权决策 | 明确决策标准 |
共识算法的工程实现
- 简单多数投票:适用于离散选择
- 加权投票:考虑代理专长和历史表现
- Delphi方法:多轮迭代达成共识
- 拜占庭容错:应对恶意或错误代理
六、评估体系:如何衡量分解的效果
6.1 评估维度的系统设计
效果评估指标体系
| 评估维度 | 核心指标 | 测量方法 | 基准值 |
|---|---|---|---|
| 任务完成度 | 成功率、覆盖率 | 自动评测+人工审核 | >85% |
| 结果质量 | 准确性、相关性、完整性 | 多维度评分 | >4.0/5.0 |
| 系统效率 | 响应时间、吞吐量 | 性能监控 | <5s/任务 |
| 资源消耗 | Token使用、API调用 | 成本核算 | 降低30%+ |
TaskBench基准测试的启示
TaskBench通过17,331个样本的大规模评测,揭示了几个关键发现:
- 模型规模与分解能力正相关:GPT-4在所有指标上领先10%以上
- 代码训练提升工具使用能力:CodeLlama在工具预测上提升12.76%
- 领域复杂度影响显著:AI领域任务比日常任务困难20%
6.2 效率优化的实践路径
成本-效益分析框架
| 优化策略 | 成本降低 | 性能影响 | 实施难度 | 投资回报期 |
|---|---|---|---|---|
| 模型降级 | 70-90% | -5~10% | 低 | 1-2月 |
| 缓存复用 | 30-50% | +10~20% | 中 | 2-3月 |
| 批处理 | 20-40% | -20~50%延迟 | 低 | 1月 |
| 动态路由 | 40-60% | ±5% | 高 | 3-6月 |
性能优化的技术手段
-
智能缓存策略
- LRU缓存常见子任务结果
- 语义相似度匹配复用
- 增量更新而非完全重算
-
自适应分解深度
- 简单任务浅层分解
- 复杂任务深度分解
- 动态调整分解策略
-
并行化设计
- 识别独立子任务
- 异步执行框架
- 结果流式输出
七、案例研究:从理论到实践
7.1 企业级应用:亚马逊个性化网站生成
业务场景与挑战
亚马逊需要为不同用户群体生成个性化的营销页面,这涉及:
- 用户画像分析
- 内容个性化
- 视觉设计
- 前端开发
- 质量保证
任务分解方案
| 阶段 | 负责代理 | 输入 | 输出 | 使用模型 |
|---|---|---|---|---|
| 用户分析 | 个性化代理 | 用户数据 | 设计要求 | 中型LLM |
| 视觉设计 | 艺术代理 | 设计要求 | 图片素材 | 文生图模型 |
| 代码生成 | 开发代理 | 设计稿 | HTML/CSS/JS | 代码模型 |
| 质量检查 | QA代理 | 生成结果 | 测试报告 | 小型LLM |
效果与经验
- 成本降低70-90%:从GPT-4切换到专门化小模型组合
- 生成速度提升3倍:并行处理不同组件
- 个性化程度提高:专门模型更好理解垂直领域
关键经验:
- 不是所有任务都需要最强大的模型
- 专门化带来的性能提升超过协调开销
- 标准化接口是成功的关键
7.2 软件开发自动化:ChatDev的启示
从需求到代码的完整流程
ChatDev模拟了一个完整的软件公司:
| 角色 | 职责 | 交互方式 | 关键输出 |
|---|---|---|---|
| CEO | 项目规划 | 发起需求 | 项目章程 |
| CTO | 技术决策 | 技术评审 | 架构设计 |
| 程序员 | 代码实现 | 迭代开发 | 源代码 |
| 测试员 | 质量保证 | 反馈缺陷 | 测试报告 |
协作模式的设计智慧
- 明确的角色定义:每个代理都有清晰的职责边界
- 标准化的交付物:使用统一格式传递信息
- 迭代式的工作流:支持需求变更和持续改进
八、技术栈全景:工具选择指南
8.1 框架选择决策树
需求分析
├── 简单任务:单一LLM + 提示工程
├── 中等复杂度
│   ├── 对话驱动:AutoGen
│   └── 流程驱动:LangChain
└── 高度复杂
    ├── 企业级:Semantic Kernel
    └── 研究型:LangGraph
8.2 工具能力对比矩阵
| 特性/框架 | LangChain | LangGraph | AutoGen | CrewAI | Semantic Kernel |
|---|---|---|---|---|---|
| 学习曲线 | 中 | 陡 | 缓 | 缓 | 陡 |
| 灵活性 | 高 | 极高 | 中 | 中 | 高 |
| 生产就绪 | 是 | 是 | 部分 | 部分 | 是 |
| 生态系统 | 丰富 | 增长中 | 适中 | 有限 | 企业级 |
| 最佳场景 | 通用集成 | 复杂流程 | 研究原型 | 团队模拟 | 企业应用 |
8.3 技术选型的考量因素
业务因素
- 任务复杂度和类型
- 性能要求和SLA
- 预算限制
- 团队技术栈
技术因素
- 可扩展性需求
- 集成复杂度
- 维护成本
- 社区支持
九、未来展望:下一代任务分解系统
9.1 技术演进趋势
自适应分解系统
未来的系统将能够:
- 动态评估任务复杂度:自动决定分解深度
- 学习最优分解模式:从历史数据中总结经验
- 实时调整策略:根据执行反馈优化方案
认知架构的融合
| 发展方向 | 技术路径 | 预期效果 | 时间框架 |
|---|---|---|---|
| 神经符号融合 | 结合神经网络与符号推理 | 提升可解释性 | 2-3年 |
| 持续学习 | 在线学习与适应 | 个性化优化 | 3-5年 |
| 元认知能力 | 自我监控与调节 | 自主改进 | 5-10年 |
9.2 应用领域的拓展
跨模态任务分解
随着多模态模型的发展,任务分解将扩展到:
- 视觉理解与生成
- 音频处理与合成
- 视频分析与创作
- 跨模态推理
实体世界的延伸
- 机器人控制:将高层任务分解为具体动作
- 物联网协调:协调多个设备完成复杂任务
- 混合现实:在虚实结合的环境中分解任务
十、实践建议:如何构建自己的任务分解系统
10.1 起步阶段:从简单开始
第一步:理解你的任务
| 分析维度 | 关键问题 | 评估方法 |
|---|---|---|
| 复杂度 | 需要多少步骤? | 手动分解测试 |
| 依赖性 | 步骤间关系如何? | 绘制依赖图 |
| 可并行性 | 哪些可以同时做? | 识别独立子任务 |
| 质量要求 | 容错程度如何? | 定义验收标准 |
第二步:选择合适的方法
- 简单线性任务:使用CoT提示
- 需要探索的任务:采用ToT方法
- 明确可分解任务:应用DecomP
- 团队协作任务:构建多智能体系统
10.2 进阶阶段:优化和扩展
性能优化检查清单
- 识别性能瓶颈(响应时间、成本、质量)
- 实施缓存策略
- 优化提示词
- 调整模型选择
- 引入并行处理
- 建立监控体系
扩展能力的路径
- 横向扩展:增加可处理的任务类型
- 纵向深化:提升特定领域的专业度
- 系统集成:与现有业务系统对接
10.3 成熟阶段:持续演进
建立反馈循环
- 收集执行数据
- 分析失败案例
- 迭代优化策略
- 更新评估基准
培养团队能力
| 角色 | 核心技能 | 培养方式 |
|---|---|---|
| 提示工程师 | 提示设计、任务分析 | 实践+案例学习 |
| 系统架构师 | 多智能体设计、集成 | 架构评审+原型 |
| AI运维工程师 | 监控、优化、故障排查 | 工具培训+演练 |
十一、总结:认知的分布式未来
11.1 核心洞察
任务分解不仅仅是一种技术手段,更是一种认知范式的转变:
- 从单一到分布:认知能力分布在多个专门化的处理单元
- 从静态到动态:能力通过组合和协作动态构建
- 从黑盒到透明:分解使得推理过程可观察、可干预
11.2 方法论总结
设计原则
- 模块化:清晰的任务边界和接口
- 专门化:让合适的工具做合适的事
- 冗余性:关键环节的多重验证
- 渐进性:从简单到复杂逐步构建
实施要点
- 评估先行:明确目标和约束
- 迭代优化:小步快跑,持续改进
- 数据驱动:基于证据而非直觉
- 以人为本:技术服务于业务需求
11.3 展望未来
大语言模型的任务分解和汇总技术,正在从实验室走向生产环境。它不仅提升了AI系统的能力边界,更重要的是提供了一种新的思考方式:如何通过分工协作 实现智能涌现。
这种方法论的意义超越了技术本身。它让我们重新思考:
- 智能的本质是什么?
- 复杂问题如何被有效解决?
- 人机协作的最佳模式是什么?
随着技术的不断演进,任务分解系统将成为连接人类智慧与机器智能的关键桥梁,开启认知增强的新时代。
附录:专业术语表
ADaPT (Decompose-and-Plan on Demand):按需分解和规划,一种动态任务分解框架,根据任务复杂度自适应调整分解深度
Agent(智能体):能够感知环境并采取行动以实现特定目标的自主计算实体
Attention Mechanism(注意力机制):Transformer架构的核心组件,使模型能够关注输入序列的不同部分
Beam Search(束搜索):一种启发式搜索算法,在每步保留k个最优候选,平衡搜索质量与计算效率
Chain-of-Thought (CoT)(思维链):通过生成中间推理步骤来解决复杂问题的提示技术
Cognitive Load(认知负荷):处理信息时施加在工作记忆上的心理努力量
Context Window(上下文窗口):大语言模型在单次推理中能处理的最大文本长度
Decomposed Prompting (DecomP)(分解式提示):将复杂任务分解为子任务,由专门处理器分别处理的方法
Distributed Cognition(分布式认知):认知过程分布在个体、工具和环境之间的理论框架
Embedding(嵌入):将离散对象映射到连续向量空间的数值表示方法
F1 Score(F1分数):精确率和召回率的调和平均值,综合评估分类性能
Few-shot Learning(少样本学习):通过少量示例使模型学会新任务的方法
General Problem Solver (GPS)(通用问题解决器):早期AI系统,使用手段-目标分析解决问题
Hallucination(幻觉):AI模型生成看似合理但实际错误或虚构的信息
Intrinsic Load(内在负荷):任务本身固有复杂性造成的认知负担
LangChain:用于构建LLM应用的开源框架,提供链式调用和工具集成
LangGraph:LangChain的扩展,支持构建有状态的多智能体工作流
Least-to-Most Prompting(最小到最大提示):从简单子问题逐步构建到复杂问题解决方案的方法
Miller's Magic Number(米勒魔法数字):人类工作记忆容量约为7±2个信息单元的认知科学发现
Multi-Agent System(多智能体系统):多个智能体协作完成任务的计算系统
Node F1 Score(节点F1分数):评估任务分解中正确识别子任务或工具的指标
Prompt Engineering(提示工程):设计和优化输入提示以获得期望输出的技术
ROUGE Score:评估文本生成质量的指标集,通过比较生成文本与参考文本的重叠度
Semantic Kernel:微软的开源SDK,用于将AI集成到应用程序中
Skeleton-of-Thought (SoT)(骨架思维):先生成答案骨架再并行扩展细节的生成策略
Token(令牌):文本处理的基本单位,可以是单词、子词或字符
Tree-of-Thoughts (ToT)(思维树):通过树结构探索多个推理路径的问题解决方法
Working Memory(工作记忆):临时存储和处理信息的认知系统,容量有限
Zero-shot Learning(零样本学习):模型在没有特定任务示例的情况下执行新任务的能力