本文为个人学习笔记整理,仅供交流参考,非专业教学资料,内容请自行甄别。
文章目录
概述
ETL是RAG知识库的核心特性之一,包含了抽取,转换,加载三部分,其主要作用是对用户提供的知识库文档,进行处理,是存入向量数据库的前置操作。
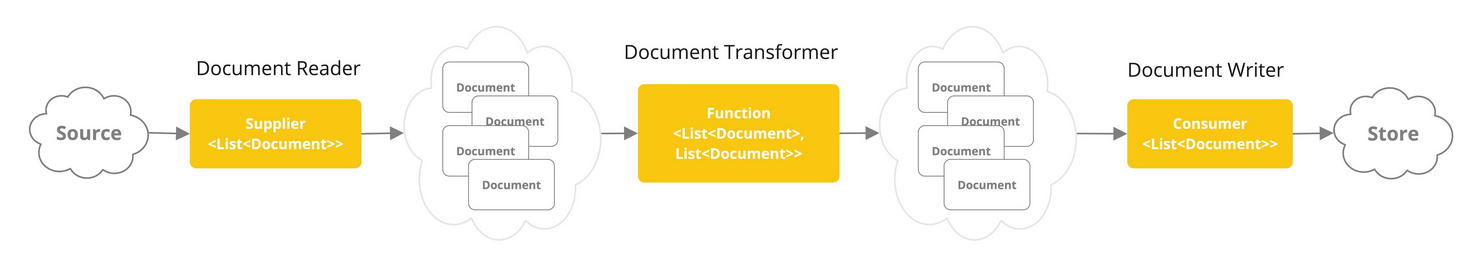
文档在在Spring AI中的体现是document对象。不仅是文本,还包含其他类型的数据,以及元信息。ETL管道有三个主要组成部分:
- DocumentReader实现Supplier<List>,用于文档抽取。
- DocumentTransformer实现Function<List, List>,用于文档转换。
- DocumentWriter实现Consumer<List>,用于文档加载。
一、DocumentReader
DocumentReader是Spring AI提供的一个接口,它有一些默认的实现,解析不同类型的文档,如MarkdownDocumentReader,解析md格式的文档,JsonReader,解析json格式的文档。
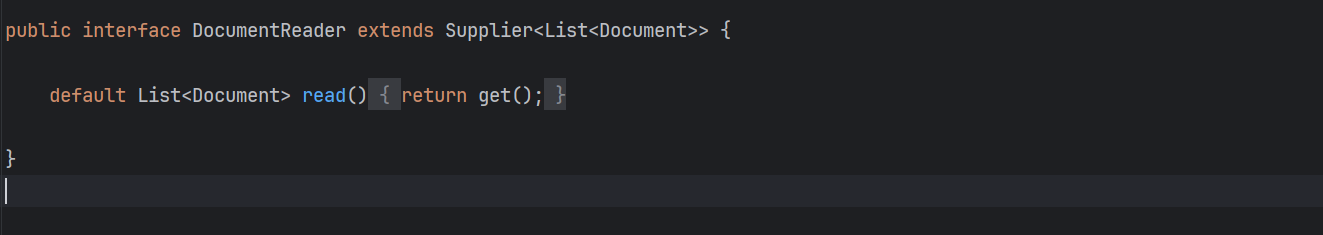
它们的不同点在于各自重写了get方法,解析自己类型的文档,其中多是利用第三方的库进行解析:
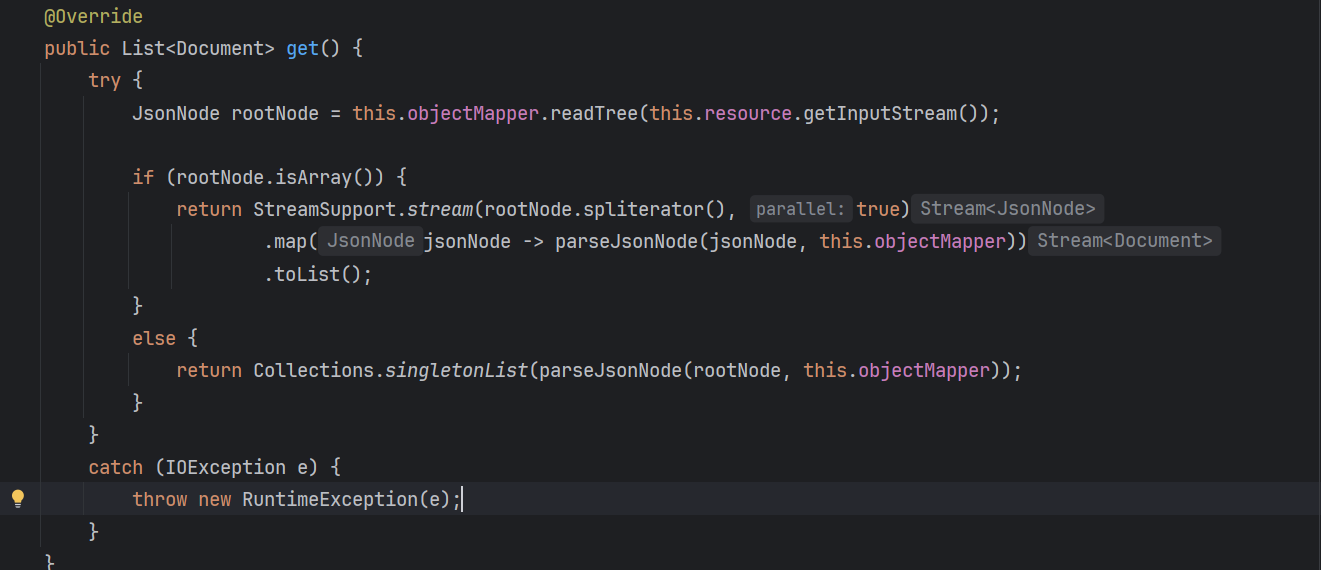
如果需要自定义解析器,则自己实现DocumentReader接口,重写其中的get方法即可。
二、DocumentTransformer
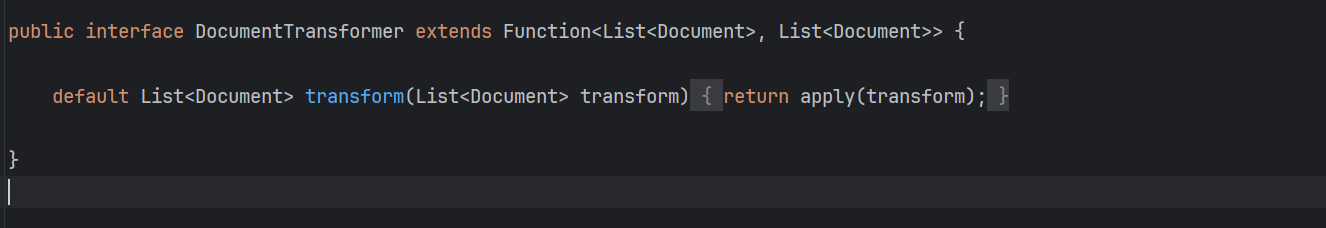
DocumentTransformer接口,用于对文档进行转换。文档转换的含义是,将一个完整的文档,按照一定的规则进行拆分,成为便于检索的知识碎片。
2.1、splitText
DocumentTransformer接口也有默认的实现,例如文本分片,TextSplitter是一个抽象类,真正定义的文本分片的规则,在于子类对splitText方法的实现。
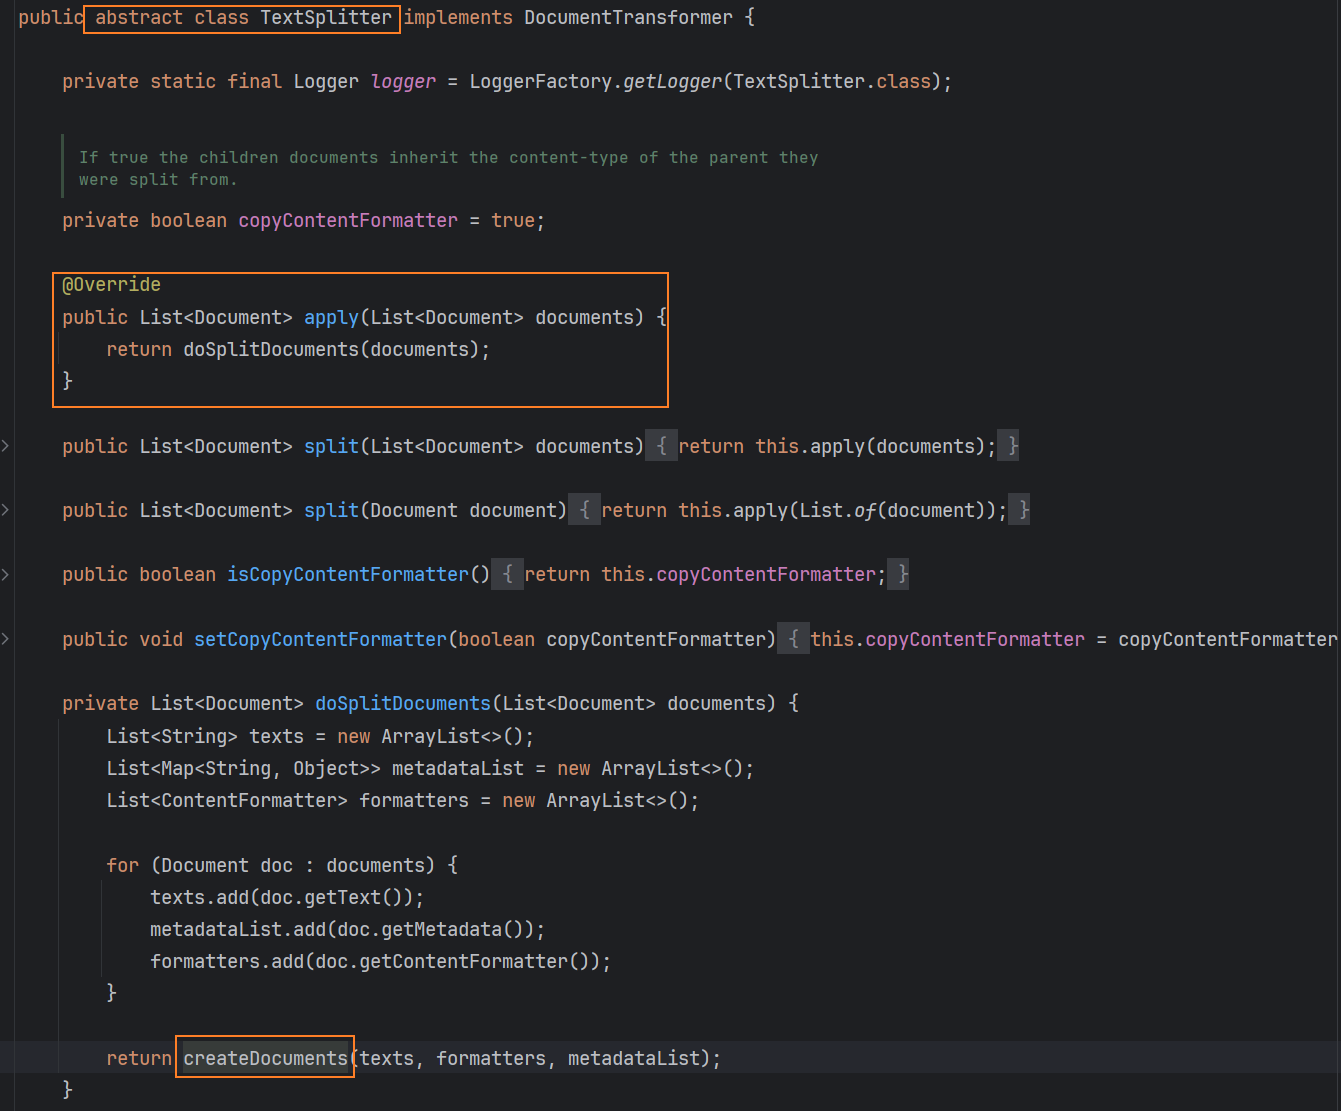
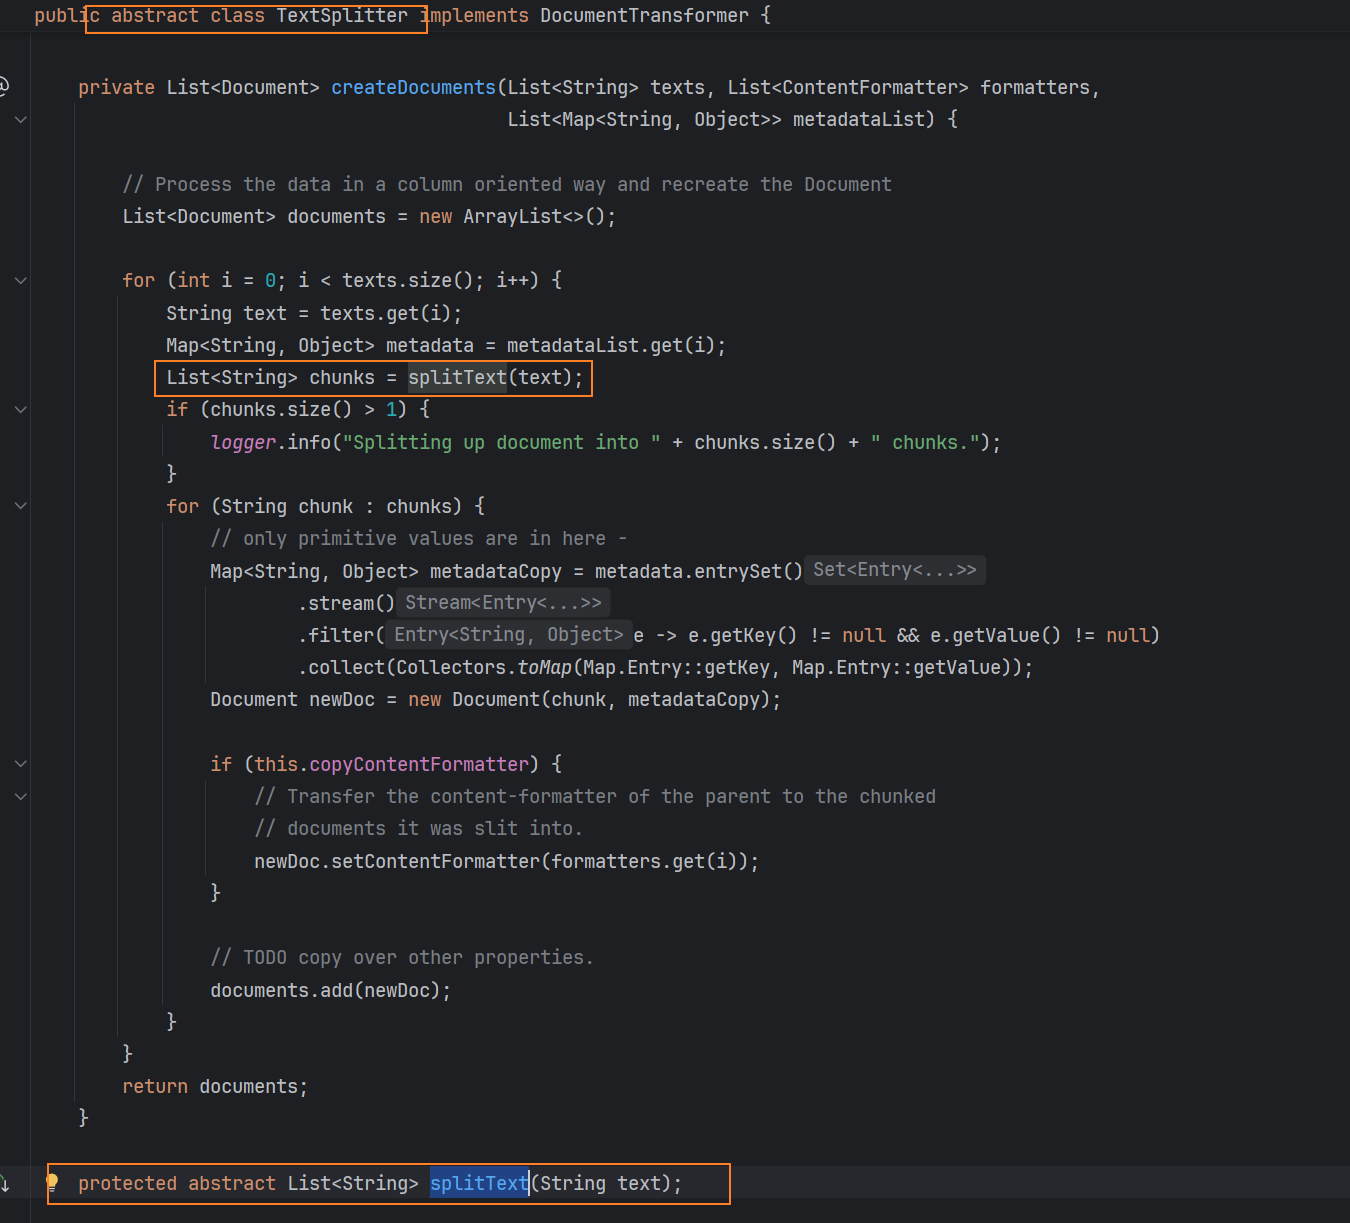
其中一个很经典的实现是TokenTextSplitter,根据token计数将文本分割成块,TokenTextSplitter提供两种构造函数选项:
- TokenTextSplitter():默认的无参构造。
- 带参数的构造:
- defaultChunkSize:token中每个文本块的目标大小(默认值:800)。
- minChunkSizeChars:token中每个文本块的最小大小(默认值:350)。
- minChunkLengthToEmbed:包含一个块的最小长度(默认值:5)。
- maxNumChunks:从文本中生成的最大块数(默认值:10000)。
- keepSeparator:是否在块中保留分隔符(如新行)(默认值:true)。
java
@Component
class MyTokenTextSplitter {

    public List<Document> splitDocuments(List<Document> documents) {
        TokenTextSplitter splitter = new TokenTextSplitter();
        return splitter.apply(documents);
    }

    public List<Document> splitCustomized(List<Document> documents) {
        TokenTextSplitter splitter = new TokenTextSplitter(1000, 400, 10, 5000, true);
        return splitter.apply(documents);
    }
}
当然这种根据token长度切分的方式,过于简单粗暴,断句缺乏准确性,对后续的查询精确度有影响。实际开发中是不推荐使用的。
2.2、元数据增强器
无论是哪一种元数据增强器,底层都是再次调用大模型去实现的。
2.2.1、KeywordMetadataEnricher
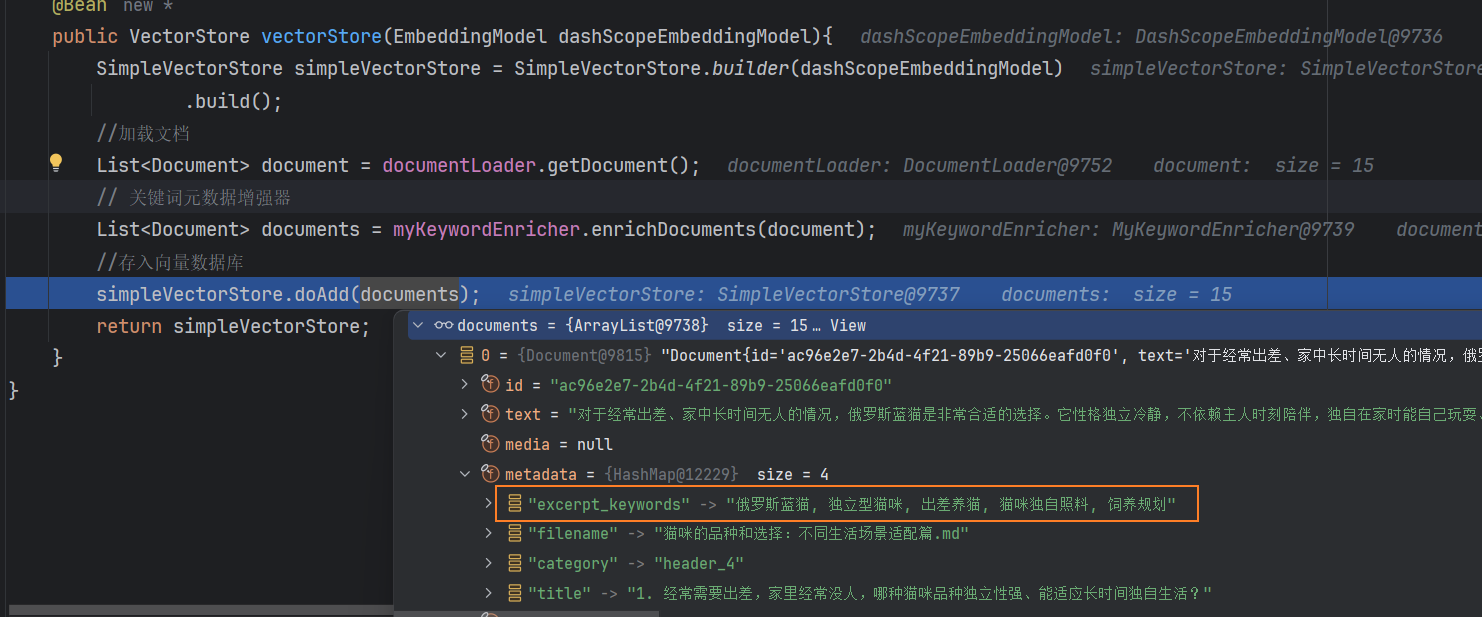
还有一种转换的形式是利用元数据增强器,官方提供了两种:KeywordMetadataEnricher(关键词元数据增强器),SummaryMetadataEnricher(摘要元数据增强器)。前者是利用AI模型,从文档内容中提取关键词并添加它们作为元数据,类似于打标签:
java
/**
 * 关键词元数据增强器
 */
@Component
public class MyKeywordEnricher {

    private final ChatModel chatModel;

    MyKeywordEnricher(ChatModel chatModel) {
        this.chatModel = chatModel;
    }

    List<Document> enrichDocuments(List<Document> documents) {
    		//使用默认模板并提取指定数量的关键词。
        KeywordMetadataEnricher keywordMetadataEnricher = new KeywordMetadataEnricher(chatModel, 5);
        return keywordMetadataEnricher.apply(documents);
    }
}
它的使用时机是在加载文档后,存入向量数据库前:
java
    @Bean
    public VectorStore vectorStore(EmbeddingModel dashScopeEmbeddingModel){
        SimpleVectorStore simpleVectorStore = SimpleVectorStore.builder(dashScopeEmbeddingModel)
                .build();
        //加载文档
        List<Document> document = documentLoader.getDocument();
        // 关键词元数据增强器
        List<Document> documents = myKeywordEnricher.enrichDocuments(document);
        //存入向量数据库
        simpleVectorStore.doAdd(documents);
        return simpleVectorStore;
    }
生成的关键字会添加到文档的元数据中:
2.2.2、SummaryMetadataEnricher
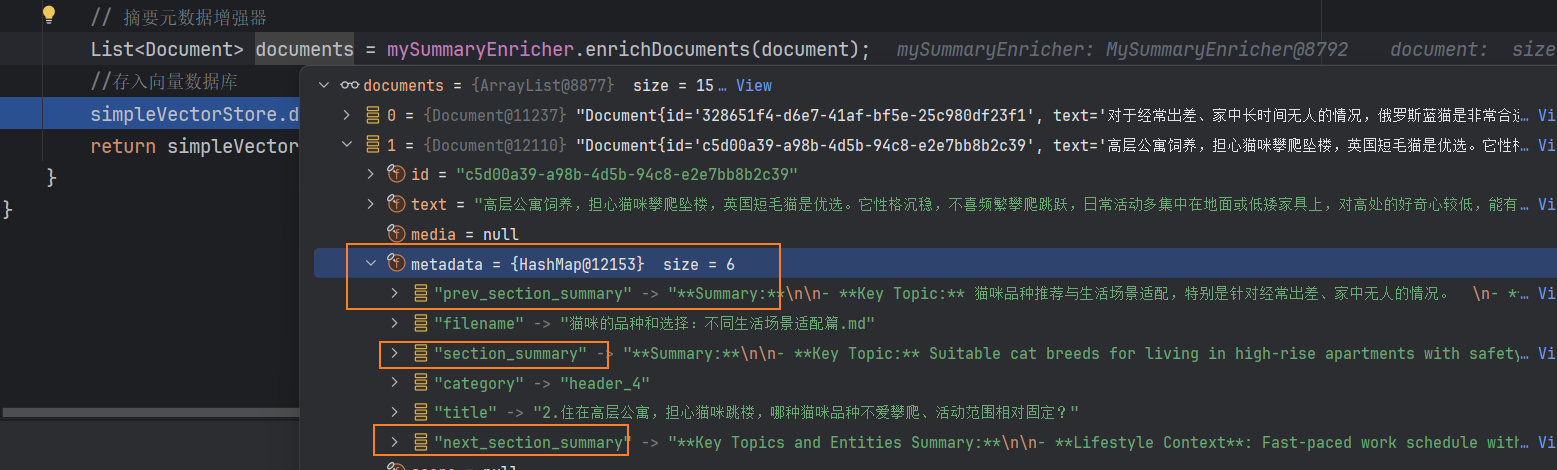
是一种总结的形式,摘要可以结合上下文,减少了单篇文档的局限性,在构造SummaryMetadataEnricher时,可以指定三个枚举:
- section_summary当前文件摘要。
- prev_section_summary上一份文件摘要。
- next_section_summary下一份文件摘要。
java
/**
 * 摘要元数据增强器
 */
@Component
public class MySummaryEnricher {

    private final ChatModel chatModel;

    MySummaryEnricher(ChatModel chatModel) {
        this.chatModel = chatModel;
    }

    List<Document> enrichDocuments(List<Document> documents) {
        //summaryTypes列出SummaryType枚举值表示要生成的摘要(PREVIOUS、CURRENT、NEXT)。
        SummaryMetadataEnricher summaryMetadataEnricher = new SummaryMetadataEnricher(chatModel,
                List.of(SummaryMetadataEnricher.SummaryType.PREVIOUS, SummaryMetadataEnricher.SummaryType.CURRENT, SummaryMetadataEnricher.SummaryType.NEXT));
        return summaryMetadataEnricher.apply(documents);
    }

}
java
    @Bean
    public VectorStore vectorStore(EmbeddingModel dashScopeEmbeddingModel){
        SimpleVectorStore simpleVectorStore = SimpleVectorStore.builder(dashScopeEmbeddingModel)
                .build();
        //加载文档
        List<Document> document = documentLoader.getDocument();
        // 摘要元数据增强器
        List<Document> documents = mySummaryEnricher.enrichDocuments(document);
        //存入向量数据库
        simpleVectorStore.doAdd(documents);
        return simpleVectorStore;
    }
该种增强,实测调用时间较长。最后还有一个内容格式化工具,官方文档只是一笔带过。
三、DocumentWriter
DocumentWriter则是提供了将上述处理后的文档,写入的规范。
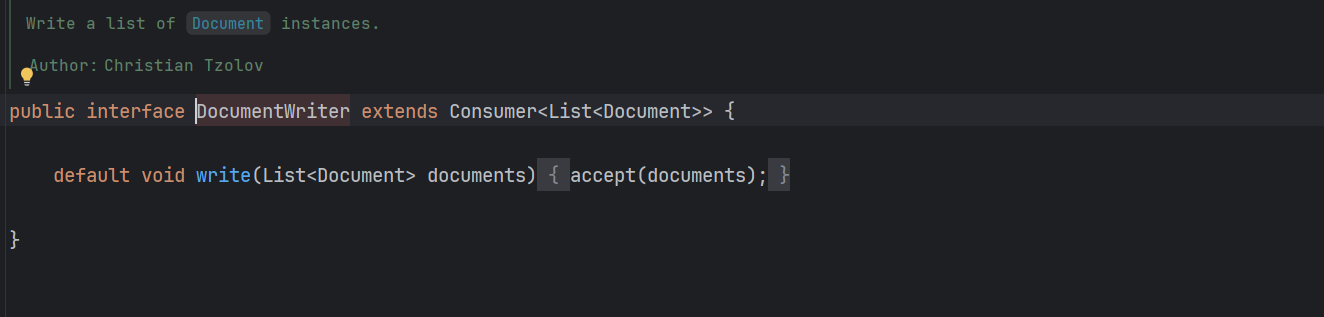
其官方实现有VectorStore(写入向量数据库),FileDocumentWriter(直接写入文件)
四、ETL优化
AI回答能力的上限,取决于提供的知识库文档的质量。所以ETL是RAG 调优最核心的环节。文档的优化策略:
- 内容结构化,标题,内容分明,但是减少层级嵌套
- 内容规范化,语言同一,表述统一,尽量避免水印,图片,表格。
- 格式标准化,优先使用md,doc等便于解析的格式。如果文档包含了图片,那么图片的链接需要是公网地址,不能是自己本地的图片。
4.1、文档切片优化
文档切片,是在DocumentTransformer这一步完成的工作,切片太短会导致语义缺失,切片过长引入无关信息,所以选择合适的切片策略非常重要,根据不同类型的文档,有不同的切分策略:
- 文档类型:专业类的文献,增加长度有利于保存完整的上下文信息。
- 社交类的帖子,缩短长度能更准确保存语义。
最佳的文档切片策略: **不要用固定长度的分词器。 使用AI分块 + 人工二次校验。**在使用云服务时,就可以指定智能切分的策略,使用此策略,大模型会根据文档内容的语义相关性,自适应地进行段落的拆分,而不是固定长度的拆分,在将文档导入知识库之前,需要再次人工核对编辑。
在这里插入代码片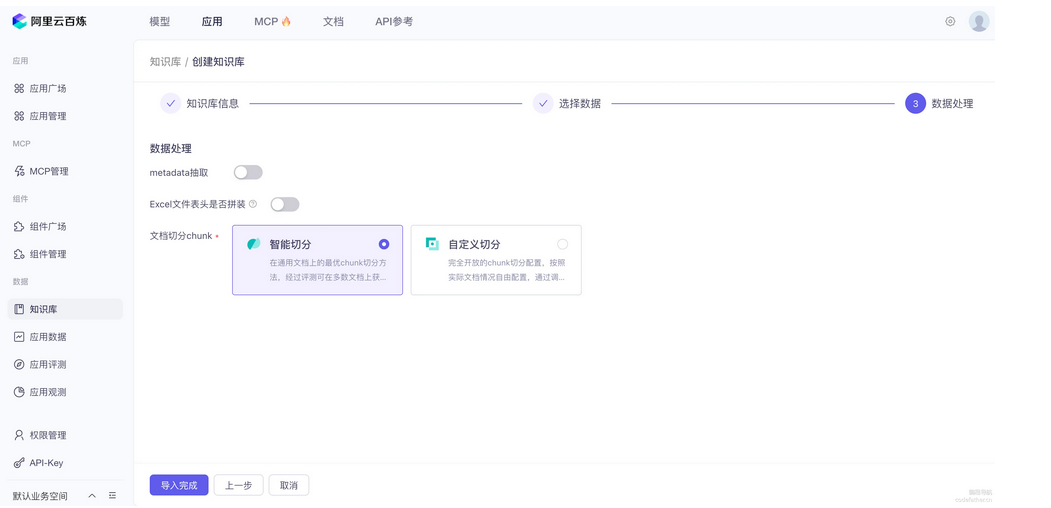
4.2、元信息标注
为文档添加元信息,形成标签,便于后续向量数据库搜索。可以手动添加元信息,在创建Document实例时手动指定:
java
documents.add(new Document(
    "案例编号:LR-2023-001\n" +
    "项目概述:180平米大平层现代简约风格客厅改造\n" +
    "设计要点:\n" +
    "1. 采用5.2米挑高的落地窗,最大化自然采光\n" +
    "2. 主色调:云雾白(哑光,NCS S0500-N)配合莫兰迪灰\n" +
    "3. 家具选择:意大利B&B品牌真皮沙发,北欧白橡木茶几\n" +
    "空间效果:通透大气,适合商务接待和家庭日常起居",
    Map.of(
        "type", "interior",    // 文档类型
        "year", "2025",        // 年份
        "month", "05",         // 月份
        "style", "modern",      // 装修风格
))); 也可以利用documentReader解析时指定规则,进行添加,例如从文件名中切割:
java
// 提取文档倒数第 3 和第 2 个字作为标签
String status = fileName.substring(fileName.length() - 6, fileName.length() - 4);
MarkdownDocumentReaderConfig config = MarkdownDocumentReaderConfig.builder()
        .withHorizontalRuleCreateDocument(true)
        .withIncludeCodeBlock(false)
        .withIncludeBlockquote(false)
        .withAdditionalMetadata("filename", fileName)
        .withAdditionalMetadata("status", status)
        .build();
还可以使用Spring AI 提供的keyword元信息增强器,这一点在2.2、元数据增强器中提及到。